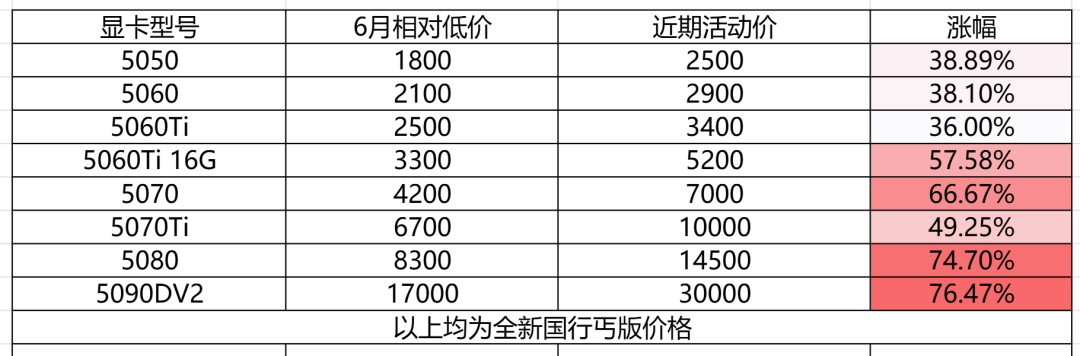
显卡最近涨到让人麻木。这几天的行情:5060 Ti 16G爬到3609元,5090D 32GB直接挂到49999元,全是历史新高。英伟达副总裁都松口承认,消费级显卡短缺已经"超出我们的控制范围"。知乎
就在涨价潮里,Reddit上有个帖子火了,今天知乎也开始刷屏:有人用一张16GB显存的A卡,跑起了27B参数的大模型,生成速度42.7 token/s。
什么概念?前不久圈里的共识还是,Q4量化的Qwen3.8-27B要24GB显存起步。16GB卡只配跑阉割版的小模型,现在门槛直接被砍半。知乎知乎哔哩哔哩哔哩哔哩
55GB的模型,怎么塞进16GB的卡?
两招。
第一招,量化。Qwen3.8-27B原始体积约55GB,用IQ4_XS压到4bit,只剩十五六GB,正好塞进16GB卡。代价是模型"智商"打个折,但按帖主的实测,干标合同条款这类日常活,4bit和8bit的差距,大概率比你prompt写得好坏的差距还小。知乎
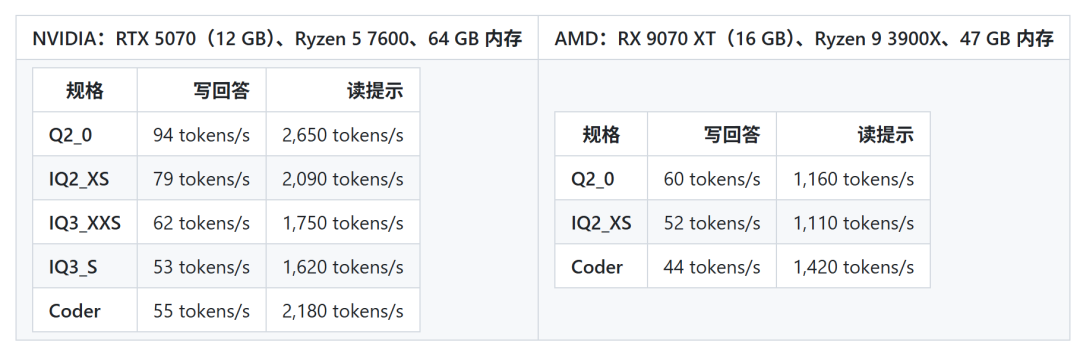
第二招,卸载。推理时吃显存的不只权重,还有上下文越长越大的KV缓存。开源工具KVMem的思路是把KV缓存整个扔进系统内存:5060 Ti搭配它能跑30~40 token/s,256K上下文,10月中旬的v0.18版本又提速68%,冲到53 token/s。N卡20系到50系都支持,A卡的RX 7900系、9070系也有ROCm版。哔哩哔哩哔哩哔哩
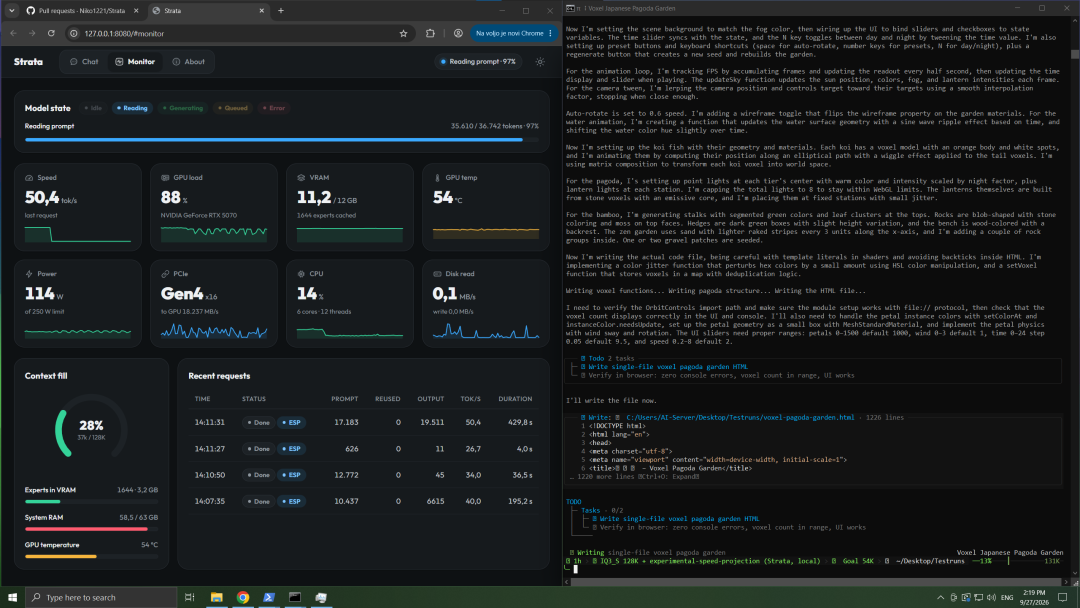
那位Reddit老哥的配置就是:16GB的A卡+24GB DDR5内存,上下文开到26万,生成42.7 token/s。这么一套五六千块。而经典的"四张3090"方案,二手一张还要三四千,加主板电源散热,一两万跑不掉——差价三倍。知乎
那还抢什么24GB的卡?
先冷静。多花的显存钱,买的是"跑得爽":70B整个塞进去、不用量化不用卸载、长上下文不掉速。但"跑得爽"和"够用"是两码事。
帖子里有句话很扎心:大部分人判断"能不能跑",看的是显卡型号,不是自己拿它干什么。正确顺序是先想清楚用途,再倒推显存。先买卡再找用途,才是大多数人踩的坑。
本地部署值不值,就两条标尺:数据不能出门的(合同、病历、内部代码),必须本地;调用量大到API账单几个月就追平硬件钱的,本地划算。两条都不沾,老老实实用云端——你折腾环境、修驱动的时间,比省下的API费贵。那位老哥为了跑通,最后是让AI帮他SSH进机器修PCIe的bug,本地跑真正的成本,是折腾。知乎
所以回到眼前的涨价:16GB的卡确实也不便宜了,但至少,玩本地大模型不用再交"显存税"。一张16GB卡、内存给够、4bit量化加KVMem,日常干活的27B,够用了。

24GB的执念,想清楚用途再掏钱。