



















 深耕数码兴趣领域






21
31
一台 128G 统一内存能跑本地大模型的英伟达笔记本,你喜欢么?
2026-10-23 08:17:35
0点赞
0收藏
0评论
从Tegra到 N1X 老黄的笔记本电脑复仇记
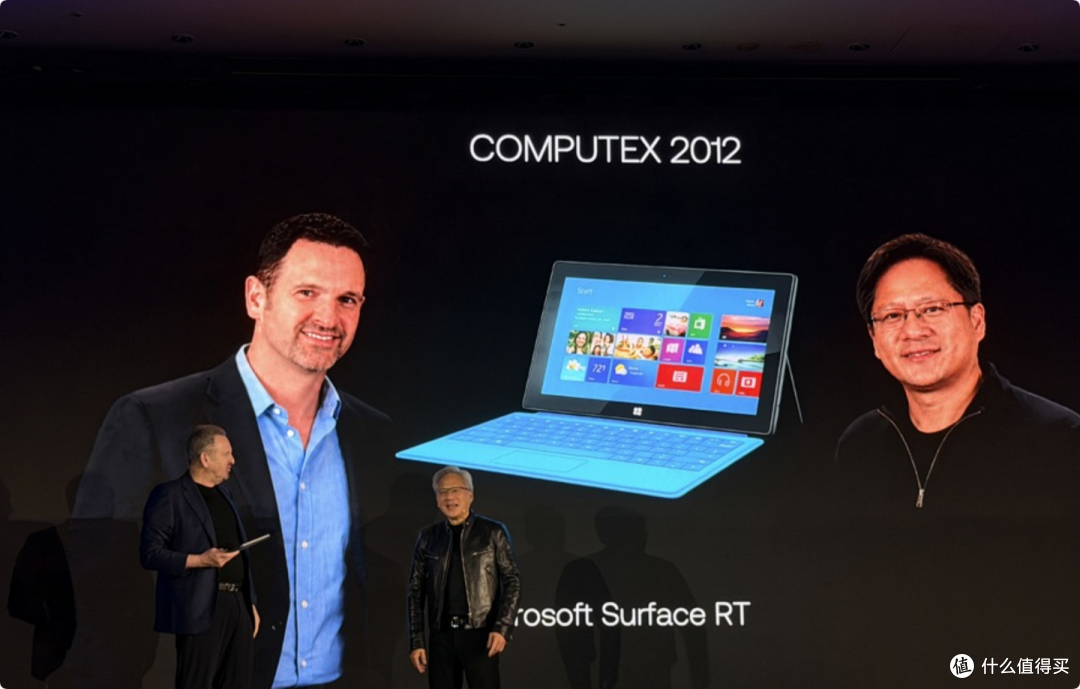
在 COMPUTEX 2026 大会上,现任 Arm 首席执行官雷内·哈斯 (Rene Haas) 邀请英伟达创始人兼首席执行官黄仁勋登台,并在演讲尾声出人意料地掏出一份极具历史意义的礼物——一台初代微软 Surface RT。
虽然台上这出互动显然经过事先编排,但从老黄接过机器时那抹略显微妙的表情里,依然能读出几分五味杂陈。因为这台 Surface RT 肚子里搭载的 Tegra 3,算得上是英伟达过去二十年无数次技术豪赌中,极少数没能按预期剧本走向辉煌的产品,至少在当年它最想攻克的手机与 PC 战场上,它走得并不顺遂。
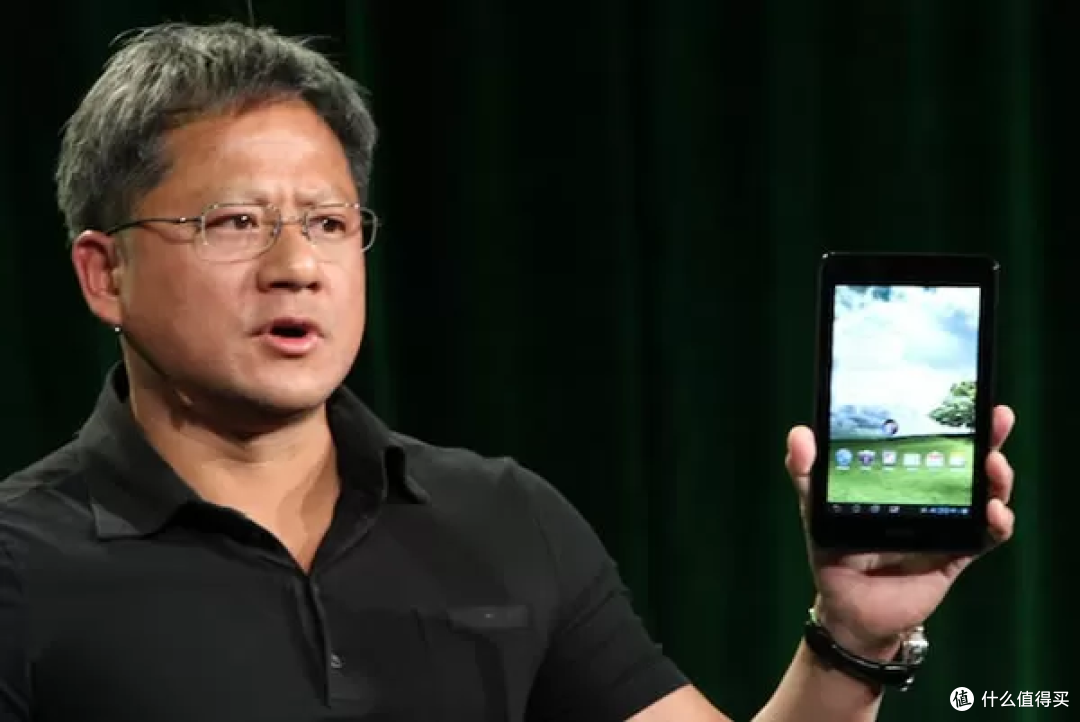
把时钟拨回 2010 年代。在那个还没有 AI 概念的岁月里,心高气傲的英伟达显然不甘心只做一家单纯给玩家造游戏显卡的公司,而是试图带着 Tegra 系列杀入移动处理器领域,一并拿下一统手机与笔记本的入场券。但事与愿违:当年 Tegra 作为手机处理器缺乏基带整合,作为笔记本处理器,Tegra 3 虽然是首款 4 核心的 Arm 移动处理器,但其核心的绝对性能相比 x86 还是过于孱弱,但更要命的是当年微软推出的 Windows RT 做出了一个极其冒进的决定,就是完全不支持任何存量 x86 应用,这样使得 Tegra 3 作为 PC 处理器几乎完全没有生态可言。
没有软件生态护航,再有前瞻性的硬件也只能沦为孤岛。当然,如果我们用今天的上帝视角去马后炮,Tegra 这个 IP 后续发展还是在智能车机和任天堂 Switch 游戏机上大放异彩,但平心而论在进军主流 移动端和 PC 这件事上,当年的 Tegra 也绝非一款达成了黄仁勋最初野望的成功产品。
在半导体行业里,最昂贵的学费从来不是流片失败,而是在错误的生态里替别人趟雷。 在 Windows on ARM 这条布满荆棘的赛道上,英伟达是第一个趟雷的先行者,但绝不是最后一个,因为很快就有后来者前仆后继地跳进了同一个坑里。
9 年前,当高通签下微软的排他性独占协议,试图把手机里的骁龙芯片直接塞进笔记本外壳时,整个 PC 圈都在看笑话:32 位转译卡成幻灯片,打开游戏满屏贴图报错,没有人相信 ARM 架构能跑得动真正的桌面级 Windows。
两年前,骁龙 X Elite 顶着“AI PC 救世主”的名号又再次高调进场,结果一头撞上游戏内核级反作弊驱动和 CUDA 生态这两堵铁墙,当场撞了个满头包。那一刻,哪怕是最头铁的 ARM 粉丝也只能认命:合着 WoA 折腾了这么多年,也只是台用来开开 Chrome、敲敲 Office 的豪华大号打字机。
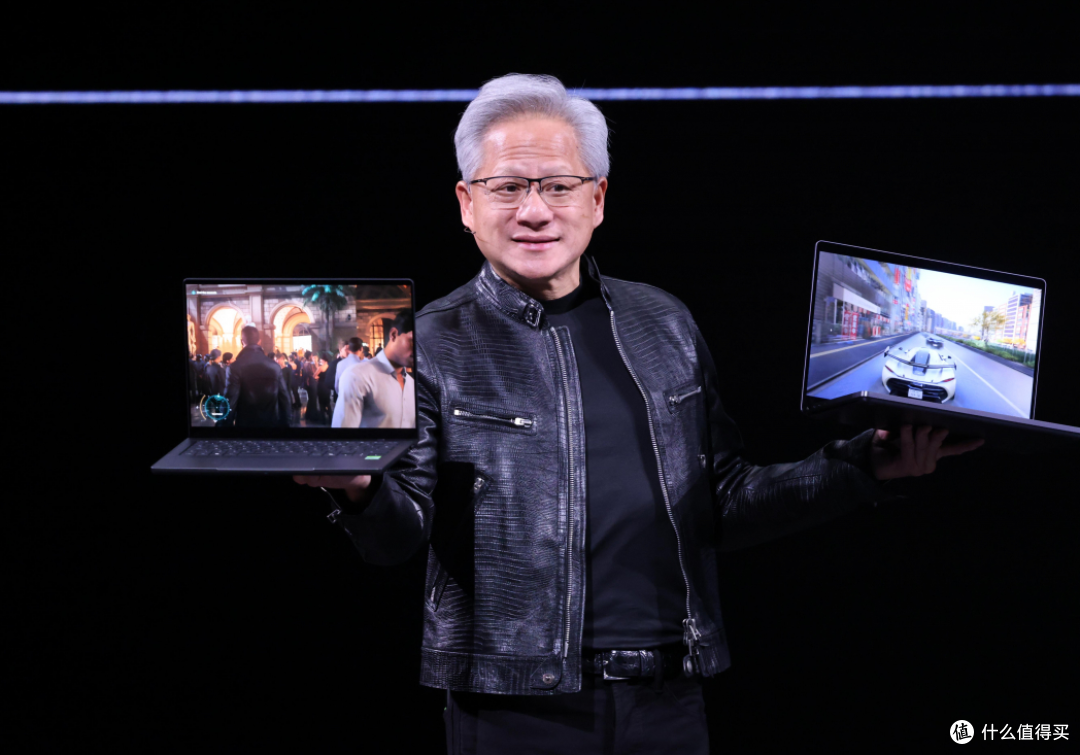
芯片场上的恩怨,从来都是在哪跌倒,就在哪把场子找回来。如今,老黄终于带着 RTX Spark 重新杀回了 Windows on ARM 笔记本。从当年 Tegra 的折戟试水,到今天 N1X 的掀翻牌桌,这十余年里高通始终没能填上的生态天坑,对于 RTX Spark 而言,曾经绊倒前辈们的那些“深坑”到底是深是浅?英伟达又是否能够真正将其成功化解?在接下来的文章里,我们将抛开首发评测那些千篇一律的单纯跑分报数,为您拆解这台“破壁新物种”背后的真实算盘。
测试平台和规格参数
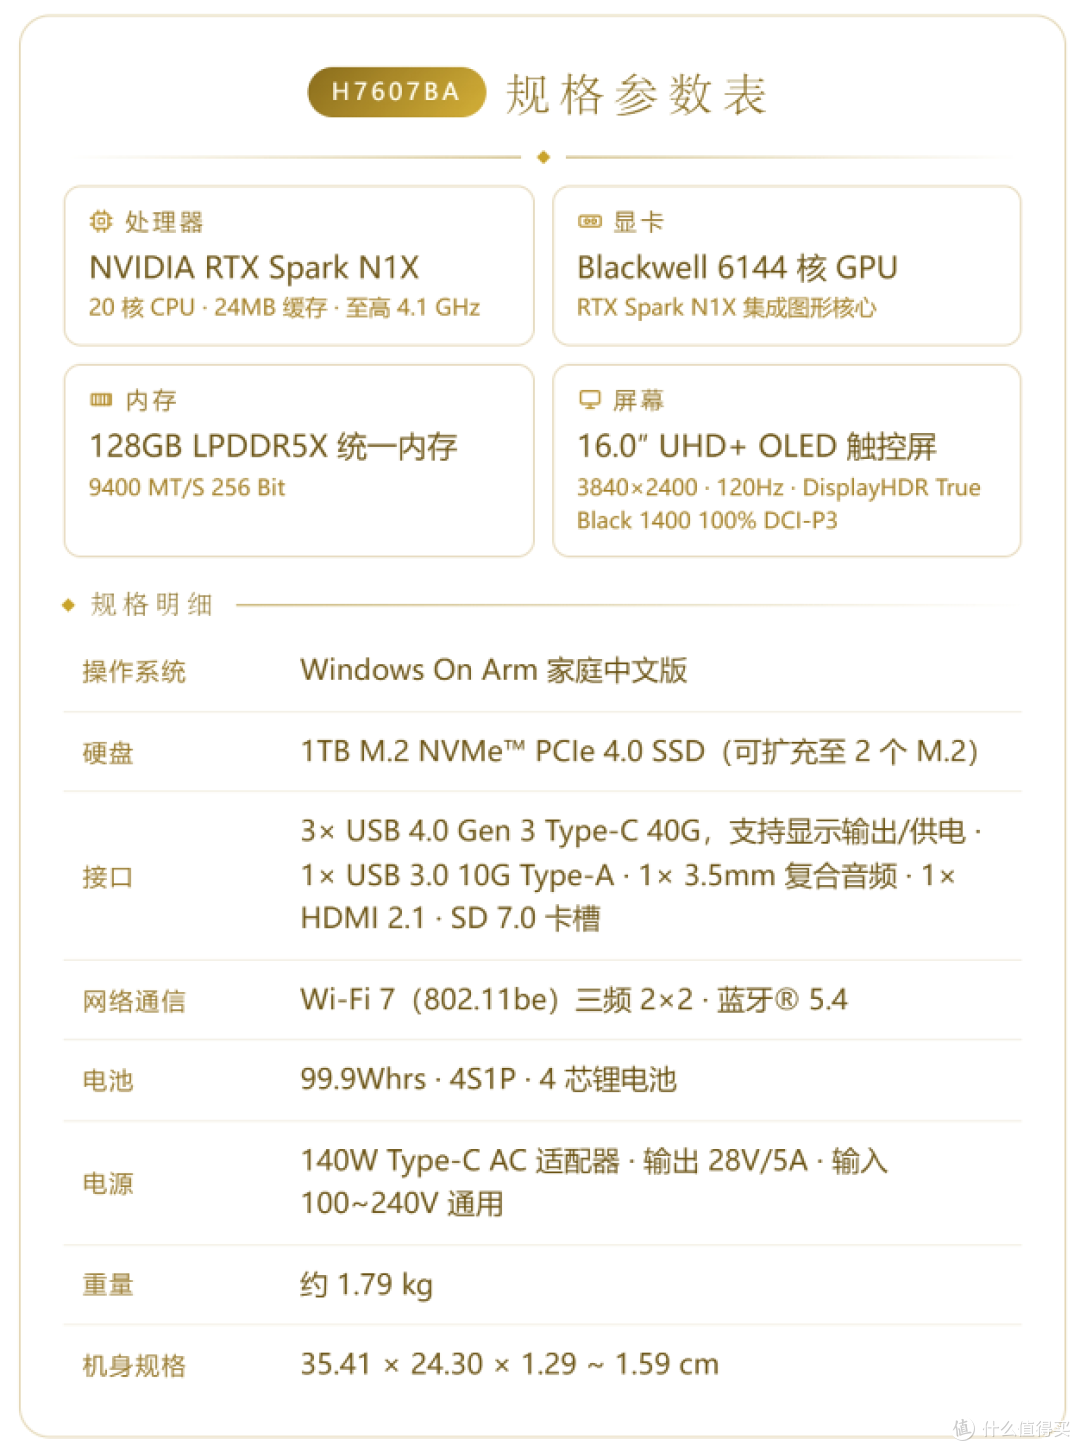
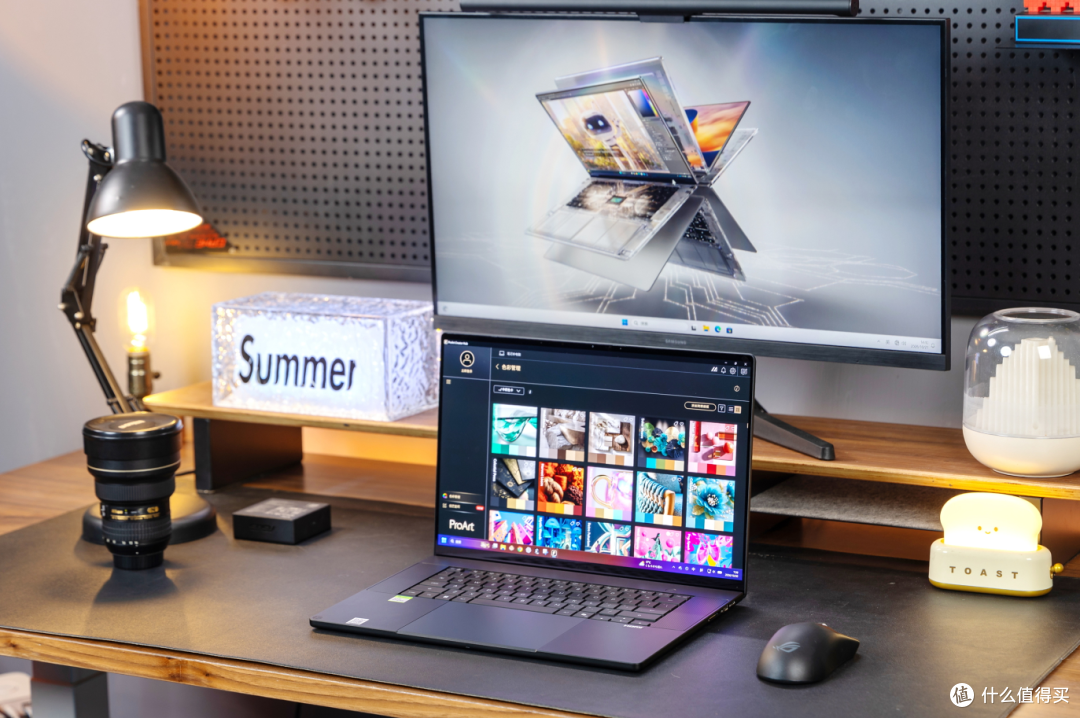
本次RTX Spark测试平台为华硕 ProArt 创16 RTX Spark 满配6144 CUDA核心版本+128 GB统一内存+1TB SSD,屏幕为16英寸3840 x 2400 120 Hz OLED,在没有说明情况下,均在手动性能模式+200 nit屏幕亮度进行测试。下面测试我们主要聚焦RTX Spark处理器部分,而对于华硕 ProArt 创16 RTX Spark的内容则放在本文的最后。
RTX Spark 处理器架构
官方在介绍 RTX Spark 时放出的 N1X 芯片渲染图,其实与更早发布的 DGX Spark 如出一辙。但明眼人一看便知,那张官图更接近一张概念展示图,与真实的芯片物理布局还是有着一些的出入。为了看清这颗芯片的真正面貌,我们不妨借用好友 Kurnal 拍摄的 GB10 Dieshot,用更直观的方式简析下 RTX Spark 体内这颗 N1X 处理器的整体架构。
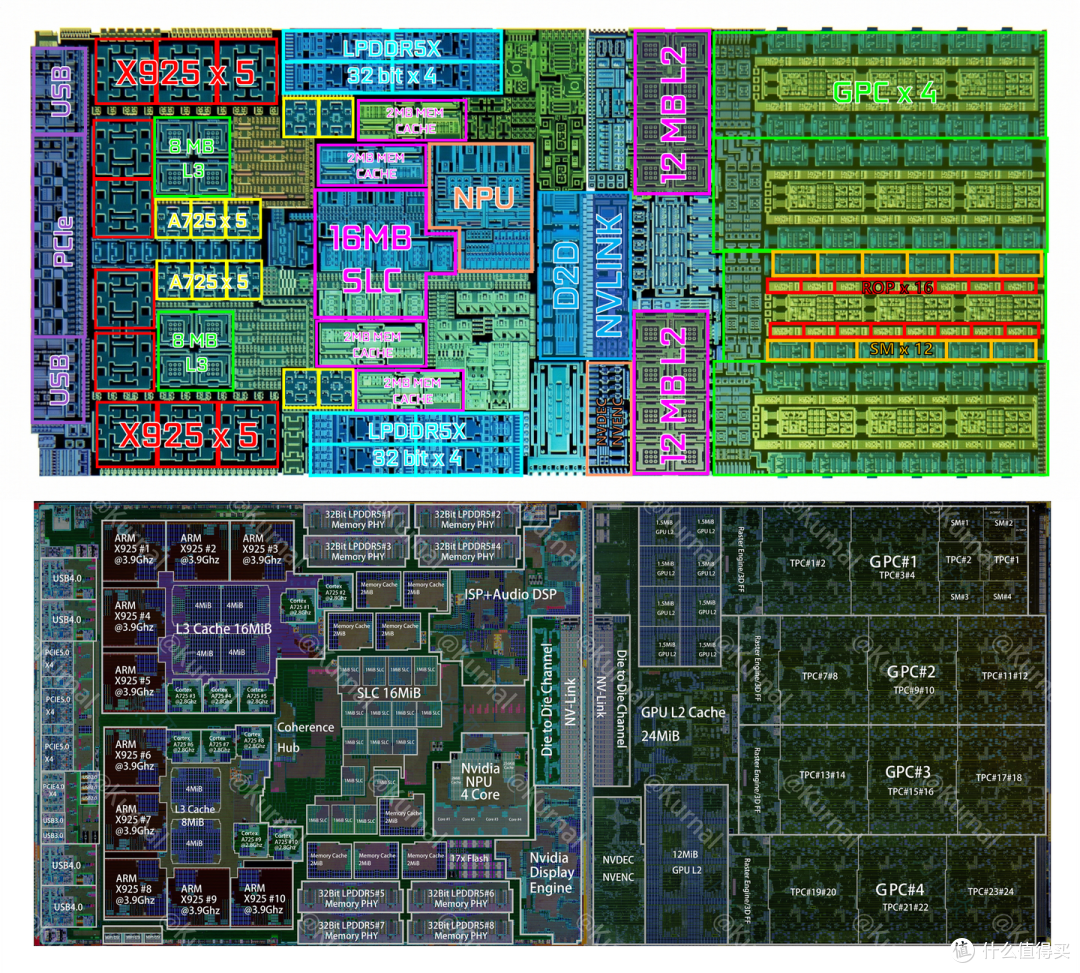
N1X 并不是一整块 Die,而是由 英伟达设计的 GPU 部分和联发科设计的 CPU 部分组合而成。其整体使用的 CoWoS-R 高级封装,CPU 和 GPU 之间通过 Vera Rubin 下放的 NVLink-C2C 方式互联。其 C2C 之间的带宽是 600 GB/S。当然这个 600 GB/S 是上下行总速度,而单向带宽为 300 GB/S。
内存方面,RTX Spark 和 DGX Spark 一样走容量优先路线,配备 128GB LPDDR5X 统一内存,容量是 RTX 5070 12GB 的 10 倍有余。同时从任务管理器可以看到,RTX Spark 的内存速率从 DGX Spark 的 8533 MT/s 提升到了 9400 MT/s,使得内存总带宽从 273 提升到了 300 GB/s。
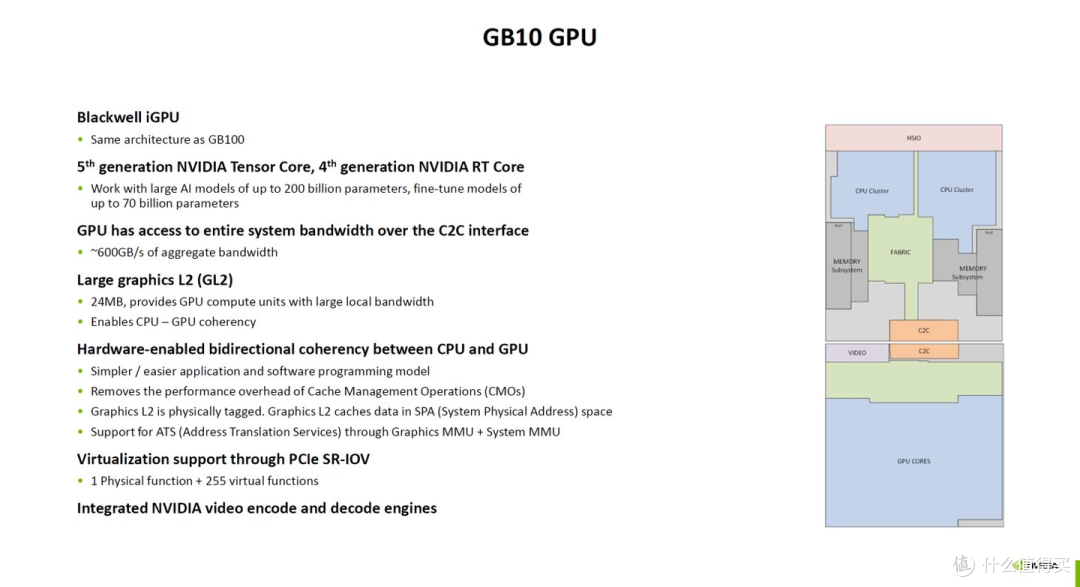
但需要注意的是 8 组 32 bit LPDDR5X 的内存控制器是在 CPU 上面,就是说 GPU 要访问内存数据需要通过 CPU 和 GPU 之间 NVLink-C2C。此时我们发现 256 bit 的 9400 MT/S LPDDR5X 的 300 GB/S 带宽刚好和 NVLink-C2C 的单向 300 GB/S 带宽完全一致,这样的组合既没有一丝瓶颈,又没有一丝浪费,可谓完美。
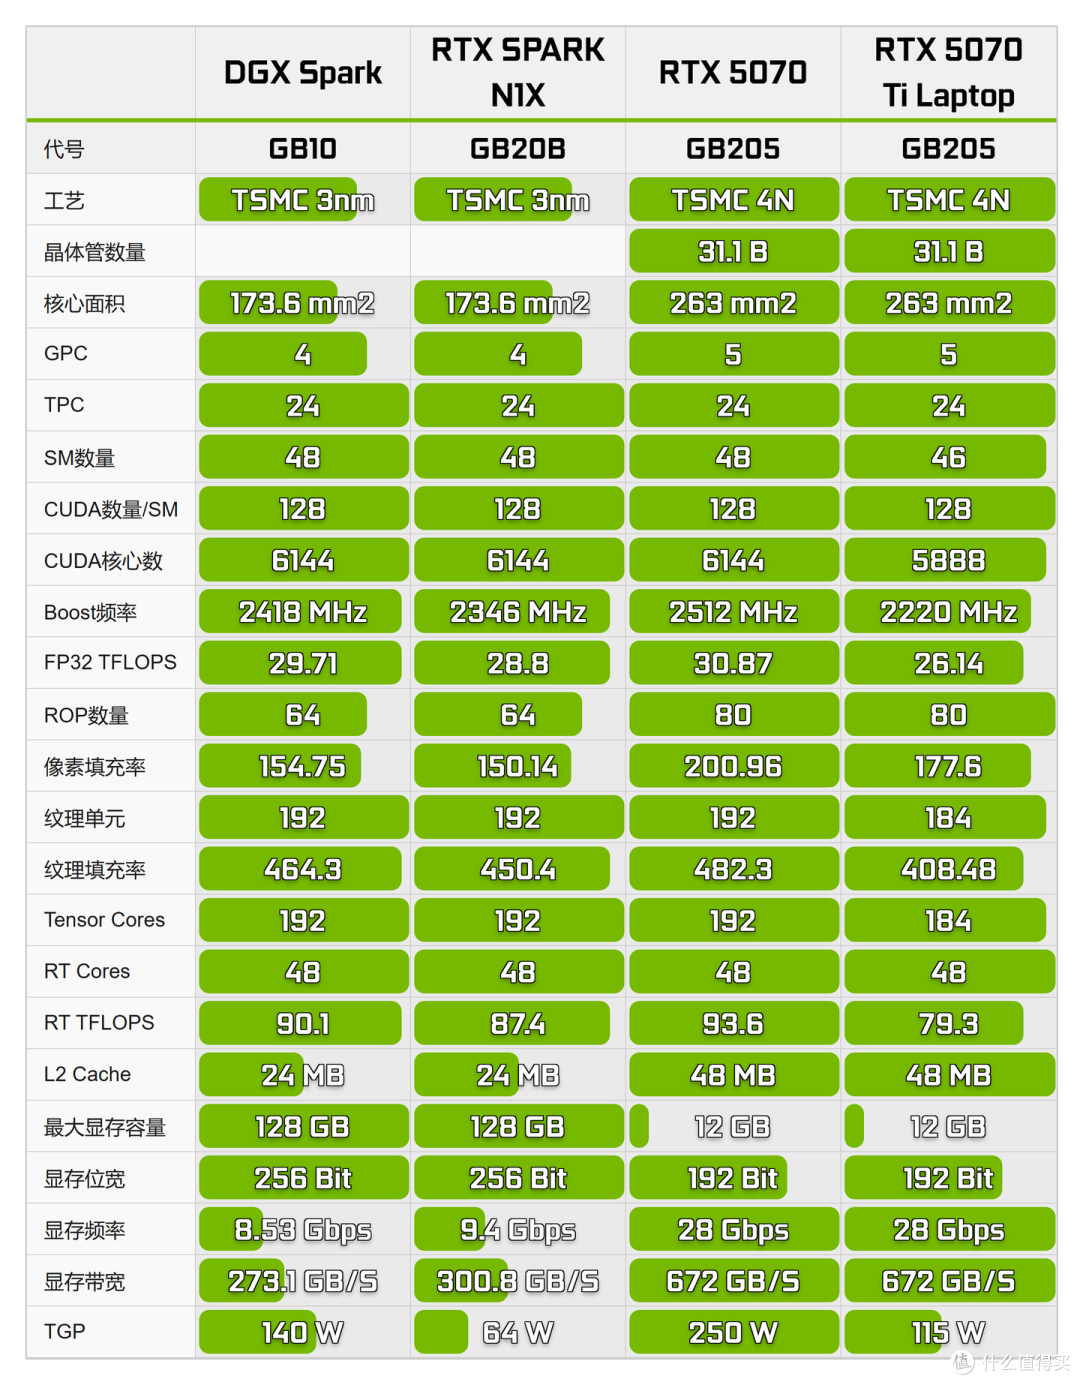
先看 GPU 部分。RTX Spark 的 N1X 拥有 6144 个流处理器(48 组 SM),账面规模与桌面端 RTX 5070(GB205)一致,RT Core、Tensor Core 等与 SM 绑定的计算单元数量也完全相同。但对比核心布局就会发现,两者的内部拓扑存在明显差异:桌面端 RTX 5070 采用 5 组 GPC、每组 10 个 SM 的设计,屏蔽 2 组后保留 48 个 SM;而 N1X 则是 4 组 GPC、每组满配 12 个 SM,刚好凑齐 48 组 SM。
但光栅化单元 ROP 是和 GPC 绑定的,一组 GPC 有 16 个 ROP,这样 RTX 5070 是 5 组 80 个 ROP,而 N1X 是 4 组 64 个 ROP,这将在一定程度上影响高分辨率的光栅化性能。
显存子系统的差异则更加直接。虽然 N1X 坐拥 128GB 超大统一内存,但受限于 LPDDR5X 的物理形态,其 300 GB/s 的带宽还不到桌面端 RTX 5070(192-bit GDDR7 28 Gbps,带宽 672 GB/s)的一半。后续实测环节,我们将重点剖析这一内存带宽差异对实际游戏与 AI 性能的具体影响。
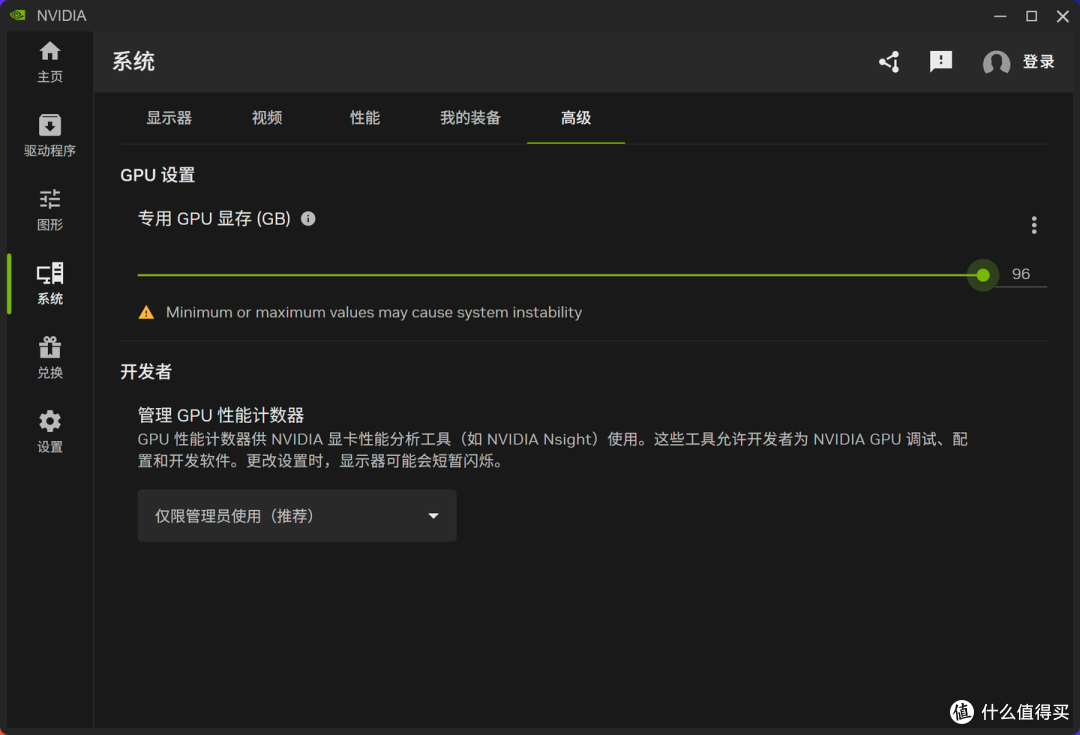
具体显存和内存的容量分配可以在 NVIDIA App 里调节,显存可用范围最低 4GB(但一般不建议少于 8GB),而最高可分得 96 GB,跟高贵的 RTX PRO 6000 一样,即使分了 96 GB,也还剩 32 GB,一般使用也是绰绰有余的。但其实我更建议显存小点内存大点(比如 80+48 GB),因为显存不够了可以借内存,而且也基本没有什么代价,但反过来万一内存不够了是借不了显存的。
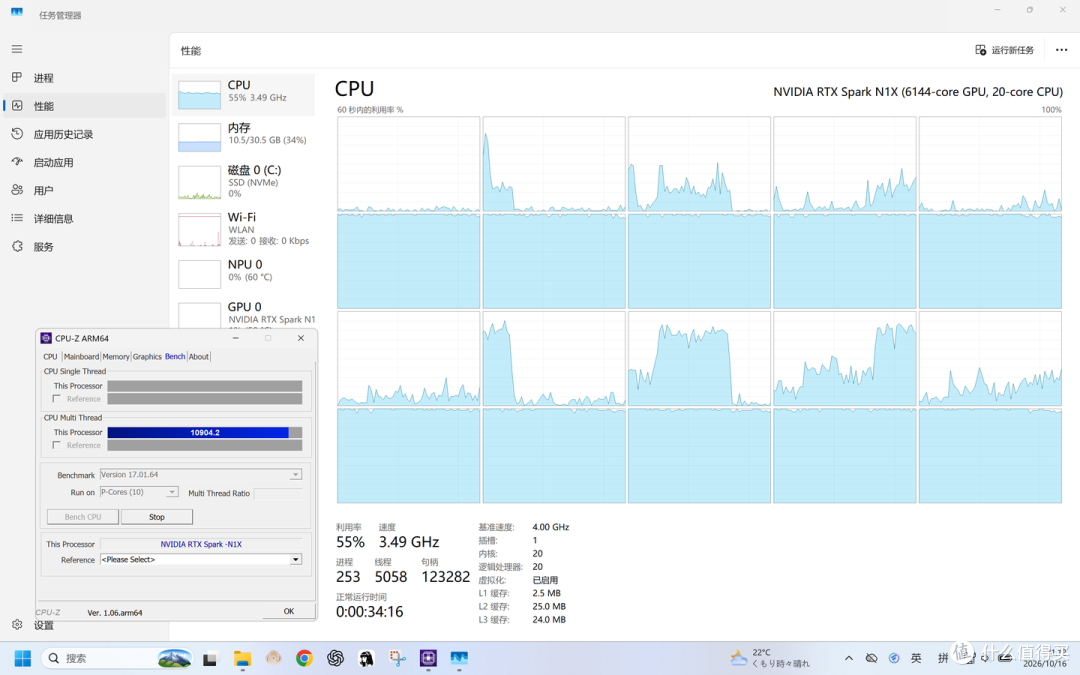
再看 CPU 部分。RTX Spark 与 DGX Spark 规格相近,同为 10 颗 Cortex-X925 超大核搭配 10 颗 Cortex-A725 大核组成的 20 核双簇架构。具体核心分布 CPU5-9 和 15-19 号核心是 4 GHz Cortex-X925 P-core,而其他的 CPU0-4 和 10-14 是 2.8 GHz Cortex-A725 的 E-core。
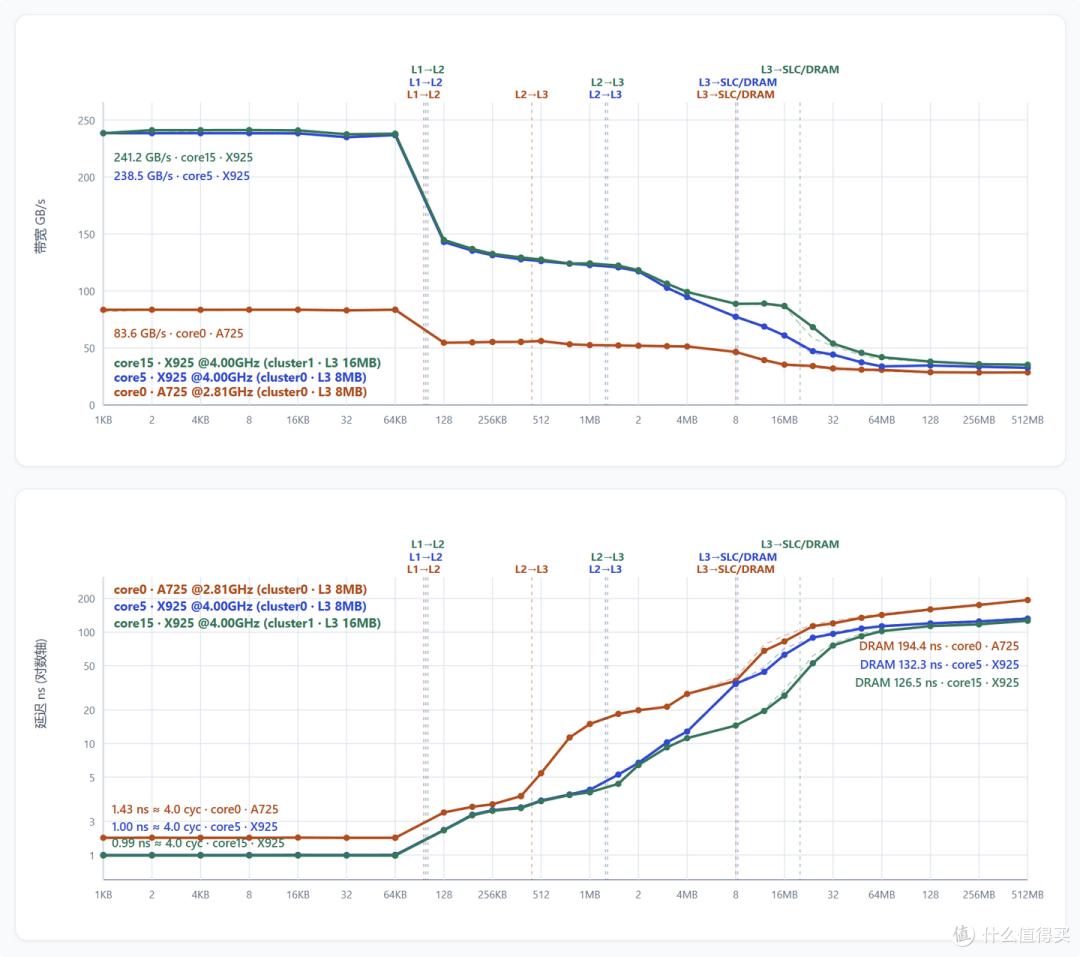
具体测试 CPU5/15 和 0 缓存/内存读取带宽和延迟,CPU15 的簇是 16 MB L3,CPU5 是 8 MB L3,和 DGX Spark 一样。 实际系统的核心调度策略应该是前台任务优先 CPU15-19,但后台任务则优先 0-4。
虽然 ARM 公版已迭代至 C2架构,但芯片研发周期通常长达数年,且核心 IP 深度绑定制程,在 GB10/N1X 规划阶段选用匹配台积电 3nm 的 Cortex-X925 完全符合正常的工程节奏。并且得益于笔记本平台更高的功耗限制和散热规模,N1X 其实际性能还要优于那些号称 4.6 GHz 甚至 5 GHz 新架构的手机 ARM 处理器。
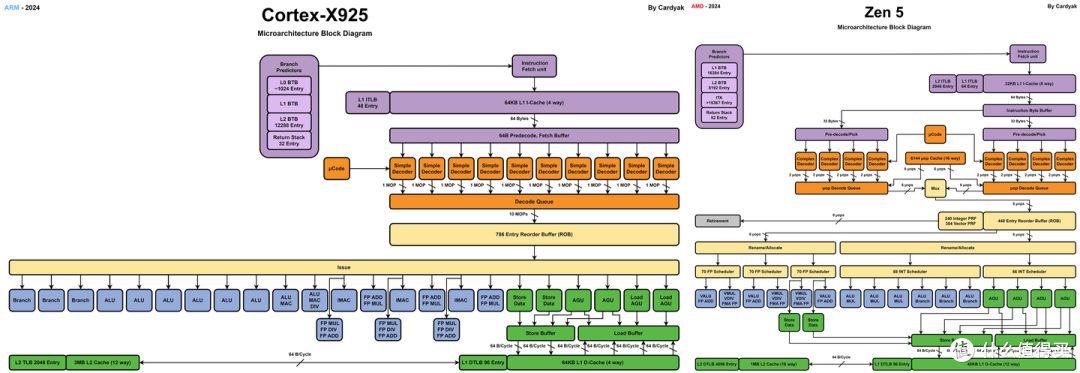
当年 Tegra 3 上笔记本电脑/平板没有大获成功,除了生态问题,和其性能相比 X86 过于孱弱也脱不了干系。但如今的 Arm 架构早已不可同日而语,N1X 的 Cortex-X925 拥有高达 10-wide 的解码与派发宽度,超越了 Intel Lion Cove(8-wide)与 AMD Zen 5(双 4-wide),而后端 768 条目的 ROB 容量,也明显大过 Lion Cove(576)与 Zen 5(448)。
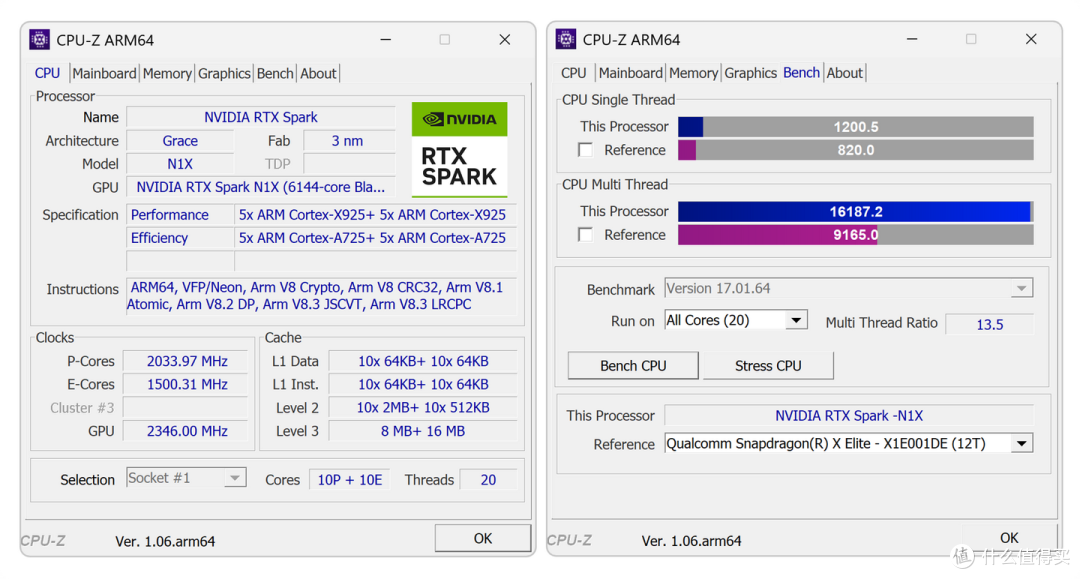
我简单跑了个 CPU-Z 的 CPU 测试,最高频率仅 4 GHz的N1X 的单线程得分居然高达 1200 分,要知道 intel 和 AMD 的桌面级平台旗舰 285K/9950X3D 跑 5.5 GHz+也就 900 分出头。单论同频 IPC,X925 已不虚主流桌面 x86 核心,现在 ARM 在笔记本上稍微放开功耗,在部分测试项目上就可以将 X86 性能远远抛在后面,并且配合 Arm 天生的高能效比,在严控功耗的移动端反而更容易跑出更高的实际性能。当然 CPU-Z 仅仅是代表浮点性能,这个性能同实际绝对重头的整数性能相对比较脱节,N1X 具体的 CPU 性能可以看后文的对应部分。
AI 性能测试
AI性能测试部分自然是 RTX Spark的重头,这部分测试我们分为本地大语言模型(LLM)部署测试和ComfyUI Qwen-Image2.1图片生成/MiniMAX-H3视频生成两个部分。
大语言模型(LLM) 性能测试
重头戏是大语言模型(LLM)和 AIGC 相关的 AI 性能测试。在看数据前,先引入一个计算大模型本地推理速度的基础公式:
显存带宽 / 权重容量 = 理论上未优化的 BF16 精度 Token/S
性能若将精度转为体积减半的 FP8/Q8,这个理论性能上限直接 x 2,若采用 NVFP4 或 Q4 量化,性能上限则可以 x 4。当然,这只是未考虑投机解码命中率与多 Token 预测(如 MTP)的纯理论数值,虽然实测成绩会明显高于该上限,但不同精度档位之间的性能倍率依然遵循这一相关关系。
以 RTX Spark 运行 Qwen3.8-27B-BF16 为例:
尽管 RTX Spark 可划分出的 80 GB 显存容量足够装下 55.6 GB 的权重,但 300 GB/S 级别的带宽去硬跑 BF16 精度显然是不够用的。因此从实用角度出发,RTX Spark 即使是运行 27B 这样的小规模模型也还是得以 4 Bit 级别为基准。
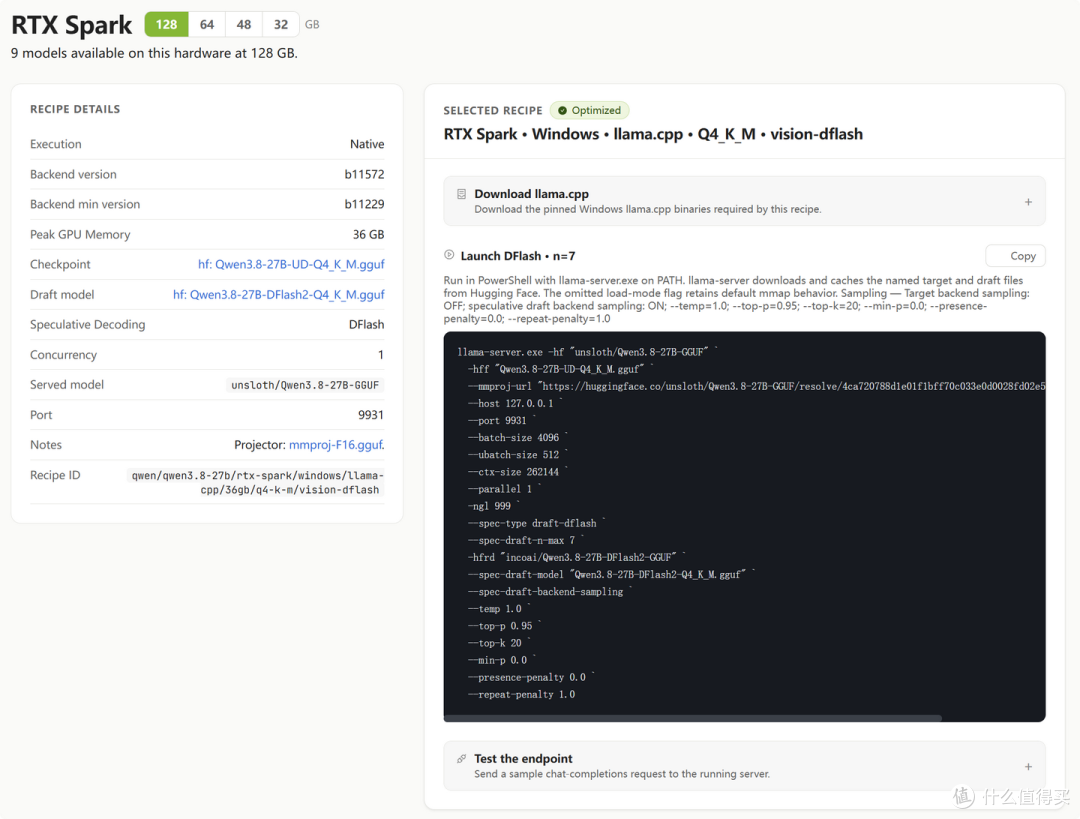
但具体模型怎么选择也不用头疼,英伟达官方做了个本地 AI 模型选择器 RTX Spark - recipes,你选择你的 GPU 型号,系统就会给出推荐模型/精度/配置命令行和预期性能。上篇业务实战时,本地服务采用64K上下文配置,长任务反复触发压缩。这次性能测试重新调整了部署方案,将27B模型的上下文配置提高到256K,并加入DFlash2投机解码,进一步考察这台机器的大内存能换来多少实际性能。两轮采用的配置不同,下面的结果也要放在新的条件下理解。所以这次我使用 Qwen3.8-27B-UD-Q4_K_M 设置 256K KV 作为基准进行了测试。
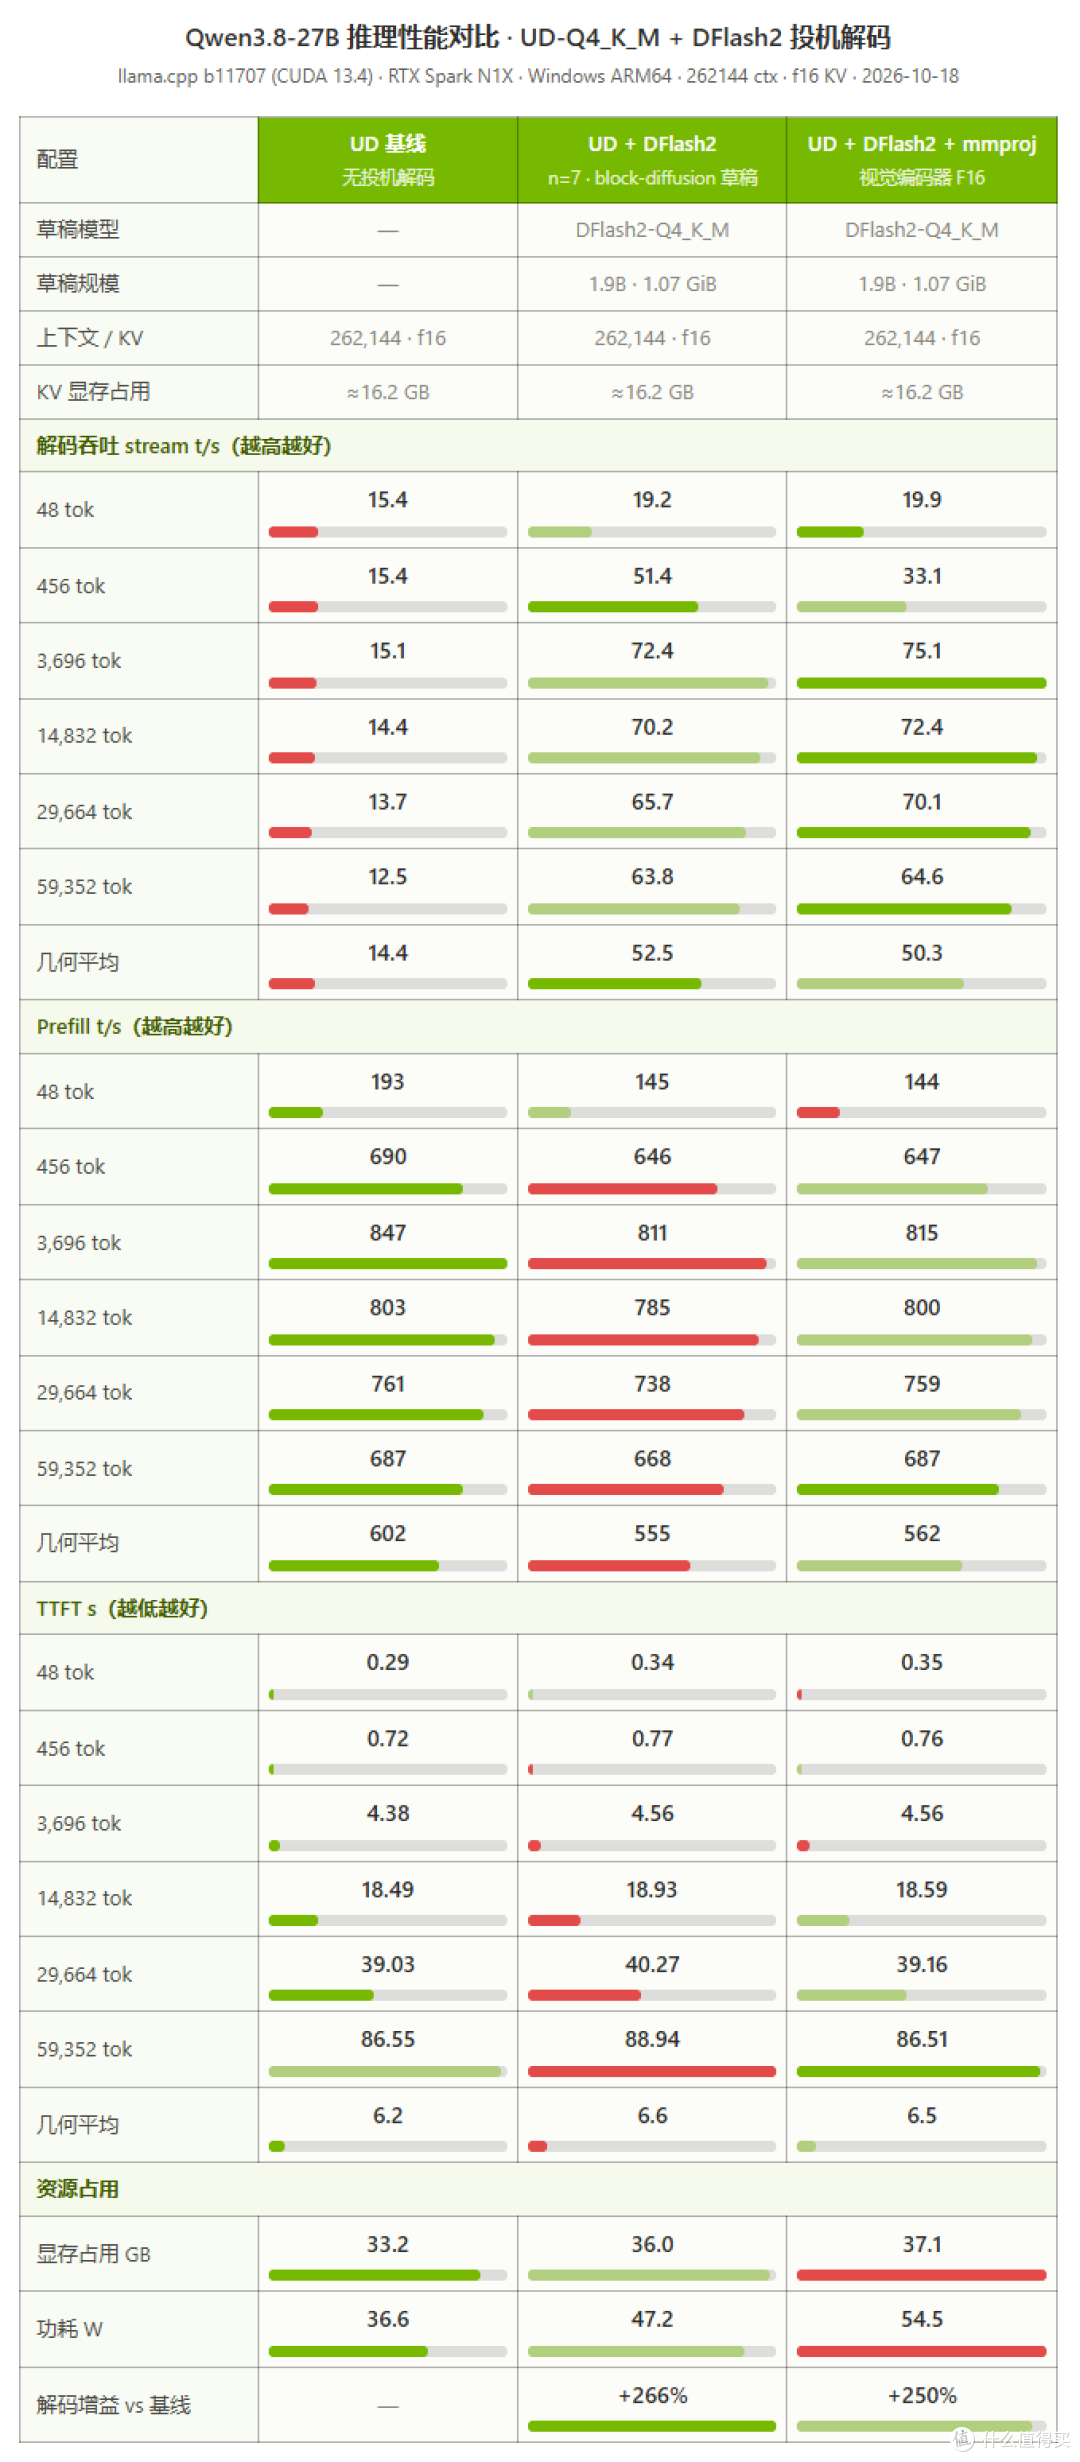
先看最直观的吐字速度:在默认不开投机的情况下,受限于显存带宽,基础解码只有 12.5 到 15.4 t/s(几何平均 14.4 t/s 接近前面提到的带宽计算公式极限)。而在挂上 DFlash2 之后,中长上下文的生成速度直接拉到 63.8 到 75.1 t/s,最高涨幅超过 250%。当然测试探针有重复句高命中的加成,如果换成日常真实文本,实际跑下来大概稳在 36 到 45 t/s,体感流畅度大概也是之前原生的 3 倍。
简单理解 DFlash2 的原理,就是“小模型打草稿,大模型集中批改”。以前 27B 模型每出 1 个词都要读一遍全部权重,全卡在显存带宽上。现在先让 DFlash2 小模型一口气往后猜 7 个词打好草稿,27B 主模型只需读一次权重就能同时核验完这 7 个词。实测草稿命中率能到 92.5%,相当于读一次显存就能蹦出好几个词,生成速度自然翻了 2 到 3 倍。
不过这套草稿要额外多吃 3GB 显存,这点开销在 128 GB 统一内存的 RTX Spark 上毫无压力,但放到消费级顶级的 RTX 5090 D v2 就完全不可行了,24 GB 除去系统开销和模型权重,再加上这 3GB 就完全没空间放 KV 了,因此这套也只能在 Spark 上用用。 RTX 5090 Dv2 24 GB即使不加载DFlash2靠带宽硬抗了,也基本只能用64K Q8上下文,不过 50-60 t/s的硬抗速度比 RTX Spark 还是稍微快一点。
但在128 GB的RTX Spark上就可以轻松实现KV自由,我们不仅可以直接拉满 256K,还可以使用的最高 F16 精度,而不用像桌面显卡为了节约显存而使用 Q8 精度。并且经过我们实测,使用 Q8 由于还需要额外执行反量化还原,速度反而比F16还更慢一点点。
并且再外挂 mmproj 的视觉编码器增加多模态能力,也基本不影响纯文本性能,仅仅是增加了 1GB 多的显存占用。这样整体显存占用 37 GB,还不到设置的 80 GB 显存容量的一半。
当然 Qwen3.8-27B 还没用到 RTX Spark 128 GB 统一内存的 1/3,我是不会满足的,现在就挑战下 Qwen3.8-Flash-Next,还是用上面的 英伟达官方推荐页面来部署 Qwen3.8-Flash-Next-UD-IQ4_XS。
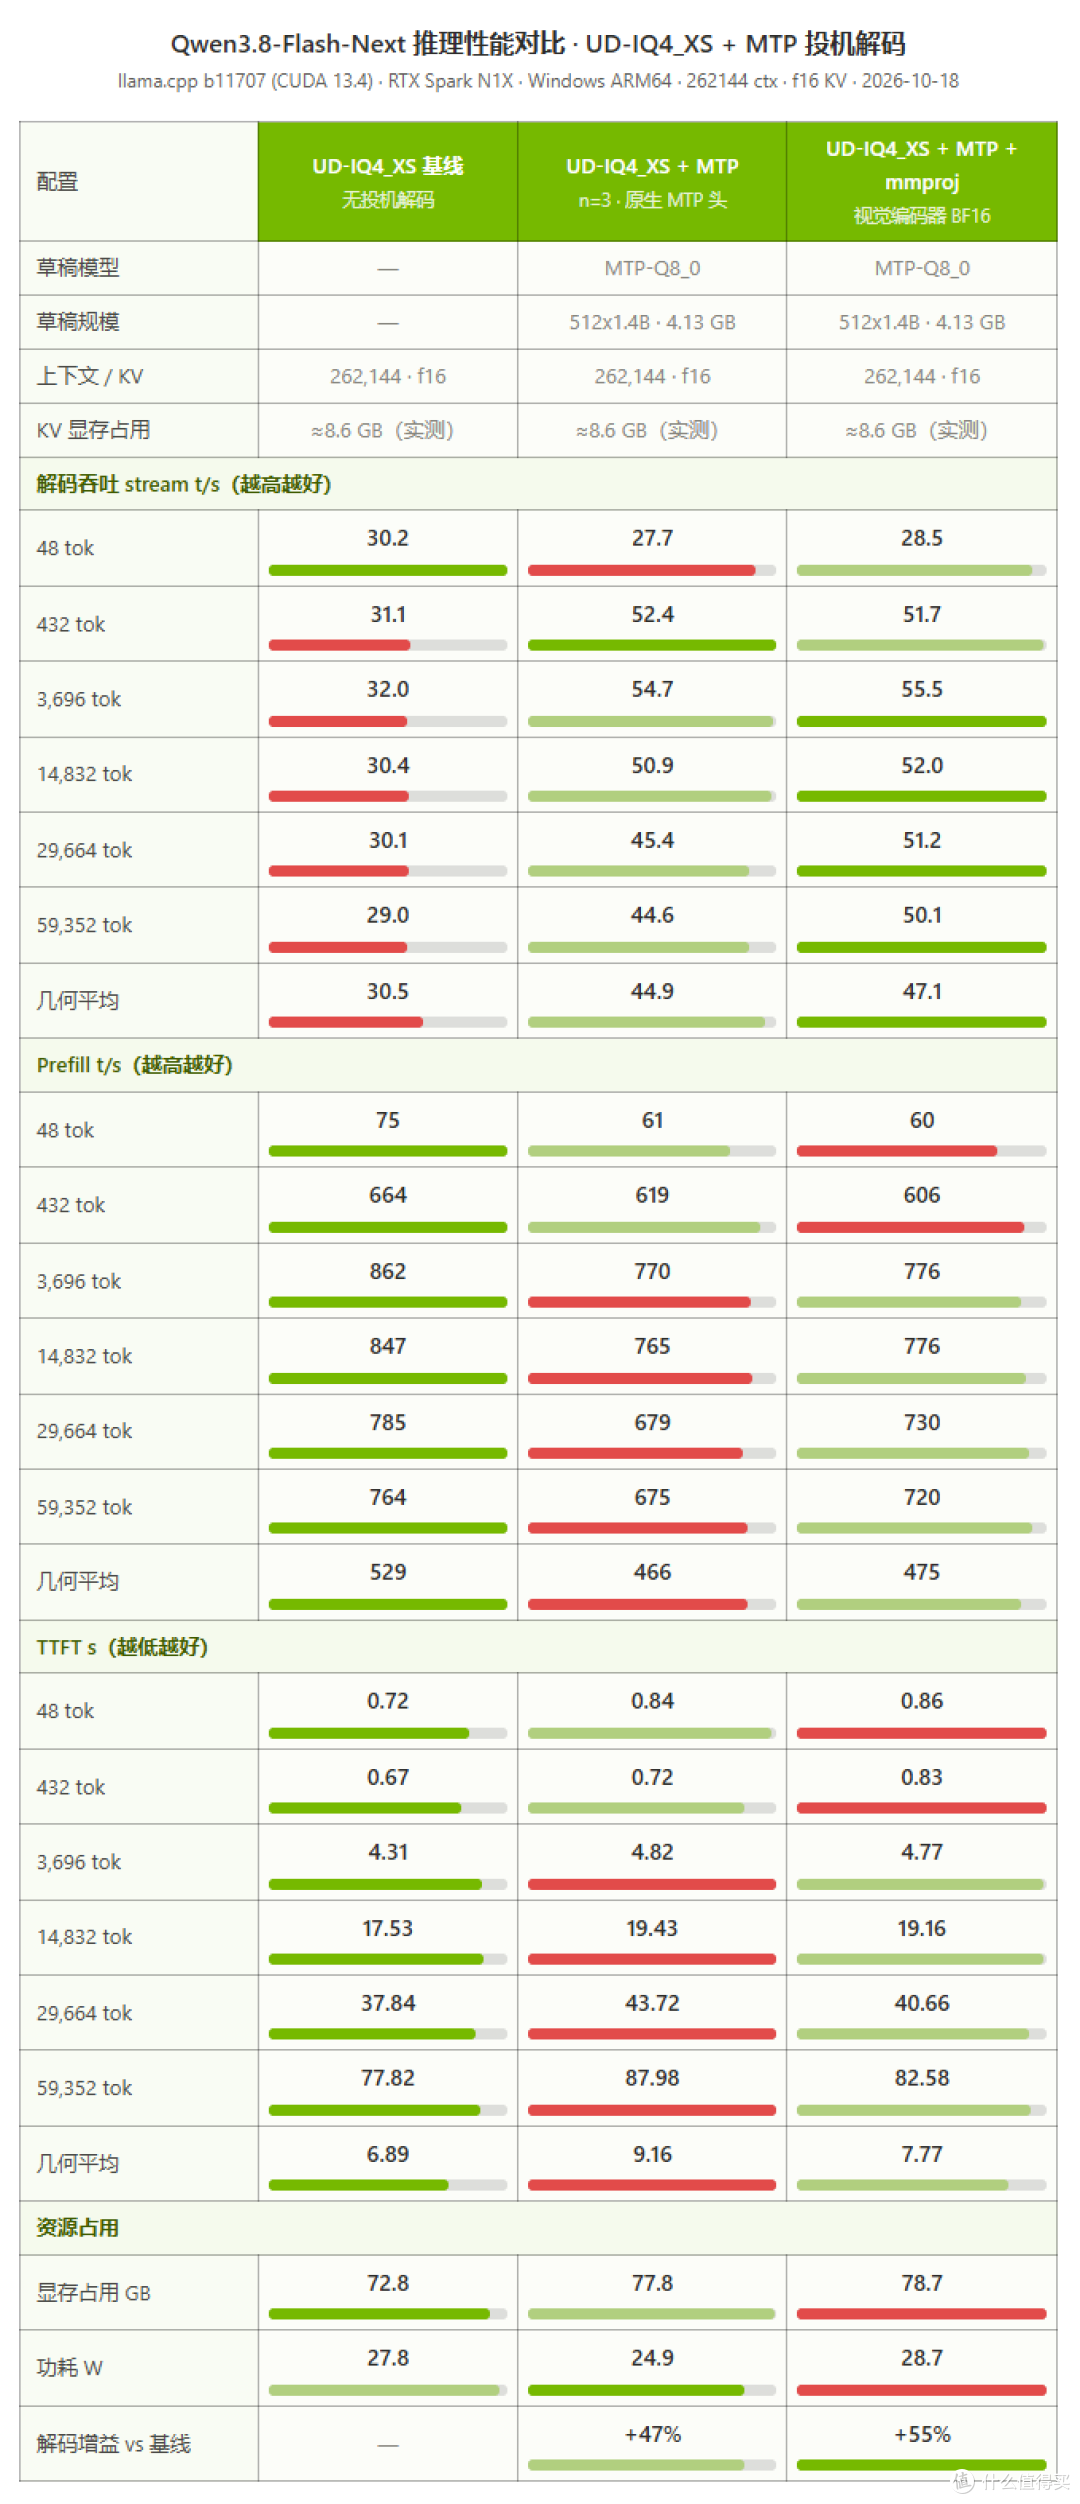
Qwen3.8-Flash-Next-UD-IQ4_XS 本身模型权重 87 GB,我设置的显存 80 GB,内存 48 GB,这其实超过了显存容量需要 offload 到内存。传统独显部分一旦移到内存,带宽就直接用从千 GB 级别直接掉到 100 GB/s 的级别,性能直接是数量级的下降。但 RTX Spark 全局 300 GB/S 统一内存架构就不存在这个问题,即使模型或者KV超出了设置的显存容量Offload到了内存,也不需要重新加载,统一寻址直接移动内存指针就可以。
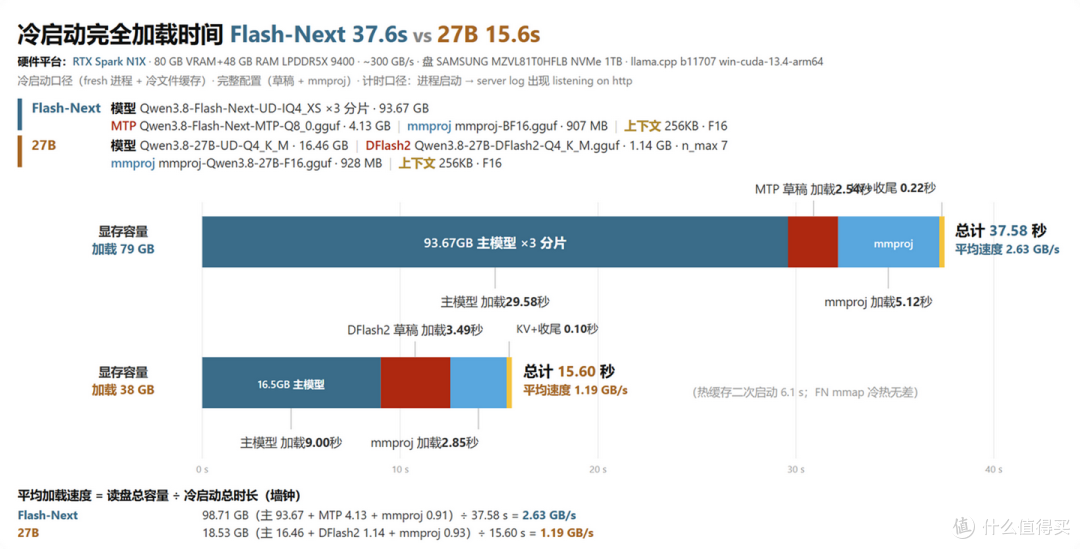
并且加载的时候,传统显卡显存数据需要先读到内存再通过PCIe传显存,这样需要多捣鼓一次,而RTX Spark是直接读到统一内存就Over,所以模型加载速度也更快。我这加载Qwen3.8-Flash-Next-UD-IQ4_XS+MTP+mmproj也就37秒,平均加载速度高达2.63 GB/S,并且这还是PM9C1b 1TB在快装满的情况下测的。
Qwen3.8-Flash-Next-UD-IQ4_XS 原始模型有 30 t/s 的速度,是之前 27B 的两倍,这主要因为 Qwen3.8-Flash-Next 虽然参数高达 125B(算上外挂的 n-gram就是 176B),但由于采用稀疏混合专家(MoE)机制,实际只有激活的 6B 直接参与运算。运算量减小也附带着降低了 GPU 功耗,RTX Spark 运行 Qwen3.8-Flash-Next 的功耗甚至还不到 30W,远低于 27B 的 50W 水平。
Qwen3.8-Flash-Next-UD-IQ4_XS 在加载 MTP 后,性能则进一步提升到 50 t/s 以上。MTP 的作用机制接近 27B 的 Dflash,虽然预测词只有 3,性能提升幅度大概只有 50%,但是模型原生支持。当然 MTP 也是需要付出代价的,MTP 需要额外占用 5 GB 的显存(此外 mmproj 视觉模块需要占用 0.9 GB),这样的显存占用对于消费级的显卡也是过于奢侈,基本是吃不到这 50% 的性能红利。
不过在加载MTP后Flash-Next相比 27B在短输入下 Prefill还是更慢,导致首字延迟 TTFT明显变慢,但到 4K~60K 的长文本后,两者的 Prefill 与 TTFT 就差不多了。
AgentPerf 智能体性能测试
当然前面的测试是偏理论峰值性能测试,并不能真实反应实际应用场景的性能,因此在这里我们使用 agentperf 基准测试 RTX Spark 模拟真实 智能体多轮任务(涵盖代码修复、K8s 排障与长文档检索等共 168 轮对话),对比 Qwen3.8-27B 稠密模型(开启 DFlash2 投机采样)与 Qwen3.8-Flash-Next-UD-IQ4_XS(开启原生 MTP)的实际表现。图表中柱长代表端到端(E2E)吞吐,越长越快;柱厚代表首字延迟(TTFT),越薄响应越快。
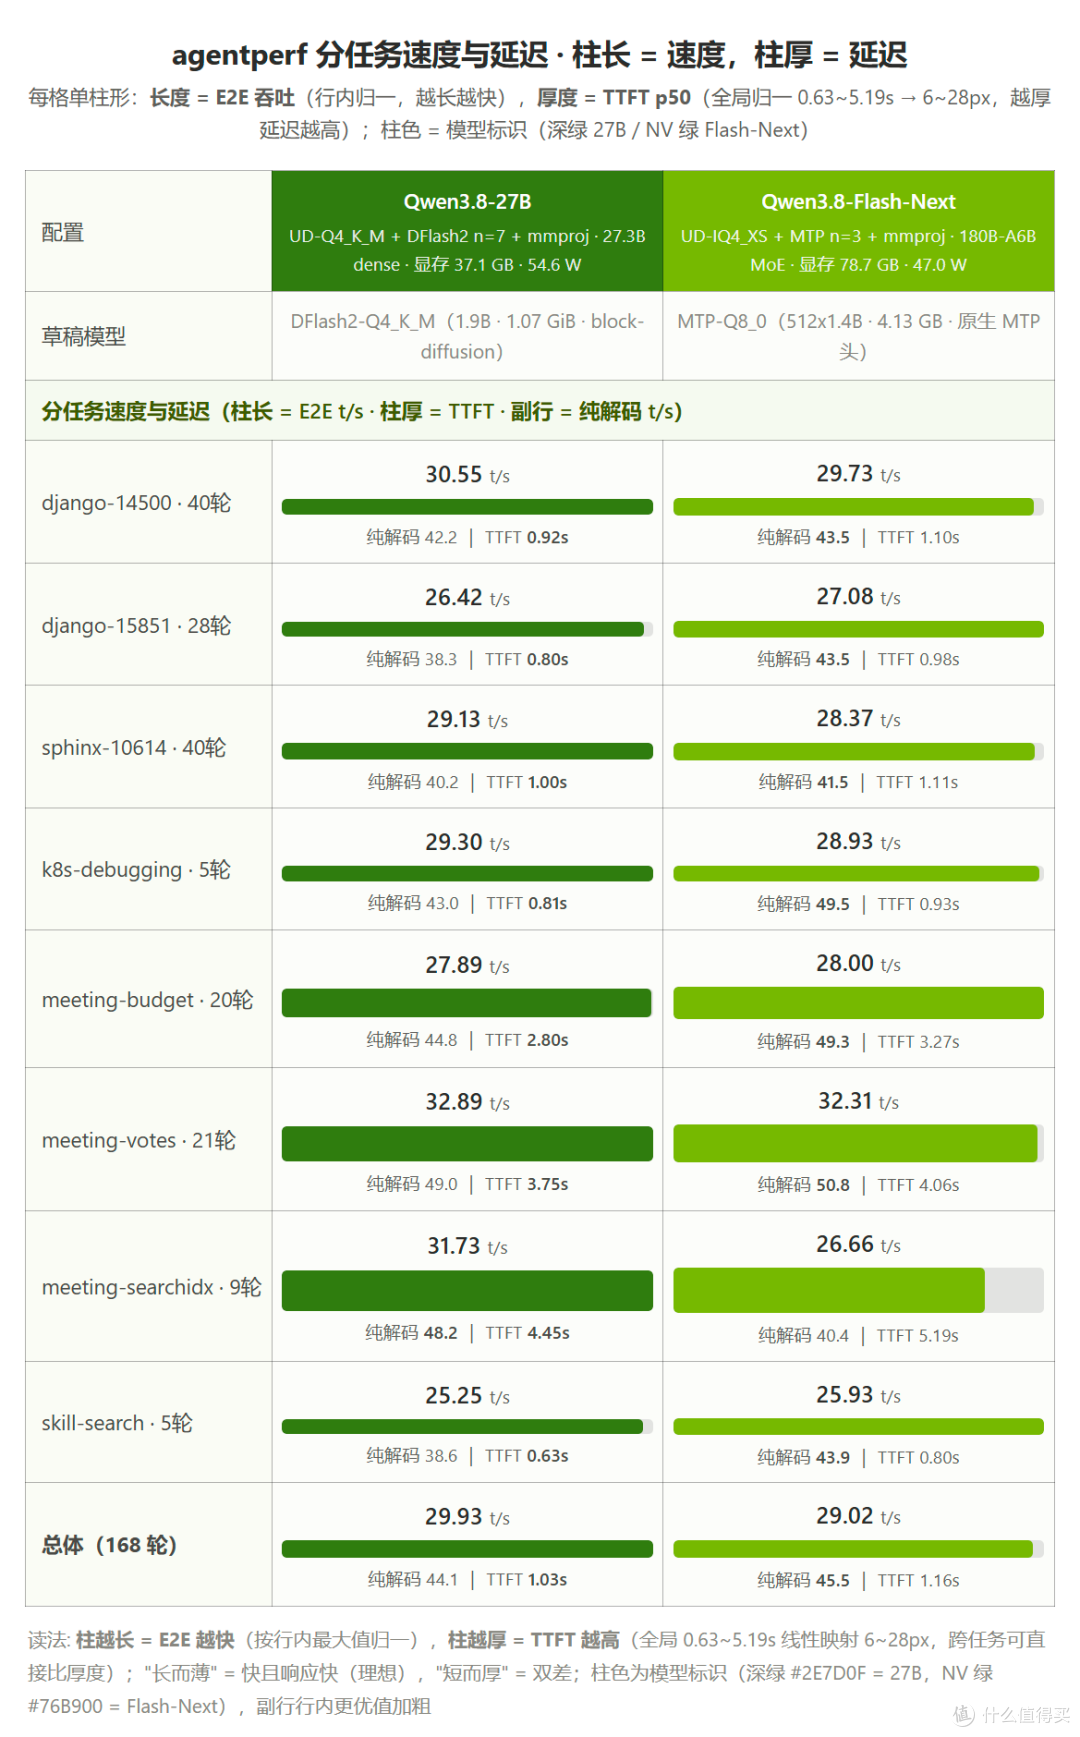
从代码修复、运维排障和长文档这 8 项实测来看,Qwen3.8-Flash-Next-UD-IQ4_XS 180B MoE 每次只激活一小部分参数,绝大部分任务里纯吐字更快,还更省电;而 Qwen3.8-27B-UD-Q4_K_M 稠密模型配了 DFlash2 草稿模型,遇到输出规律性差的检索任务,比原生 MTP 猜得更准、速度更稳。
延迟方面短平快的代码和日常排障大家都能秒回。但一碰到长文档,长输入会把 MoE 里一大堆专家同时唤醒,预填充负担剧增,所以首字响应反而是 27B 全程更快。说白了,经常多轮对话、喂长文档就用 27B,想图省电、吐字快或者看重超大模型的知识底子,就上 180B MoE。
体素花园测试
如果你觉得上面的 AgentPerf 智能体测试还不够直观,我这里就加入了像素宝塔花园测试。
Design a beautifully detailed voxel art environment featuring an ornate pagoda set within a vibrant garden. Include diverse vegetation, particularly cherry blossom trees, and ensure the composition is dynamic, colorful, and visually engaging. Generate this as a fully self-contained HTML file that runs in Chrome using Three.js or any voxel/WebGL library.
给大模型上面指令,让其通过 WebGL 生成一个类似我的世界的像素风格宝塔花园场景 HTML 页面。这个测试不仅可用来测试完成时间和速度,也能通过场景的完成度/功能来比较大模型的代码能力。具体我们测试 Qwen3.8-27B-UD-Q4_K_M 和 Qwen3.8-Flash-Next-UD-IQ4_XS 两个模型挂载 mmproj 进行测试,分别测试 LOW 和 XHIGH 思考强度。
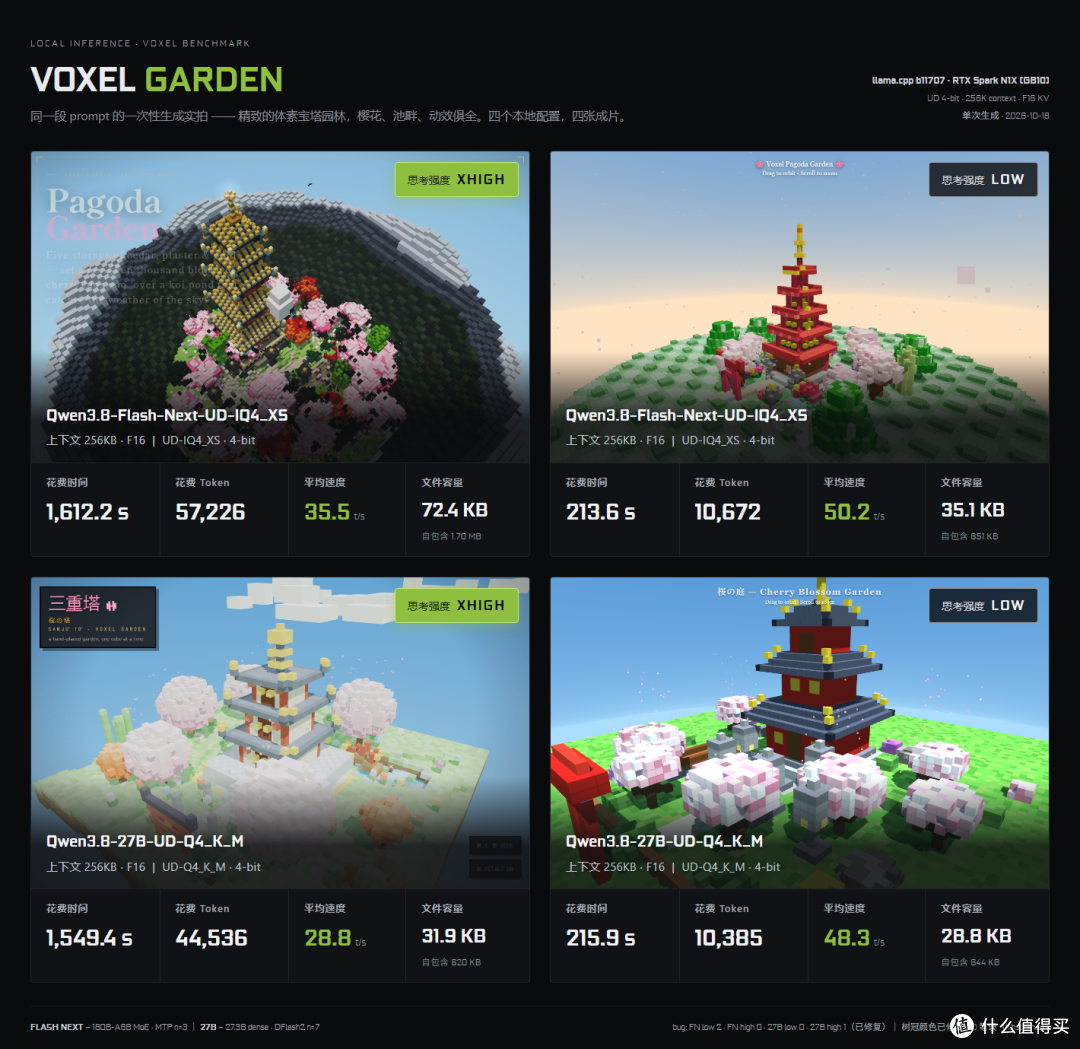
在 LOW 思考强度,Flash-Next 相比 27B 场景质量优势并不大,但 50.2 t/s vs 48.3 t/s 的性能还稍好。
而在 XHIGH 思考,由于模型需要进行长达数万 token 的深层逻辑推演、状态自查与规划设计。高密度逻辑思考时,思维反转多、发散度高、随机性强,草稿小模型的猜词命中率会明显下降,所以 27B 和 Flash-Next 性能都有明显下降。
但 27B 采用的是标准全注意力机制,随着输出长度不断拉长,从显存中反复搬运 KV Cache 的数据量会大幅攀升,受限于 LPDDR5X 的带宽,长文本解码性能会出现更明显的衰减。而 Flash-Next 采用的是混合注意力加 MoE 架构,其 KV Cache 显存搬运开销远小于全注意力的 27B,因此在超长输出下的性能衰减相对小很多。
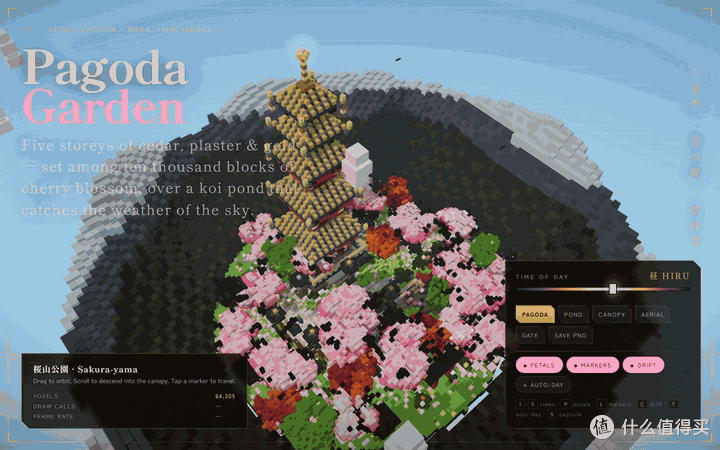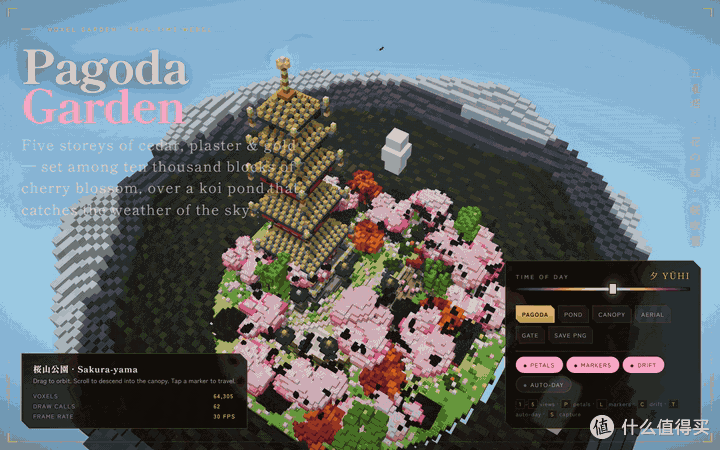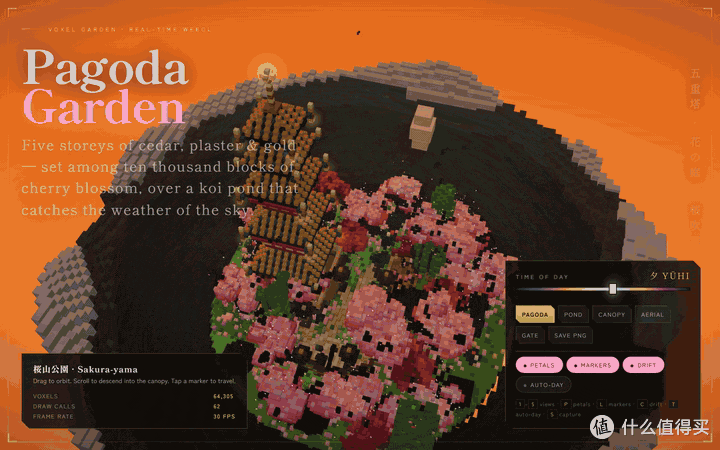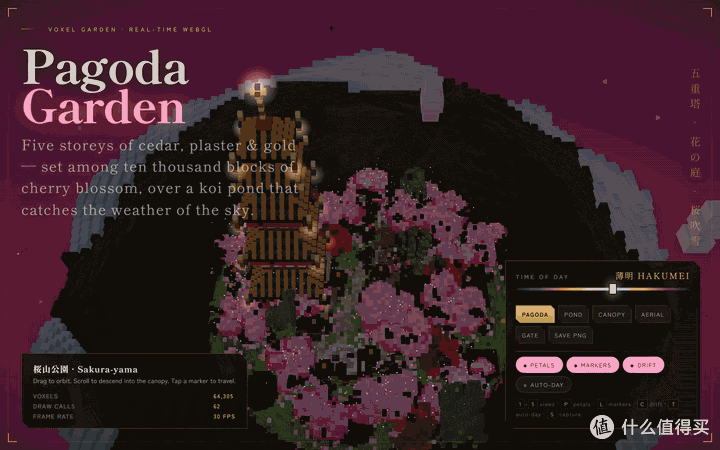
当然 Qwen3.8-Flash-Next 的更大优势是在于输出质量,不仅其场景指令更高,地形/宝塔/樱花树细节更丰富,还有可调节的动态的时间和天气/镜头机位选择和更多的场景特性选择。在提示词没有给出具体细节指令的情况下,开启 XHIGH 深度思考的 Flash-Next 展现出了更强的主观能动性。
ComfyUI 图片和视频生成测试
再就是 AIGC 方面的 comfyUI 测试,我们主要测试 Qwen-Image2.1 文生图测试和 miniMax-H3 文生视频测试。我之前在 x64 环境配置的 ComfyUI 放到 RTX Spark 平台上虽然不能说到手可用,但实际迁移还是比较简单,需要用到的库/依赖以及节点大部分都直接可用,就是部分 whl 轮子需要替换,找个 智能体处理就可以搞定。
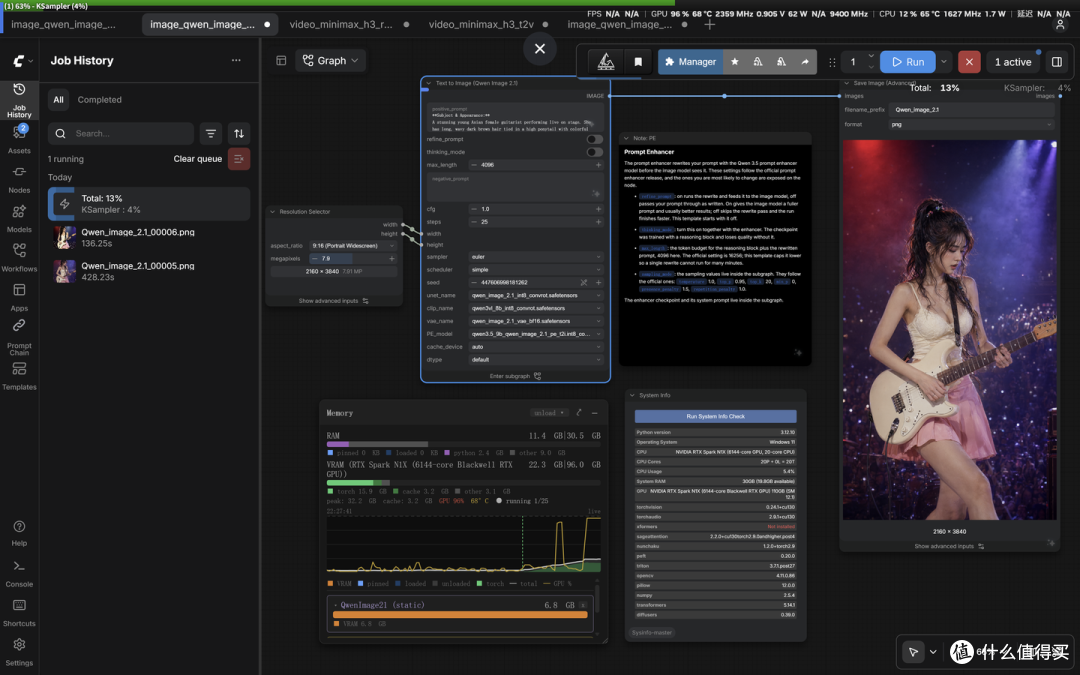
Qwen-image-2.1-Turbo 是 Qwen-image-2.1 的性能优化版本,降低了推理步数,在 RTX Spark 上生成耗时从 428 秒缩短到了 136 秒,差不多缩短了 70%。
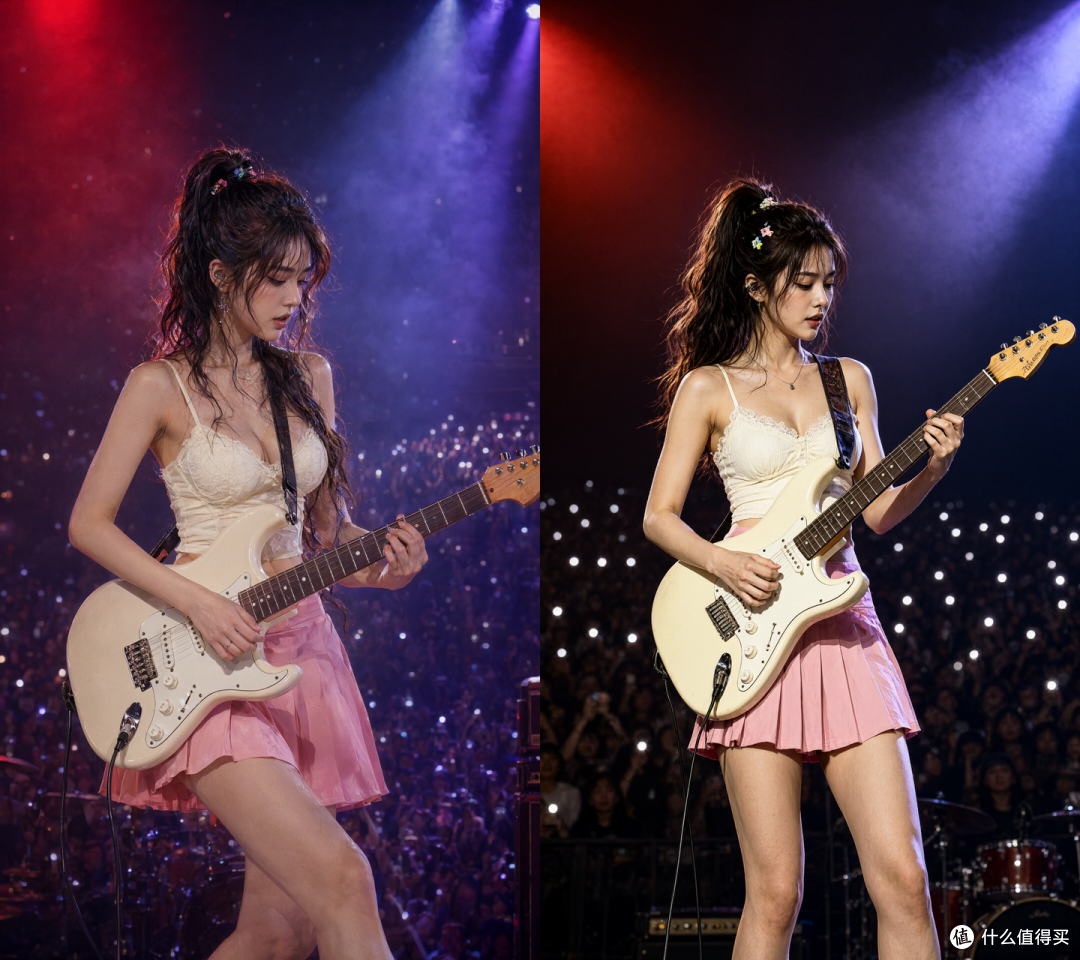
但对比图片可以看到,右边 Turbo 版本的画面细节还是有肉眼可见的劣化,标准版和 Turbo 实际还是要按需取用。
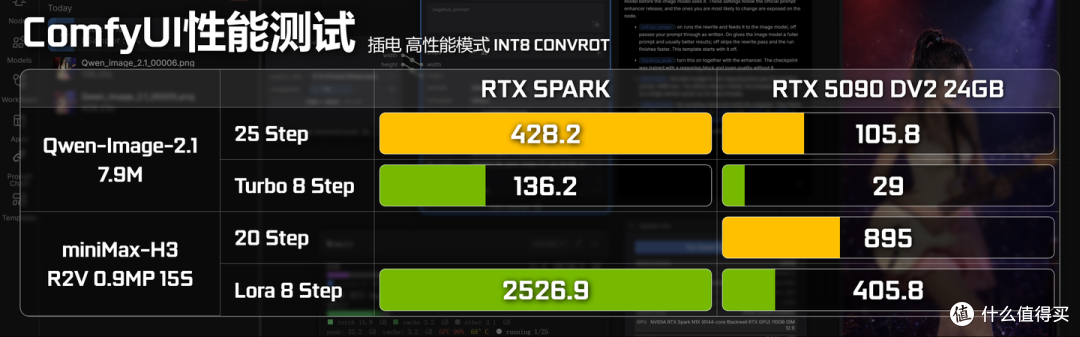
MiniMax-H3 测试,我们使用官方参考视频生成工作流生成 0.9M 像素 15 秒的视频,分别测试原生流程和 8 步 Lora 加速。RTX Spark 跑完 8 步 Lora 就用了 42 分钟,RTX 5090 Dv2 24GB 跑完 8 步 Lora 时间为 6 分 45 秒,完整流程为 14 分钟 55 秒。RTX Spark 这样速度再去跑完整的 20 步就意义不大。
对于 AIGC 生图生视频,本身模型并不太大,高端旗舰的消费级显卡 16-24 GB 显存也勉强装的下,RTX Spark 的大显存容量优势就不大,但 GPU 规模和带宽的短板就很明显,这类 AIGC 任务还是高端显卡更合适。
处理器性能测试
虽然 RTX Spark 的 GPU 才是性能测试的重点,但我觉得有必要将 CPU 提前说,这样才能减轻后面 GPU 测试对 CPU 方面的疑虑。
RTX Spark 的 CPU 是 ARM 架构,运行的系统是 Windows 11 For ARM64,运行程序就存在一个指令集兼容的问题。ARM 程序原生运行和通过 Prism 转译的方式运行在效能上必然有一些差别,我们会在部分 CPU 测试项目对原生和 Prism 转译分别进行测试,并且还需要关注其大小核调度策略,对于性能有怎么样的影响。
Prism 转译大部分程序都正常运行,但部分涉及系统底层的就比较容易出问题,而硬件测试相关软件恰好是问题的高发区,例如 CPU-Z/GPU-Z/AIDA64 之类的 x64 版本都运行不了,但同时 CPU-Z/HWINFO/3DMARK 也都有 ARM 的原生版本。
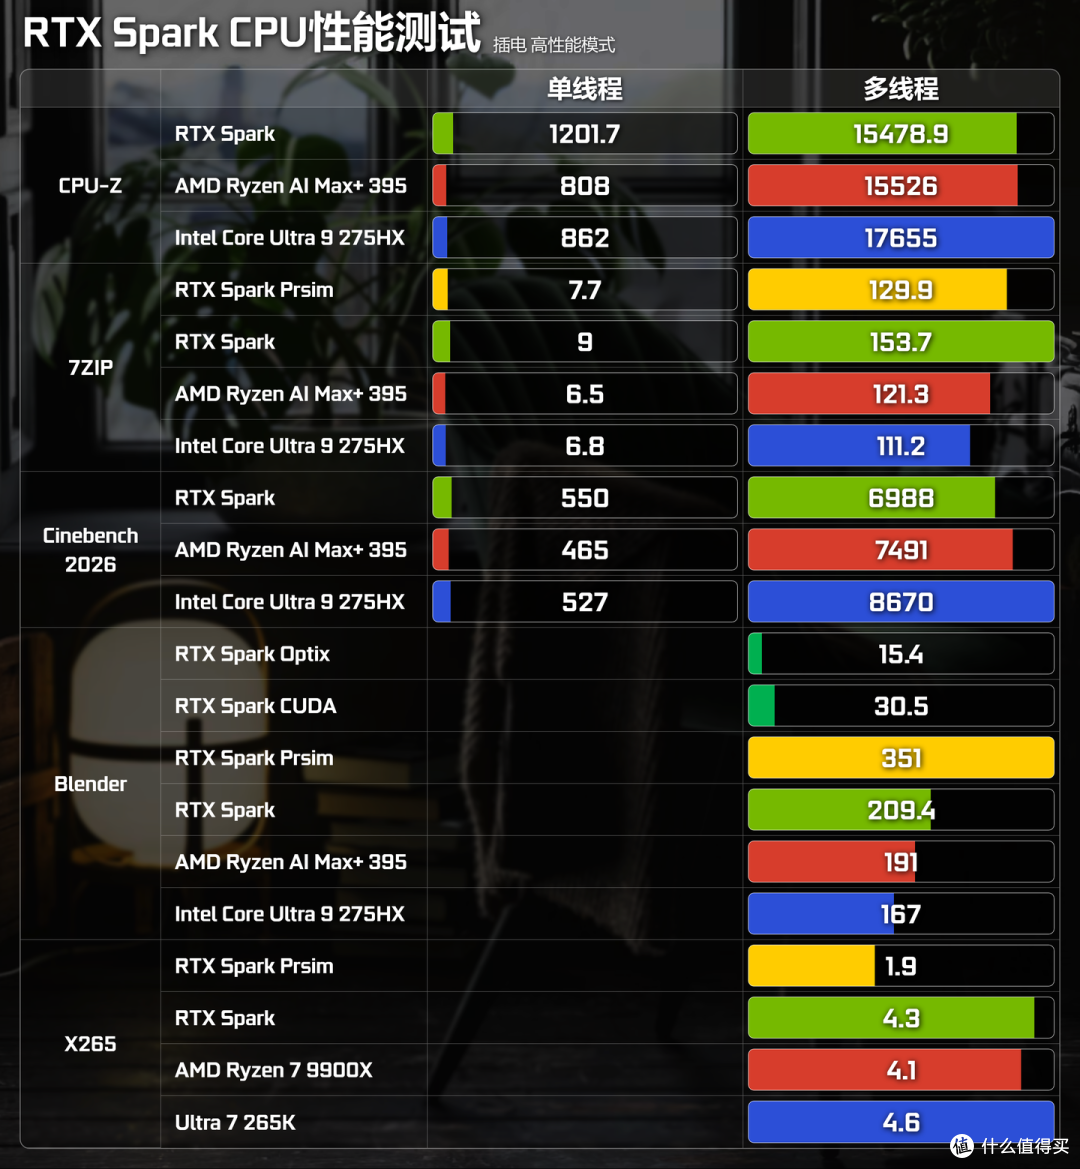
CPU 性能测试我们选取了 5 个测试项目:(上图 AI Max+ 395 和 275HX 得分数据来源于notebookcheck.net)
CPU-Z(标量浮点性能):原生 ARM64 下,Cortex-X925 跑出了 1201.7 分 的惊艳单线程成绩,大幅甩开 800 多分的 x86 旗舰竞品。多线程方面,RTX Spark 与 16 大核的 Ryzen AI Max+ 395 基本持平,但落后于 8P+16E 的 Core Ultra 9 275HX,主要原因在于 10 颗 A725 相比 16 颗 Skymont 差距明显。
7-Zip(整数性能与缓存/内存延迟):该项目对整数流水线、缓存及内存延迟高度敏感,负载特征与实际游戏最为接近。在这一项上 RTX Spark 全面大幅占优;哪怕强制运行 x64 版本走 Prism 转译,在扣除约 15% 的转译损耗后,依然压过了 AI Max+ 395 与 275HX。
Cinebench 2026(SIMD 向量并行指令):主要考察 SSE/NEON 等 128-bit 向量并行吞吐,并包含少量 AVX 与 SVE 指令。结果依然延续了“单核猛、多核受制于 A725”的特征:RTX Spark 单线程以 550 分保持领先,但多线程(6988)落后于两款 x86 竞品。
Blender Classroom(SSE 转 Neon 转译损耗验证):由于 Cinebench 2026 无法转译运行,我们换用负载相近的 Blender Classroom 场景进行测试(渲染耗时越短越好)。原生 ARM64 下 RTX Spark 耗时 211 秒,与竞品的差距比例同 Cinebench 类似;但一旦切到 x64 Prism 转译模式,耗时直接暴增至 351 秒,性能损耗高达 40%。可见在向量指令集层面,SSE 转译为 NEON 的效率远不如纯标量整数和浮点那样高效。
x265 视频编码(重度 AVX2 vs SVE 考验):这项测试直接把 SIMD 转译的痛点拉到了极限:原生 ARM64 下 RTX Spark 跑出 4.3 FPS,略优于桌面端 Ryzen 9 9900X(4.1 FPS),直逼 Core Ultra 7 265K(4.6 FPS);但通过 Prism 转译运行 x64 版本时,帧率直接腰斩至 1.9 FPS,性能暴跌超过 55%。AVX转SVE的效率比SSE转Neon还更低。
从上面五组数据可以清晰看出,微软 Prism 转译器在处理常规整数、浮点指令时已经相当成熟(损耗仅 15% 左右),这也保证了日常软件和游戏的 CPU 的基本体验;但一旦撞上重度依赖 SIMD 向量指令(SSE/AVX2)的负载,转译效率就会出现断崖式下跌。
不过平心而论,这个短板在实际使用中根本算不上真问题。因为在真实的工作流里,会重度调用 AVX2/SIMD 指令的场景无非就是 3D 渲染与视频编解码。而这两样活儿在 RTX Spark 上本来就该交给那颗强大的 Blackwell GPU 去干。就拿刚才测试的 Blender 来说,直接开启原生的 CUDA 与 OptiX 硬件光追加速,不仅渲染速度快上十倍不止、功耗更低,画面输出质量上也看不出差别,真实使用场景中根本不会有人放着满血的 RTX GPU 不用,去拿 CPU 硬跑 x64 转译去跑渲染和编码。
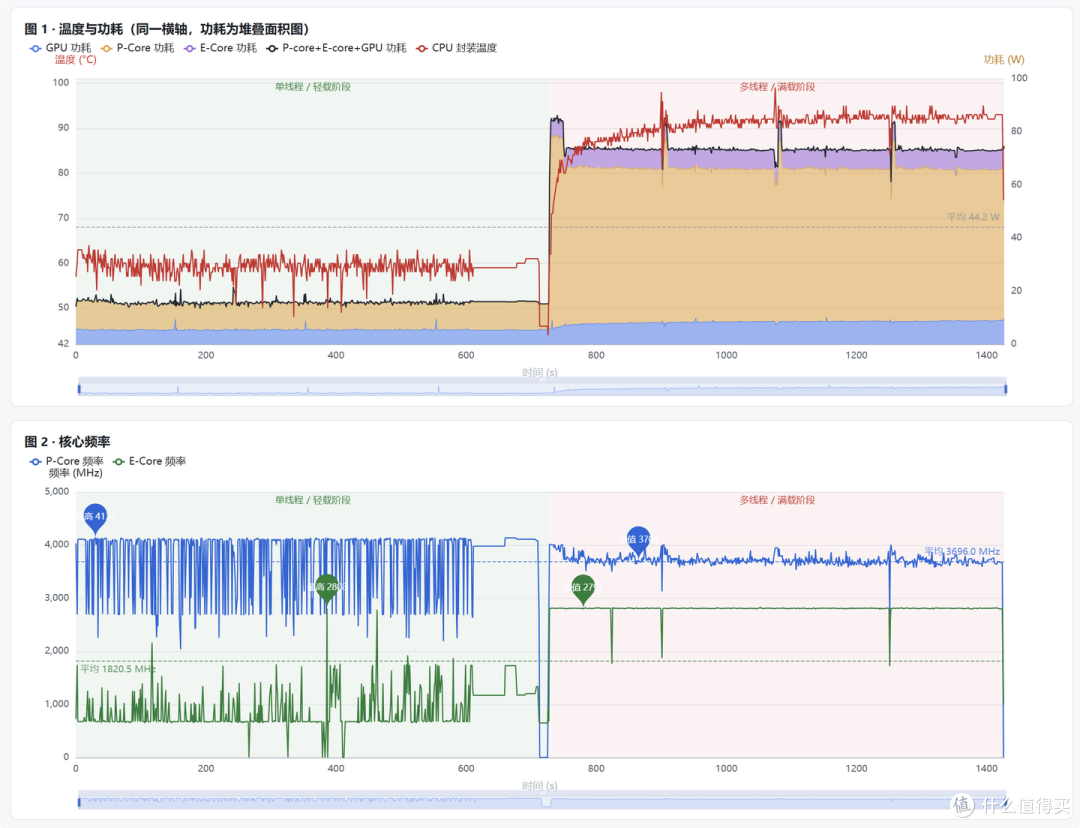
另外我们也使用 Cinebench 2026 的 10 分钟测试分析了 RTX Spark CPU 的性能稳定性和功耗,在前面的单线程部分 P-Core 基本可以全程稳定 4 GHz 以上,并且还会 Boost 到 4.1x GHz,P-Core 的功耗整体在 10W 水平,稳定性和能效表现都不错。
多线程部分,P-Core 全核心 4 GHz 大概可以坚持 20 秒,这个时候 P-Core+E-Core+GPU 的功耗在 85W,其中 P-Core 72W 左右,E-Core 7W 左右(目前抓取不了整体 CPU 或者封装功耗)。20 秒以后,P-Core 稳定 3.7 GHz 左右,而 E-Core 全程满频 2.8 GHz。
3DMARK 性能测试
3D性能测试部分首先还是喜闻乐见的 3DMARK环节,我们测试了 Steel Nomad/Port Royal 和 Speed Way 三个项目。
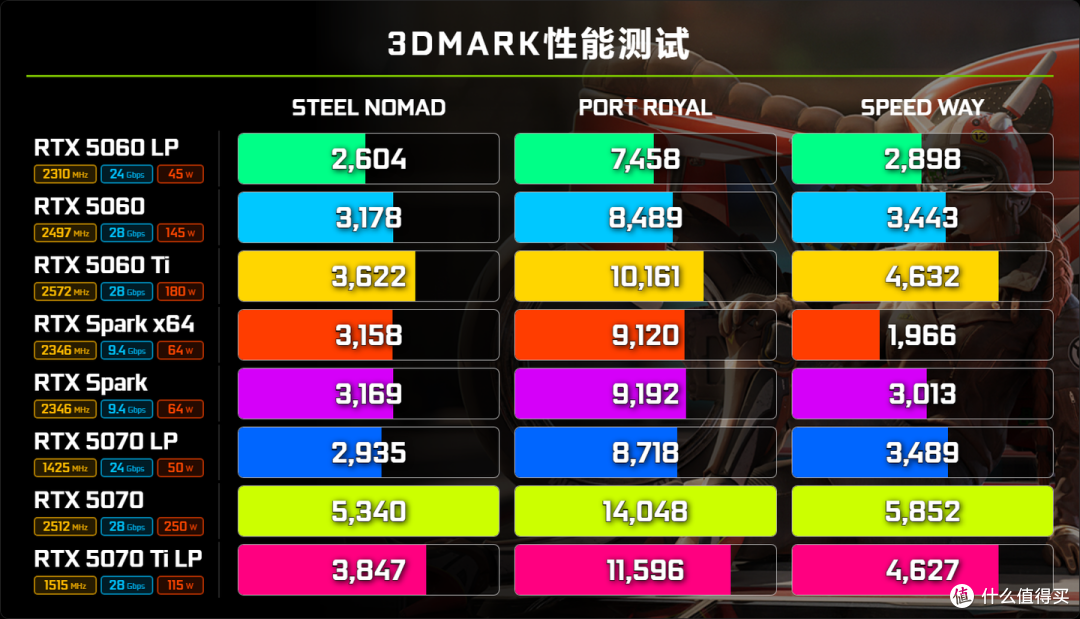
RTX Spark 的 DX12 光栅化 Steel Nomad 性能基本和桌面的 RTX 5060 持平,优于RTX 5070 Laptop,而光线追踪的 Port Royal测试RTX Spark相比则完全占优,但受到 LPDDR5X 带宽拖累,极其吃带宽的 Speedway 则明显落后于RTX 5060和RTX 5070 Laptop。(上图 RTX 5060 Laptop 和 RTX 5070 Laptop 得分数据来源于 notebookcheck.net )
RTX Spark 相比 115W 的 RTX 5070 Ti Laptop,Steel Nomad 和 Port Royal 是其大概 80% 水平,而 Speedway 同样被带宽拖累性能就只有 65%。
3DMARK 这些比较新的测试项目都提供了 x64 和原生的 Arm64 版本,Steel Nomad 和 Port Royal 的 x64 转译性能损失都小于 1%,基本是误差范围,但 Speedway 性能损失了 1/3,我也发邮件给了 UL Solutions,对方答复应该是与反作弊相关。从 3DMARK 性能来看,Prism 转译对于 3D 性能几乎没有影响。
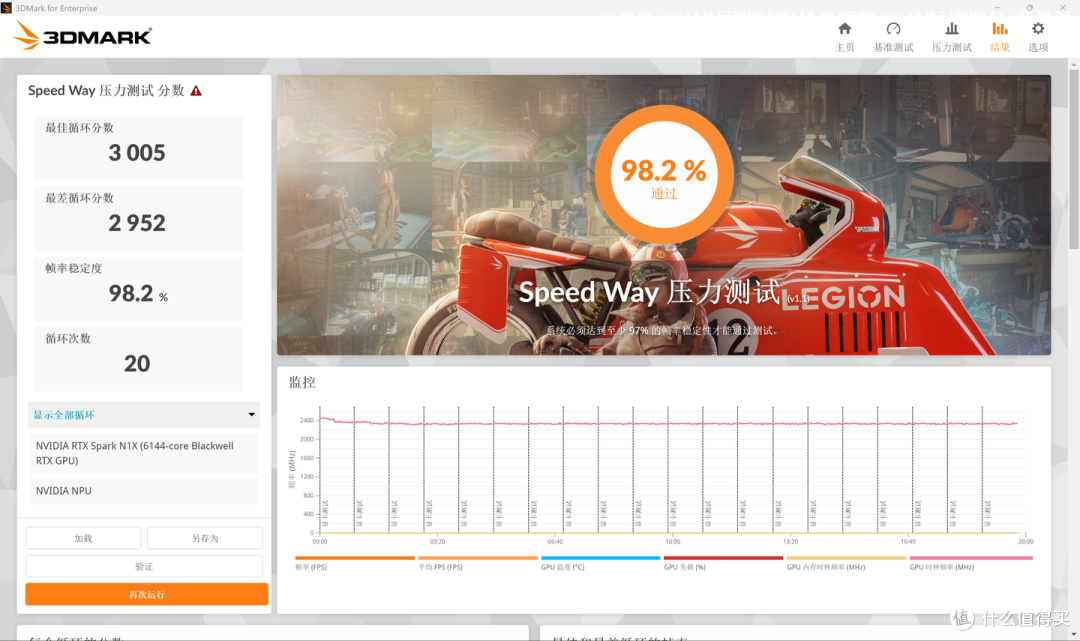
另外我们使用 Speedway 压力测试测试 RTX Spark 的 GPU 性能稳定性,其稳定性为98.2%。
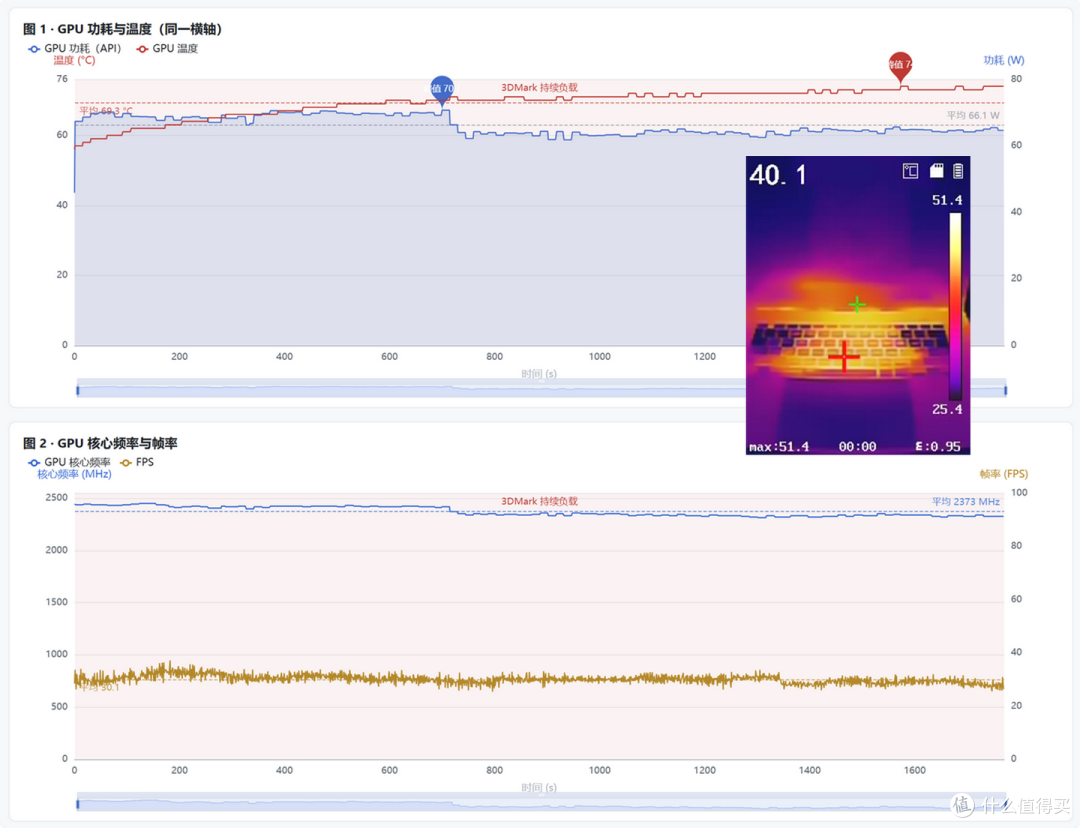
RTX Spark 在前 7 分钟可以维持 70W+ 2.4 GHz 的核心频率稳定运行,超过 7 分钟就会降到 65W 以下,2.3x GHz 的频率。不过这对实际性能影响并不大,20 轮测试中最差轮相比最佳轮性能也只差了 1.8%,实际性能稳定性很不错。之前测试 RTX 5070 跑相同测试是 2.7x GHz 250W,之前经过手机处理器充分验证的TSMC N3P出色能效提升在RTX Spark上又再一次得到了验证。
温度方面 GPU 传感器最高温度为 75 度,而在这个测试 18 轮的时间点,键盘转轴出风口的最高温度为 51 度,而处理器上方的键盘中间温度为 40 度。当然这个是极端 3D 满载的情况,前面运行 Qwen3.8-Flash-Next 时 GPU 负载状态下不到 30 度,实际温度也更低。
游戏性能测试
再来进入实际游戏测试环节,实际游戏场景更多会受到CPU转译的性能影响。本次测试游戏并不多,但测试不会仅仅丢个帧率给你,还会比较细致的性能分析甚至优化建议。
赛博朋克 2077 性能测试
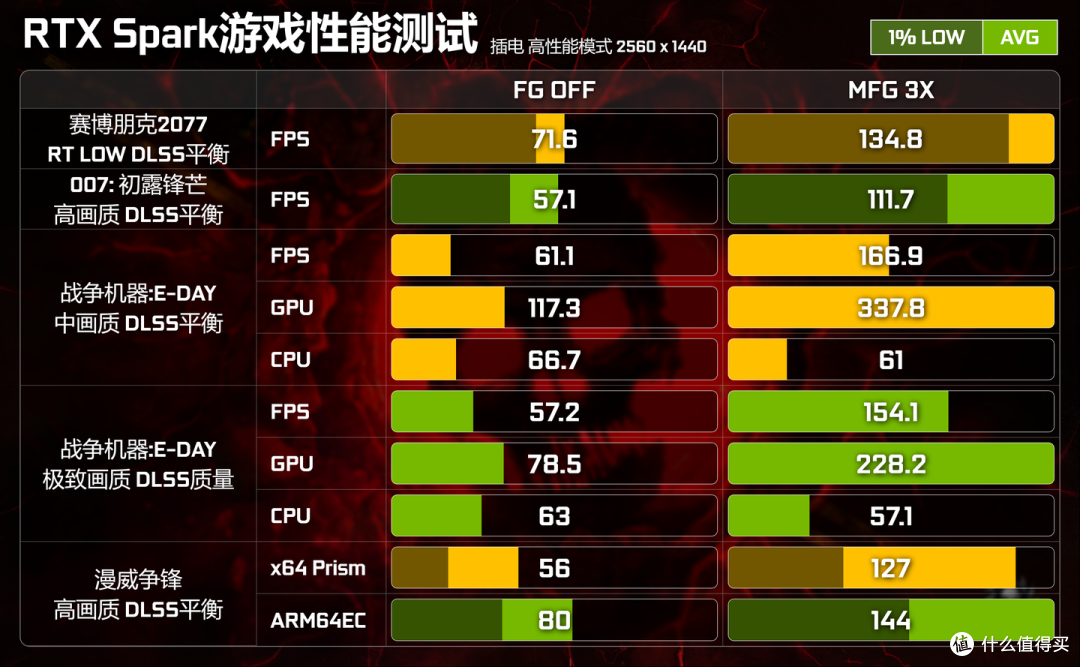
《赛博朋克 2077》 我们设置 RT LOW 画质/2560 x 1440 DLSS 平衡使用游戏自带 benchmark 进行测试,虽然也需要 x64 转译,但 《赛博朋克 2077》本身的 GPU 负载极大,因此GPU基本满载。FG OFF 帧率可以在 60 FPS 以上,开启 3X MFG 的帧率就可以很好满足 120 Hz 高刷的性能需求。
007: 初露锋芒
《007: 初露锋芒》设置 2560 x 1440 DLSS 平衡 高画质 PT OFF,使用第二关开头开车进入城堡的 100 秒场景进行测试,使用 Frameview 记录性能数据。在关闭 FG 的情况下,RTX Spark 的平均帧率为 57.1 FPS,基本流畅,而开启 3X MFG 则可以达到 110 FPS,GPU使用率都在95%左右,没有明显的CPU瓶颈。
战争机器:EDAY 性能测试
《战争机器:EDAY》 我们首先采用 2560 x 1440 DLSS 平衡/中画质进行测试,在 FG OFF 的情况下平均帧率为 61 FPS,EDAY 除了给出 FPS,还给出了具体的 GPU FPS 和 CPU FPS,并有具体的帧数分布图。
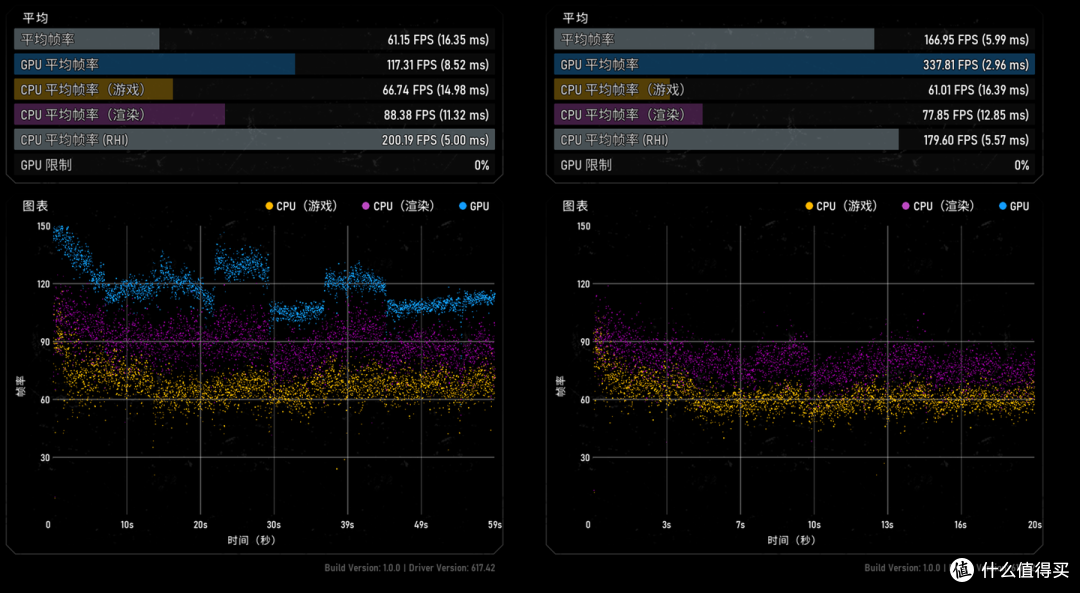
我们发现(左图)蓝色的 GPU FPS 高达 117 FPS,但黄色的 CPU FPS 只有 61 FPS,而游戏实际输出的 FPS 是由 CPU 和 GPU FPS 的下限决定,实际游戏输出的 FPS 也就和 CPU FPS 差不多。测试时候 CPU 由于转译功耗高达 40W,但即使如此性能依然带不起 GPU,GPU 占用率根本跑不起来,功耗也只有 20W。而开 3X 的 MFG 之后,游戏的 GPU FPS 提升到 337 FPS,虽然实际游戏的 FPS 基本还是被限制在 CPU FPS 的三倍,但CPU瓶颈还是缩小了。
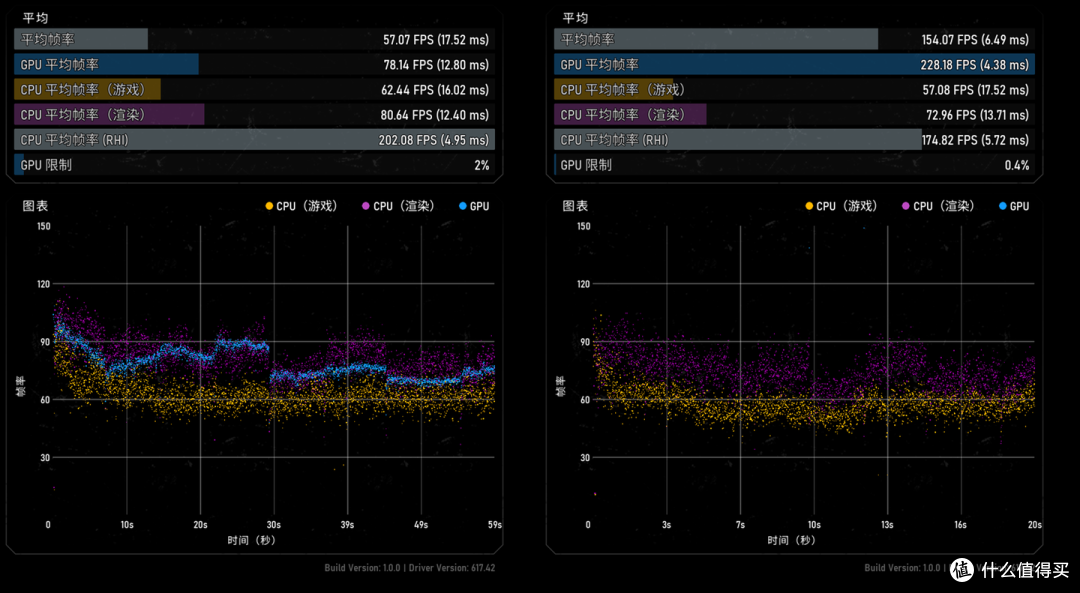
既然 CPU 转译限制了 GPU 性能,那我们将画质提升到 2560 x 1440 DLSS 质量+极致质量。虽然这样蓝色 GPU FPS 就下降到 78 FPS,但也也大大减小了同黄色CPU FPS的间隔,CPU瓶颈被大幅压缩。3X MFG(右图) 的情况也差不多,这样在实际渲染分辨率和画质大幅提高的情况下,实际游戏的帧率基本还是可以保证之前中画质的水平。
这就反映出一个思路,既然当前帧率已经受到CPU侧限制,就可以尝试提高画质,把闲着的GPU性能用起来。这次测试里,提高渲染分辨率和画质后,实际帧率没有明显下降,换来了更好的画面。。对于 3A 而言,N1X 的图形性能其实是很容易满载的。
漫威争锋性能测试
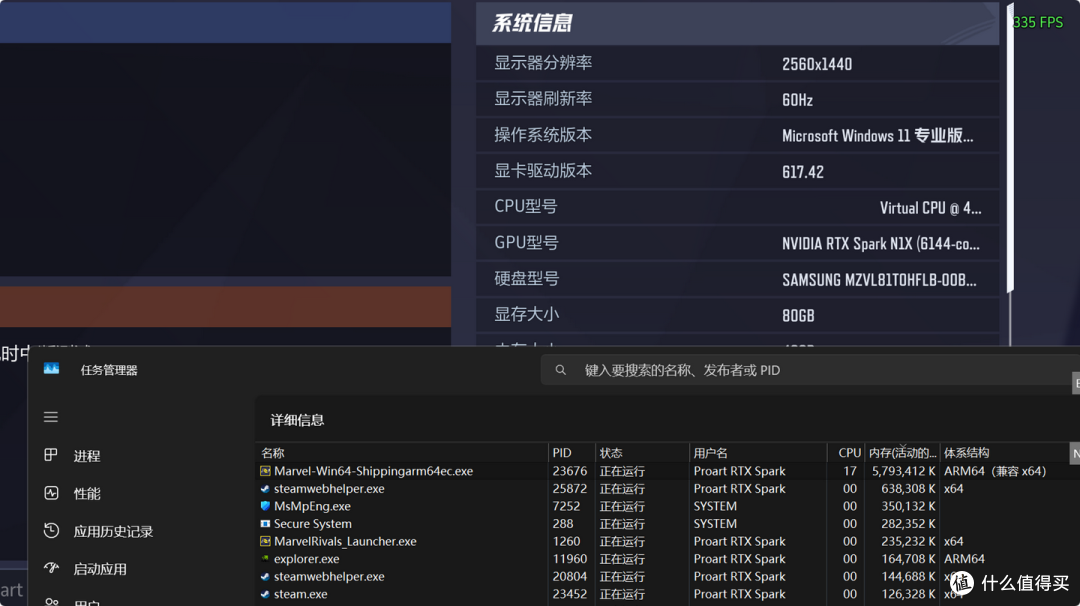
再来看看偏电竞的《漫威争锋》,目前官方提供了 ARM64 的内部测试版。不过需要注意的是我们在任务管理器里看见体系架构并不是 ARM64,而是 ARM64(兼容 x64),前面的进程文件名是 arm64ec 结尾,这说明漫威争锋并不是原生的 ARM64,而是 ARM64EC。
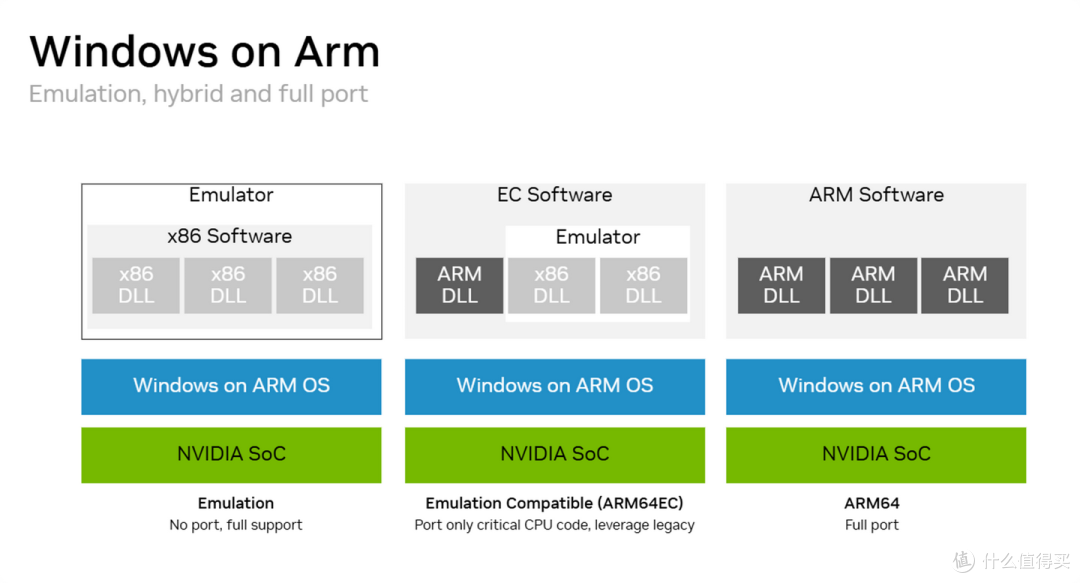
ARM64EC 其实是一种过渡方案,其将现有程序的移植 ARM64 的性能关键型代码,同时保留传统的 x86 依赖项,这样使得一个 EXE 能够同时支持 ARM64 和 X64 的 Windows环境运行,维护和分发都简单很多,最典型的 Office 2024 就是这样。当然这样的便利也是需要付出代价的:ARM64EC 不能调用所有寄存器,其在性能上相比原生 ARM64 还是有一定的损失。
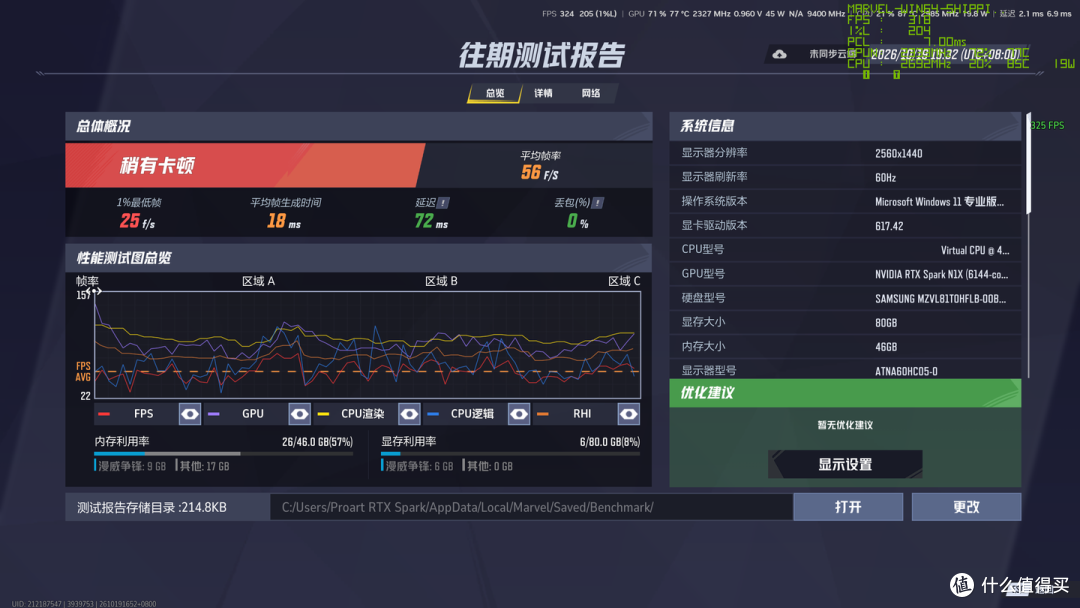
先看RTX Spark在x64版本《漫威争锋》 2560 x 1440 DLSS 性能 高画质的性能,平均 FPS 仅为 56 FPS,最低 FPS 仅为 25 FPS,这性能完全不能玩。曲线图部分红色的 FPS 值一直被蓝色的 CPU 逻辑压着,距离紫色的 GPU 曲线相距甚远,这是明显的 CPU 瓶颈。
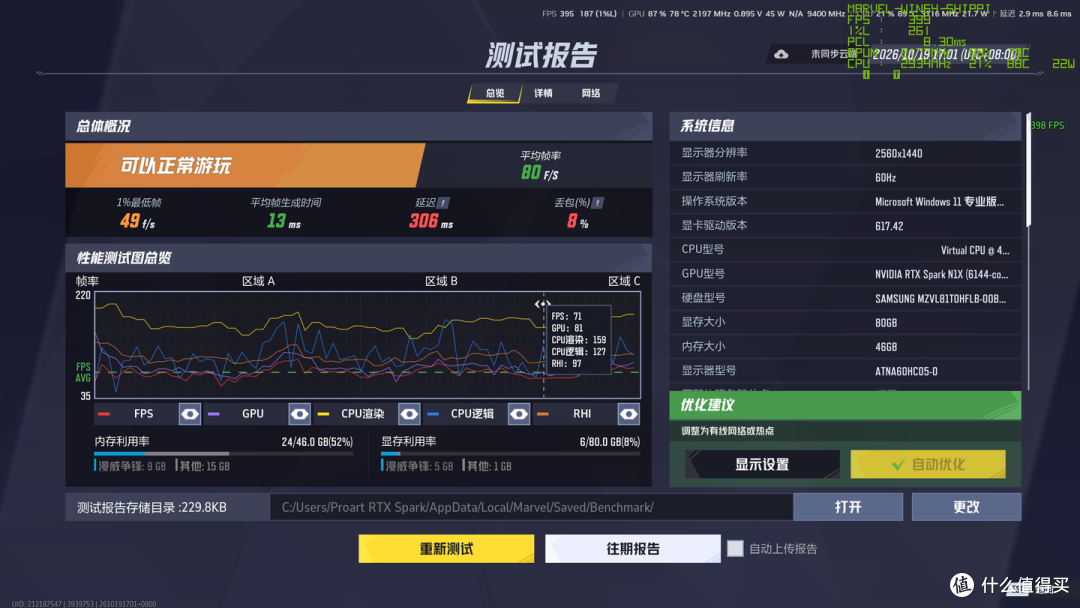
而使用 ARM64EC 的版本,平均 FPS 从 56 提升到 80 FPS,蓝色的 CPU 逻辑整体明显高于紫色的 GPU 曲线,此时性能瓶颈转向 GPU。
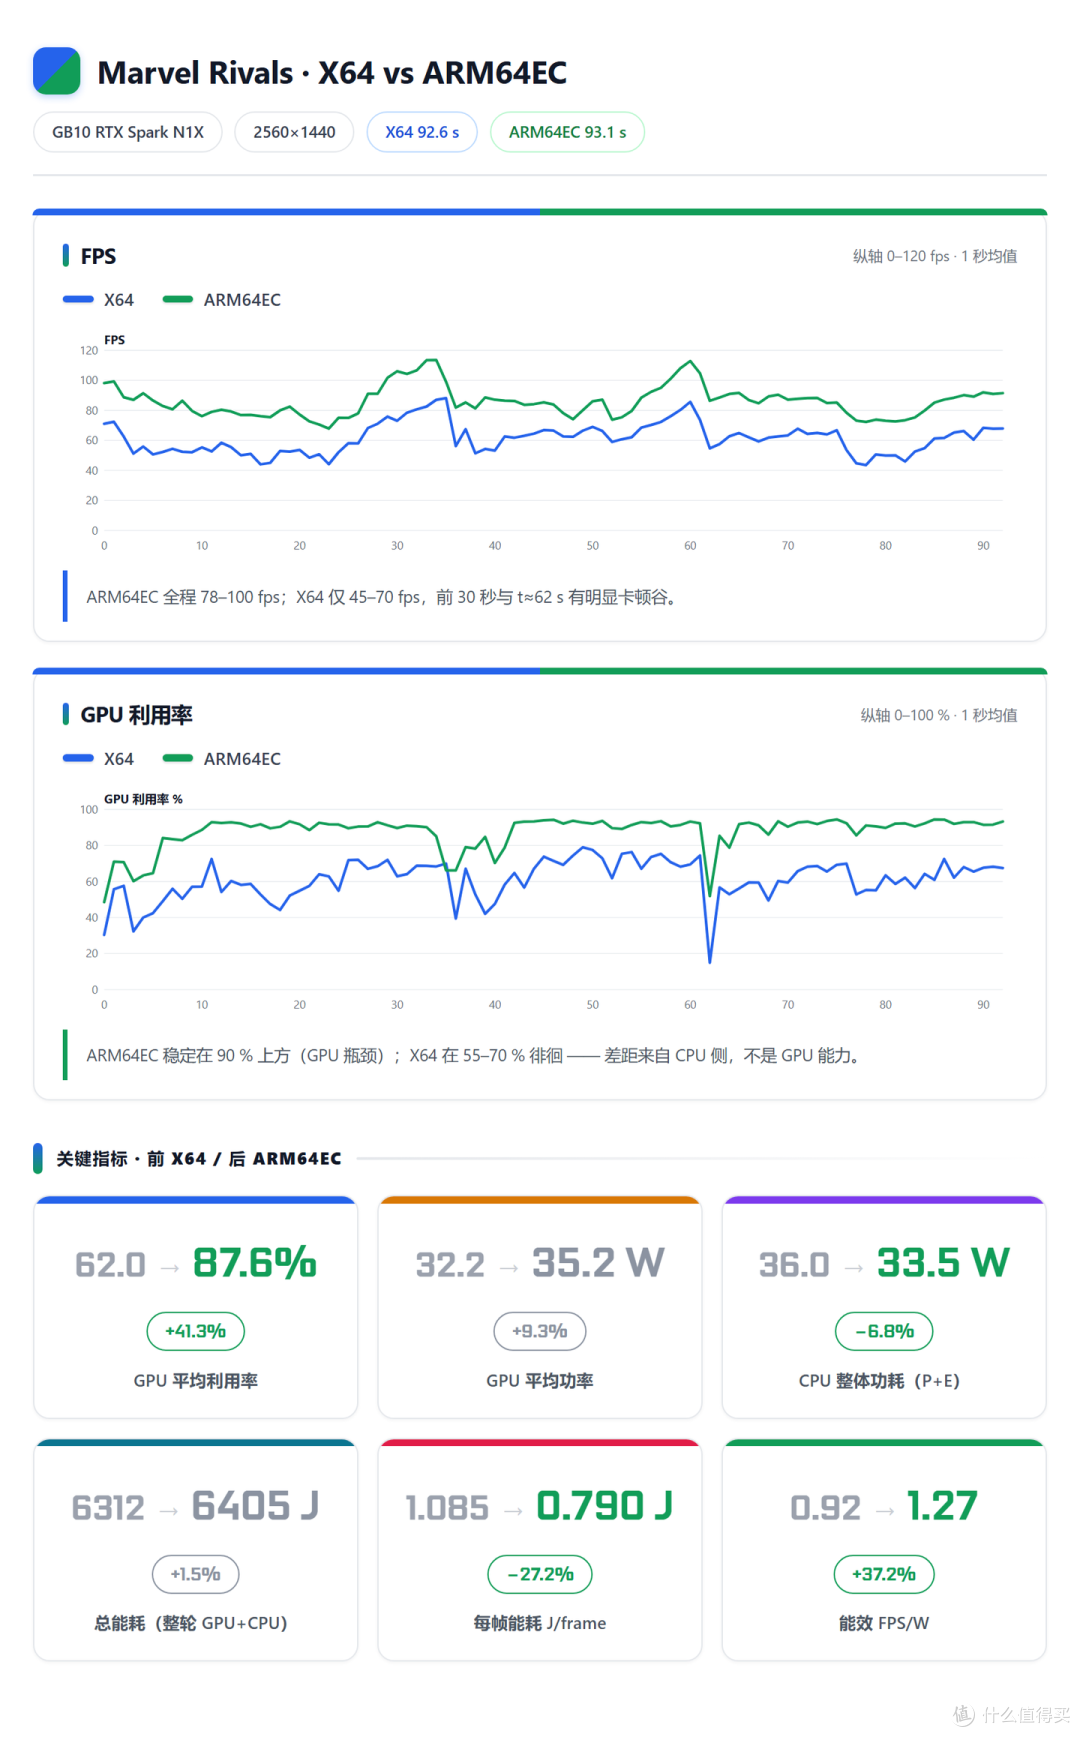
我们使用Frameview抓取了这2组测试的性能数据,对比分析发现ARM64EC 相比 x64 转译,GPU 使用率从 62% 提升到 87.6%,CPU 功耗下降 3W 而 GPU 功耗上升 3W,每 W 性能提升了 37%。
而在开启MFG 3X后,X64转译虽然平均帧率来到了127 FPS,大幅缓解了CPU性能瓶颈,但1% LOW依然难看,而ARM64EC版本144 FPS的帧数也开始电竞起来了。
对于联机游戏来说,兼容性的一个重要瓶颈在于反作弊的适配。目前如战争雷霆/CS2/ARC/逆水寒/原神的反作弊都完成了适配,但 PUBG/现代战争 4/还有腾讯系的 ACE 都还在适配中。
其实对于游戏开发商而言增加一套适配并不是一次性工作的问题,而是需要长期适配,增加一个系统支持就基本等于不少环节的工作量都需要翻番。目前大多数游戏都只支持 Windows X86/X64,绝大部分都连 macOS 都不支持。支持新系统需要有足够的用户规模带来足够利益,游戏开发者才有足够动力去持续维护,这个转变的过程需要坚持,而不是一蹴而就。
本地模型跑得好,还得是一台好用的Windows电脑
RTX Spark最鲜明的硬件特点,是128GB统一内存与RTX计算能力的组合。前面的测试已经说明,这份容量的用途远不止装下模型权重:长上下文、投机解码、视觉模块,都需要额外空间。内存宽裕以后,部署时就不用为了省出几GB反复取舍。但容量不能替代速度,在本轮生图、生视频测试中,只要模型能装进消费级显卡,更大的GPU规模和更高的带宽往往更有优势。这台机器的钱花得值不值,要看你每天拿它做什么。
同样运行本地大模型,RTX Spark与DGX Spark的硬件基础相近,但取舍不同。DGX Spark的GPU功耗额度更高,RTX Spark则把内存带宽从273GB/s提高到了300GB/s。前面的测试里,部分大语言模型(LLM)任务远没有吃满GPU功耗,解码速度却明显受带宽影响。因此,不能只看140W和85W,就判断两台机器跑模型时会拉开同样比例的差距。模型结构、量化方式和推理后端,都会改变结果。
真正部署起来,软件环境的差别更值得关心。DGX Spark运行Linux,更方便沿用服务器上的推理工具和部署方式;需要多人调用、持续提供模型服务时,vLLM这类后端的并发能力也更重要。RTX Spark这轮则主要使用llama.cpp,围绕一台Windows笔记本完成模型部署,再把推理服务接入实际工作软件。前者更接近办公室里供大家调用的一台计算设备,后者就在使用者手边,连同文件、应用和日常操作一起承担下来。具体选哪种,还得看软件支持和工作安排。
这也让Windows on Arm的兼容性变得格外重要。身边几个同事听说这台笔记本是Arm架构,第一反应都是怀疑。直到我当面打开几个常用的x64软件,看到它们正常运行,大家才放心了不少。这个顾虑很实际:换电脑可以,原来的工作不能因此停下来。
从这轮使用和测试看,常用软件通过Prism转译,已经能满足不少日常任务。但“能打开”和“性能充分发挥”仍然有区别。前面的Blender、x265测试就显示,涉及SSE、AVX等向量指令的负载,转译损失会明显放大;游戏里也能看到,CPU转译效率会影响GPU能否跑满。到了这些场景,原生Arm版本、ARM64EC适配,以及软件能否正确调用GPU,就会实实在在地改变体验。
所以,我不会因为几个程序运行顺畅,就把兼容性一句带过;也不会因为某项转译测试掉速,就否定整台机器。日常要用的软件、插件、驱动和外设,应当放进自己的工作流程里检查。能用原生版本就优先用原生版本,适合GPU的任务交给GPU,遇到缺少适配的环节,再判断有没有可接受的替代办法。智能体可以协助部署和排查,但产品最终还是得让这些工作顺畅地接起来。
我重新对Windows产生兴趣,正是因为这台电脑开始接住了我原来的工作:模型可以在本地,也可以调用云端;公司的资料、业务软件和文件操作,则由智能体组织起来继续执行。下篇的测试进一步说明,RTX Spark在哪些任务上有优势,哪些地方仍然受带宽和适配限制。对于一台每天要带着走、打开就要干活的笔记本,这些都和模型速度一样重要。接下来,才轮到华硕的屏幕、接口、散热和续航回答:这套平台究竟被做成了一台怎样的电脑。
再来看图形性能和游戏表现。RTX Spark 的 GPU 拥有 6144 个流处理器,核心规模非常接近桌面端的 RTX 5070;但受限于 85W TGP 和 300 GB/s 的内存带宽,实际表现反而更接近只有 4608 个流处理器的 RTX 5070 Laptop。显然,RTX Spark 走的是“以规模换能效”的路子,用更大的流处理规模换取相对低频,再加上台积电 3nm 工艺这样就可以大幅提升能效比。
当然,上面说的只是 3DMark 这类纯理论图形跑分,落到实际游戏里,指令转译依然是一道坎。跑《赛博朋克 2077》这种重度压榨显卡的 3A 大作问题不大,毕竟高画质下的瓶颈完全在 GPU 规模和带宽上。但到了显卡负载较轻、但又吃 CPU 帧率上限的电竞和网游里,转译带来的效率折损就成了大问题。这类电竞游戏就算搞定了反作弊驱动认证,也必须得有原生 ARM64 客户端,才能跑出真正能打的电竞帧率。
对于WoA原生游戏支持其实是个先有鸡还是先有蛋的问题:玩家在等生态完善才敢买,但游戏开发者又在等用户规模起来才会主动投入。这样两难的境地这个时候就需要有人推一把,而英伟达现在就在做这个事情,就跟其在20年前推The Way Its Meant to Be Played所做一样。
测到这里,RTX Spark的长处和取舍已经很清楚了。128GB统一内存,让它在本地模型的选择、上下文容量和加速配置上有了相当大的余地;RTX和CUDA,则让这些能力能够接入已有的计算工具。但300GB/s的带宽和笔记本的功耗条件,也决定了它不会在每一种任务里都跑赢传统独显。前面生图、生视频和游戏的成绩,已经把这些差别摆出来了。
怎么买,就看这些差别对你的工作意味着什么。如果你经常需要较大的本地模型,同时还要使用Windows软件、处理业务资料,希望带着一台电脑就能继续工作,RTX Spark确实提供了一种很有吸引力的组合。如果主要追求游戏帧率,或者生图、生视频的完成速度,同样的预算就应该认真比较传统独显方案。至于主要调用云端API、现有电脑已经足够顺畅的用户,也不必为了智能体这个名字重新买单。
我在上篇强调的核心,是Windows终于开始承接我已经习惯的Agent工作方式。下篇测完以后,我更清楚这套硬件能为它增加什么:本地模型有更大的部署空间,计算任务可以使用RTX加速,原来的应用和资料也能继续参与工作。遇到本地不适合的任务,就调用云端,文件处理和工具执行仍然在这台电脑上继续。设备的价值,要放在这整套工作里判断。
所以,日常应用和整机体验当然不能算“添头”。既然要把它当作主力电脑,屏幕看着舒不舒服、接口够不够、风扇吵不吵、离开电源能工作多久,都直接影响我愿不愿意每天用它。
华硕 ProArt 创16 RTX Spark笔记本赏析
如果你不是RTX Spark 的目标用户,你看到这里就应该看完了,但你真的是目标用户准备掏钱买,那就需要了解,接下来我们会为你介绍本次的测试平台,华硕 ProArt 创16 RTX Spark,主要聚焦于工业设计/屏幕素质和续航这些偏外围方面。
首先,华硕 ProArt 创16 RTX Spark的屏幕是我见过规格最顶的 Windows 设备屏幕,没有之一。
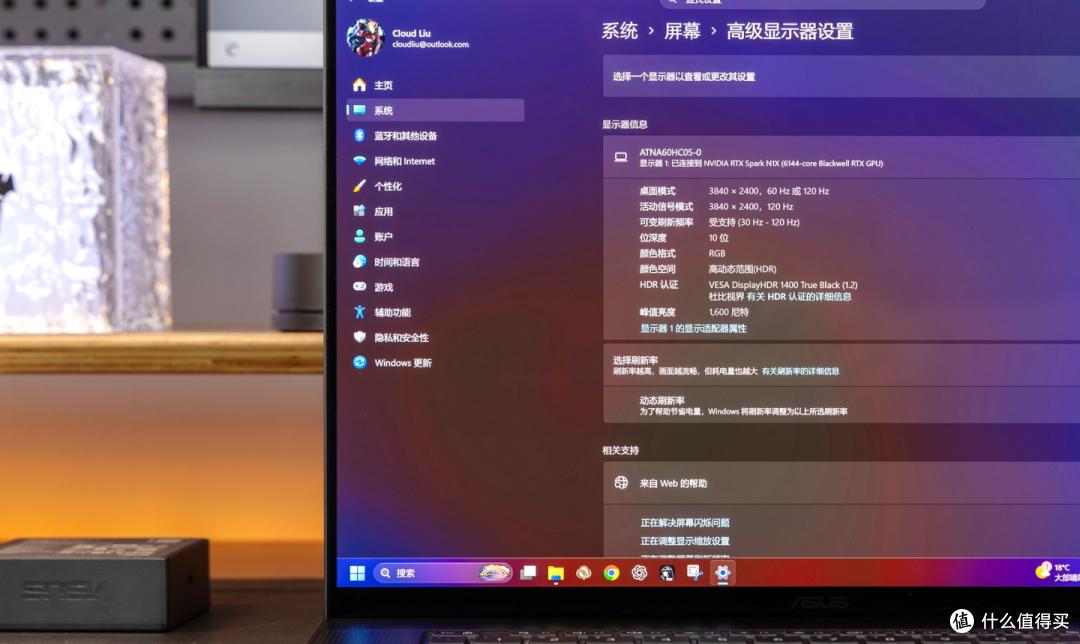
16 英寸/16:10 的 OLED 面板,刚到手开机时我下意识以为又是常规的 2560×1600。直到亮屏那一刻,看着字体内敛细腻的边缘,直觉告诉我有点不对劲。右键点开显示设置一看,3840×2400 的 4K+ 分辨率赫然在列,确实让我有点惊掉下巴。然而这个惊喜仅仅只是前菜,这块面板真正的压轴好戏还在后头。
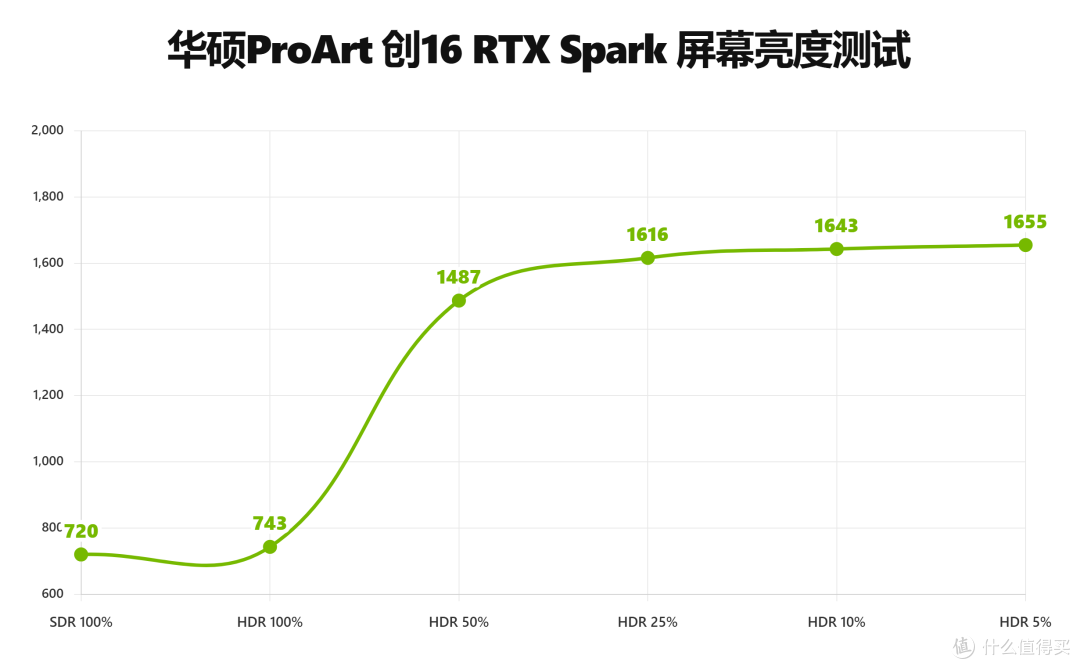
当我把 华硕 ProArt 创16 RTX Spark 放在我的 QD-OLED 显示器旁边的时候,明显感觉它的画面要通透亮堂得多,跟我那台第三代 QD 全屏 250 nit 左右的表现完全不在一个层级。掏出亮度计实测:华硕 ProArt 创16 RTX Spark 的 SDR 全屏持续亮度高达 720 nit;切到 HDR 模式后,全屏亮度还能进一步拔高到 743 nit。要知道目前桌面顶级的 ROG PG32UCDM 等机型,全屏持续亮度普遍也就在 300 nit 上下徘徊,华硕 ProArt 创16 RTX Spark的亮度输出直接翻番还转了个弯。到了 50% 到 10% 的窗口面积,它的局部亮度更是直接飙到 14xx ~ 16xx nit 的水准,如果测更极端的超小窗口,摸过 1700 nit 大关完全没有悬念。
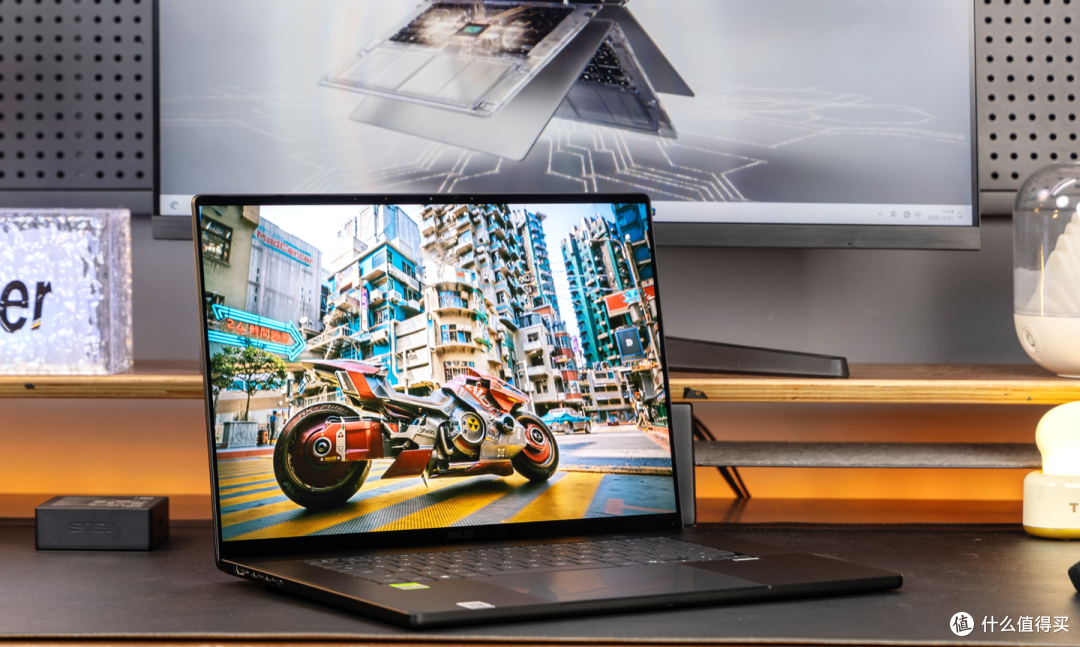
这块屏幕的
亮度冗余给得太足,以至于再去放拉斯维加斯夜景那种大面积暗场的传统 OLED 演示片,多少有点大材小用。直接拉进《赛博朋克 2077》正午艳阳高照的夜之城街头,那种扑面而来的高光冲击力极其过瘾,正面硬碰旗舰 Mini-LED 都不带虚的。
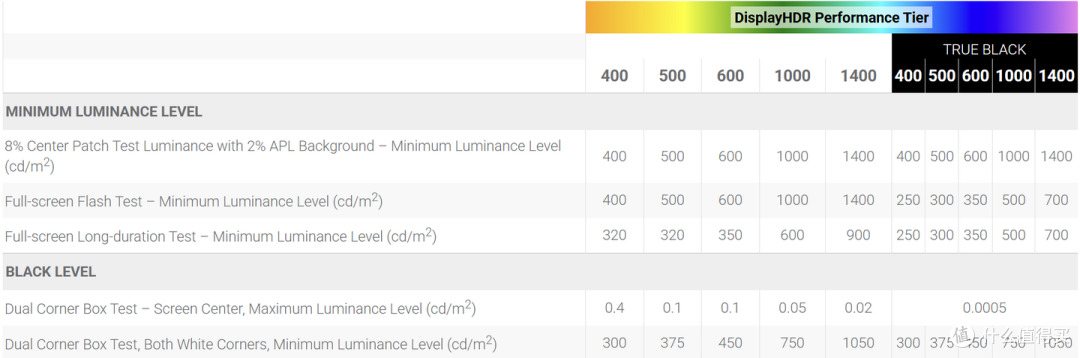
至于画面为什么能有这么强的冲击力,直到我在系统 HDR 设置里瞥见 VESA DisplayHDR True Black 1400 的认证标识才恍然大悟。要拿下这个认证,不仅要守住极致纯黑的底线,还必须同时达成极其苛‘;的“全屏 700 nit、2% APL 窗口 1400 nit”亮度硬指标。要知道目前桌面端 OLED 显示器普遍也就停留在 TB500 级别。当初刚看到 VESA 公布 True Black 1400 标准时,我还纳闷这变态规格市面上根本没产品做得到,立个空头支票不知道图啥。直到今天把机器摆在眼前实测,我才彻底回过神来:合着这个标准,根本就是冲着 华硕 ProArt 创16 RTX Spark 这块屏量身定做的啊。
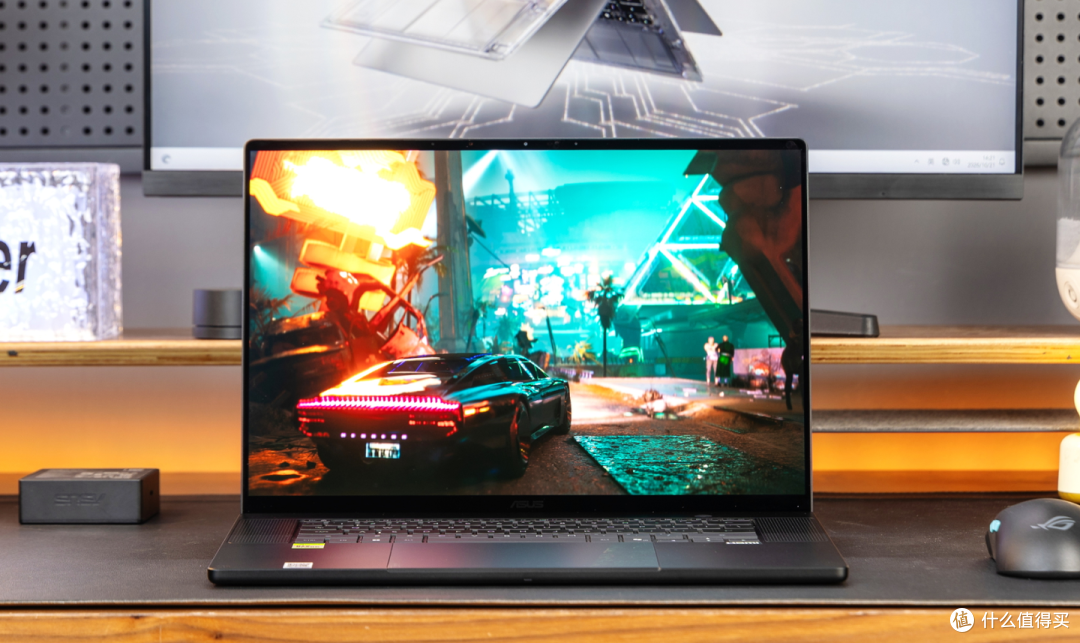
再看《赛博朋克 2077》更为典型的夜场场景,这更是 OLED 毫无争议的绝对舒适区。小区块霓虹招牌的1600 nit级别的高峰值亮度,配上 True Black 级别深不见底的纯黑背景,画面的视觉张力极为震撼。狗镇街头橘红灯箱、青绿金字塔与猩红车尾灯交织,小区块峰值拉满的高光极具冲击力。得益于出色的色彩宽容度,高光完全没有发白失真;配合 OLED 纯黑背景剥离出的暗部残骸与路面碎石,极致反差将狗镇破败与混乱的赛博朋克颓废感拉到了极致。
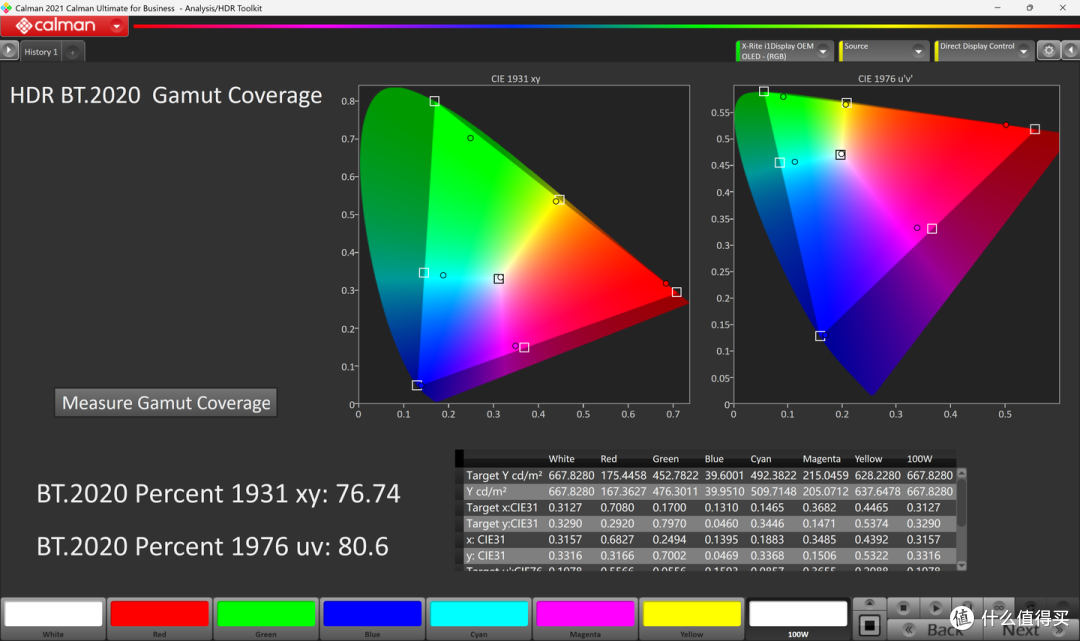
再来看看色域覆盖。官网标称的“100% DCI-P3 覆盖”,这个说法就好比“我和马斯克都能吃饱饭”一样缺乏区分度,放在顶级 OLED 面板上完全体现不出真实成色。于是我使用 Calman 直接测试 华硕 ProArt 创16 RTX Spark 的 BT.2020 色域覆盖,其在 HDR 下可以覆盖 80.6% 的 BT.2020 色域,这个水平比 WOLED 四代好点,和 最新的QDOLED 四代水平基本相当。
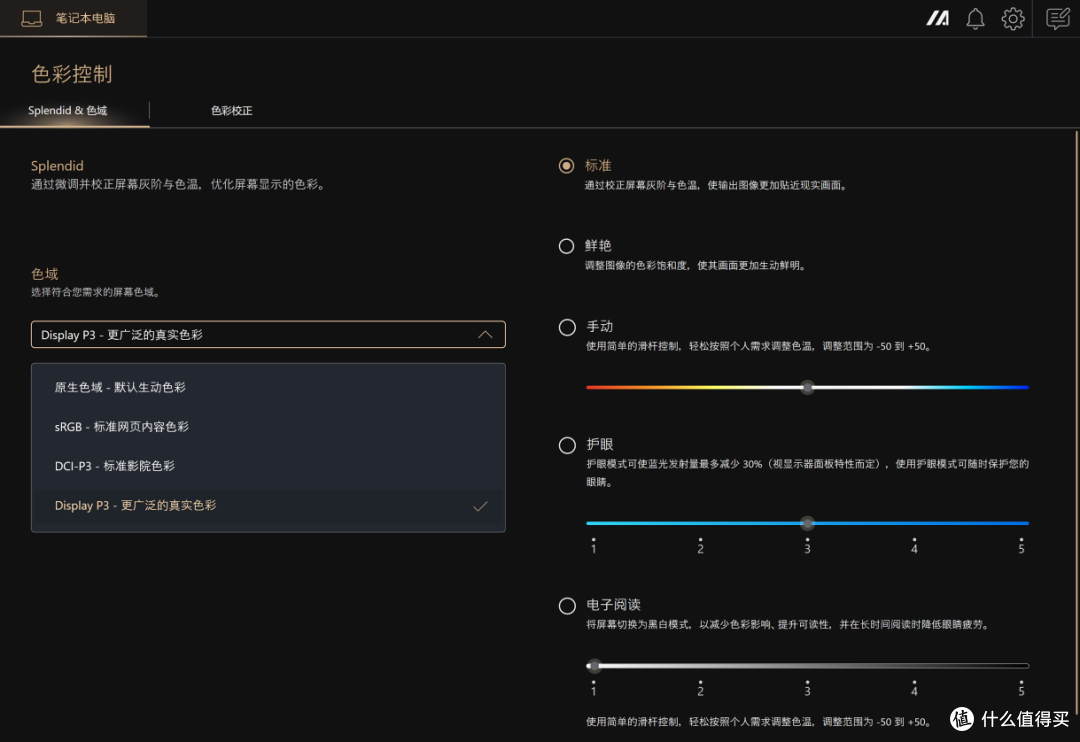
当然,色域覆盖也并不总是越广越好,日常主流内容绝大多数还是基于 P3 和 sRGB 色域制作。除了依赖 Win11 自带的自动色彩管理(ACM),用户也可以直接在 ProArt Creator Hub 里面手动切换目标色域。
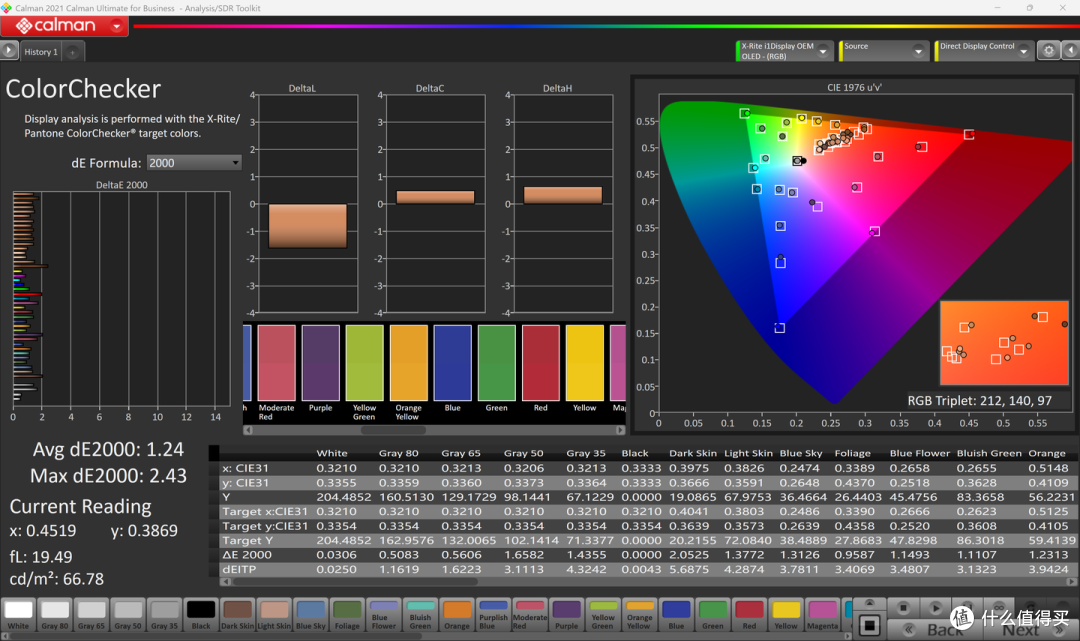
在 200 nit 亮度下实测 华硕 ProArt 创16 RTX Spark 的 sRGB / BT.709 色准,其平均
控制在接近 1 的水平,基本达到了专业参考级监显的门槛。
集齐了 4K+ 高分、峰值破千的高亮度、顶格色域以及出厂级精准色准,无论是拿来给 10-bit Log 视频拉曲线调色、精修高宽容度的 RAW 原片,还是纯粹看一场高动态 HDR 大片,这块屏幕带来的视觉冲击力都足够通透饱满。此外它还附带了触控功能,虽然 Windows 桌面生态除了 Xbox 和应用商店等少数界面外对触屏并不友好,但出门在外偶尔忘带鼠标或者其他不方便用鼠标的情况下应应急,也还是不错的备选选择。
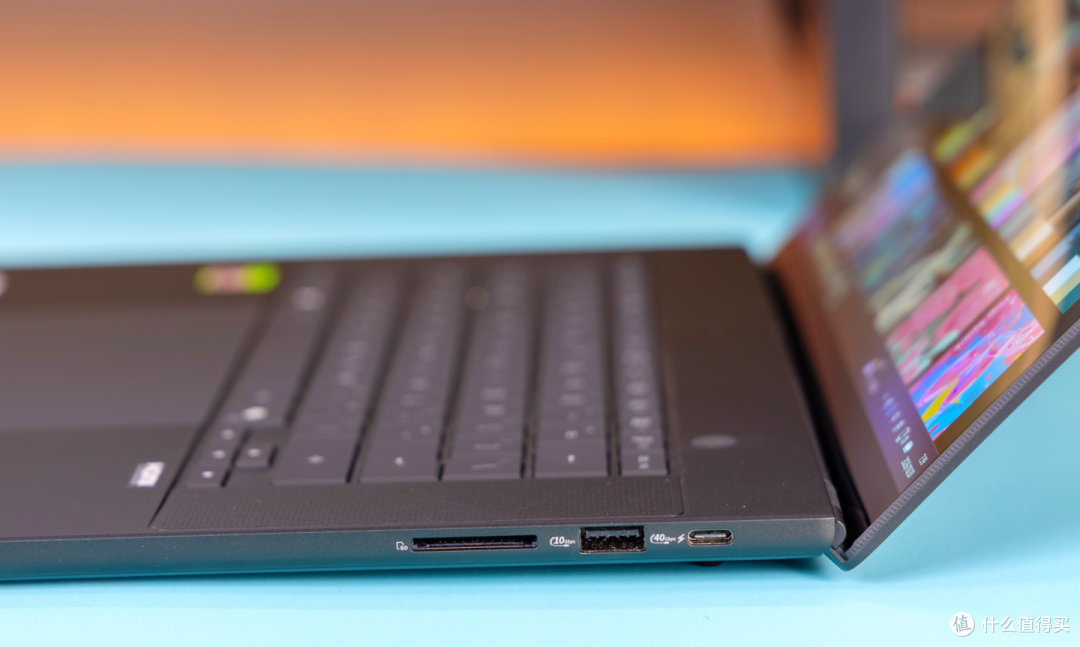
在接口配置方面,华硕 ProArt 创16 RTX Spark 机身右侧配了一组 40Gbps 的 USB Type-C 和一组 10Gbps 的 Type-A,外加一个全尺寸 SD 读卡器。华硕在自家台式机主板和 ProArt 笔记本上的标识很省心,端口旁直接明明白白标出 10、20、40 这种实际速率,不用用户费脑子去猜那些混乱又难懂的 USB 版本代数,这的确是好文明。
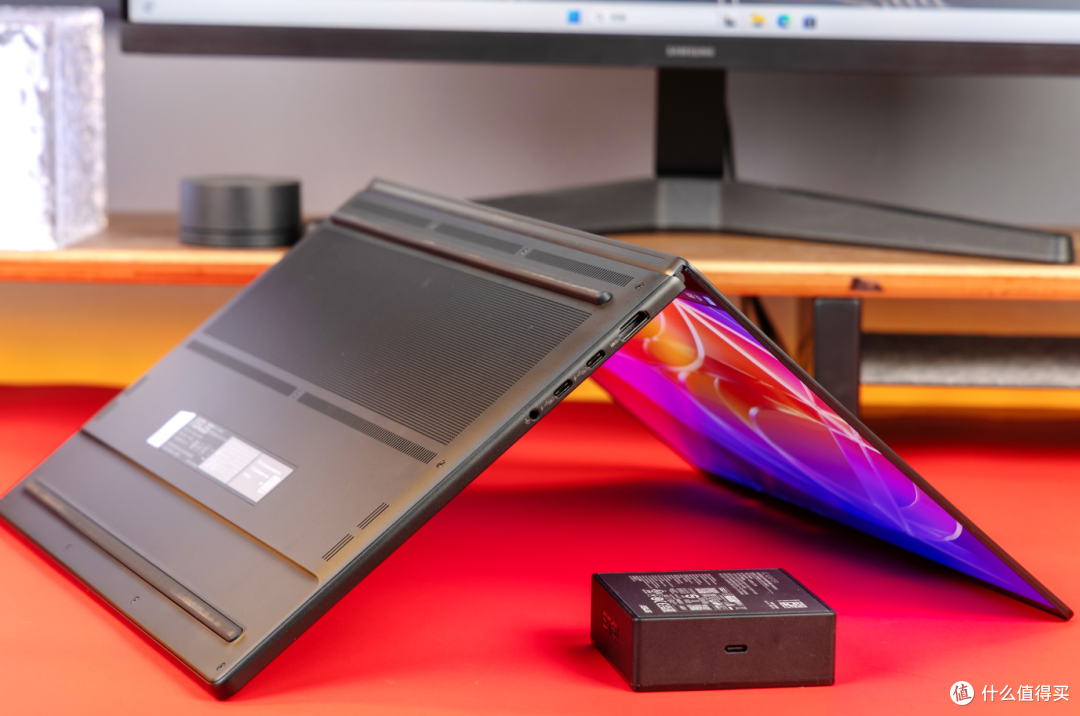
机身左侧则给到了另外两组 40Gbps 的 USB Type-C、一个 HDMI 2.1 视频输出口以及 3.5mm 音频接口。附带的原装电源适配器规格为最高 28V/5A(140W),体积控制得相当克制便携;同时它还支持最高 21V/5A 的 PPS2 快速充电协议,对于第三方的设备也有不错的兼容性。充电功率峰值功率可以达到135W,而稳定供电功率也在105-110W区间。
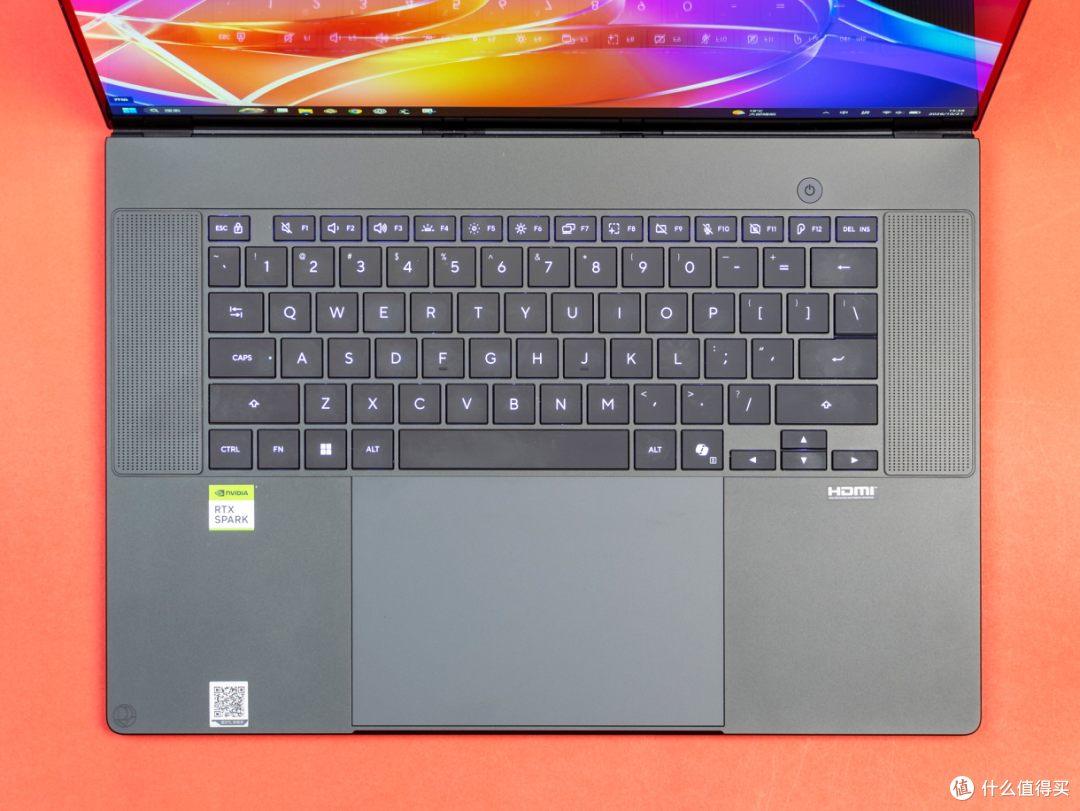
ProArt虽然是16英寸,但并没有配备数字键盘,而在两边布置了更大单元的扬声器。我台式机平时都用87配列键盘,这样的布局对于我来说我反而更习惯。键盘下方的触摸板也是超大,但由于华硕 ProArt 创16 RTX Spark有触摸屏,按我的个人习惯就很少使用触摸板了。
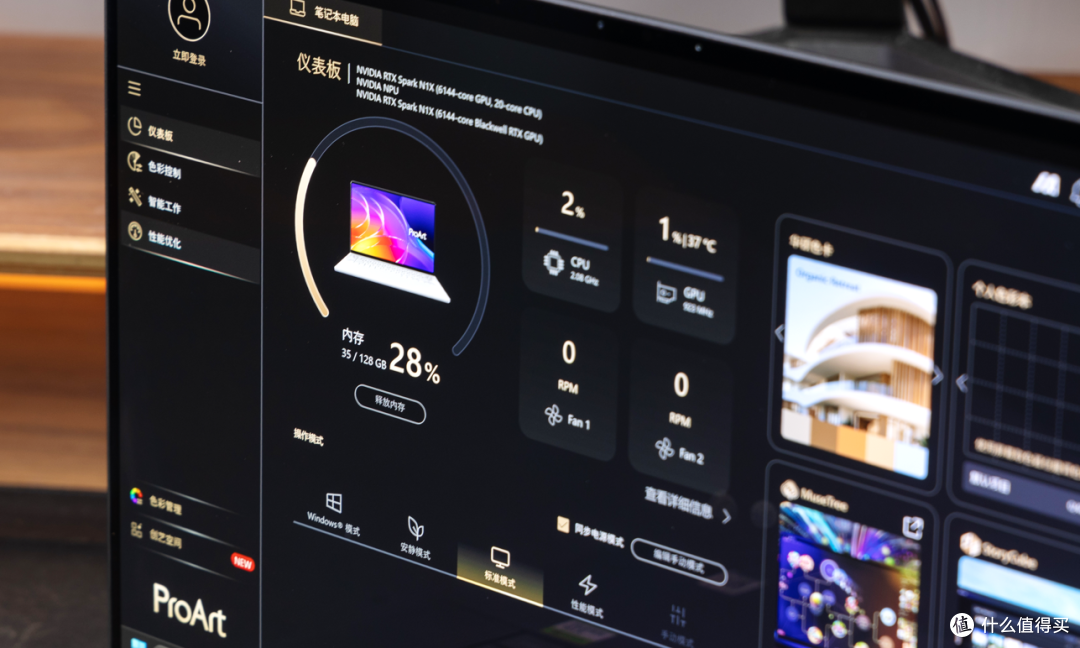
华硕 ProArt 创16 RTX Spark 预装了系列独有的 ProArt Creator Hub,其功能和奥创类似也有性能面板和调节功能,我们可以注意到华硕 ProArt 创16 RTX Spark在轻载待机可以做到完全停转。虽然 x64 笔记本也有些支持停转,但大多集中在轻薄便携本,并且后台稍有动静风扇就呼呼的转起来,ARM 架构的处理器背景功耗更低,而 N1X GPU 待机也就 2W 水平,待机的风扇停转的时间还是会更长。而即使是轻载,风扇也会维持相对温柔的转速。
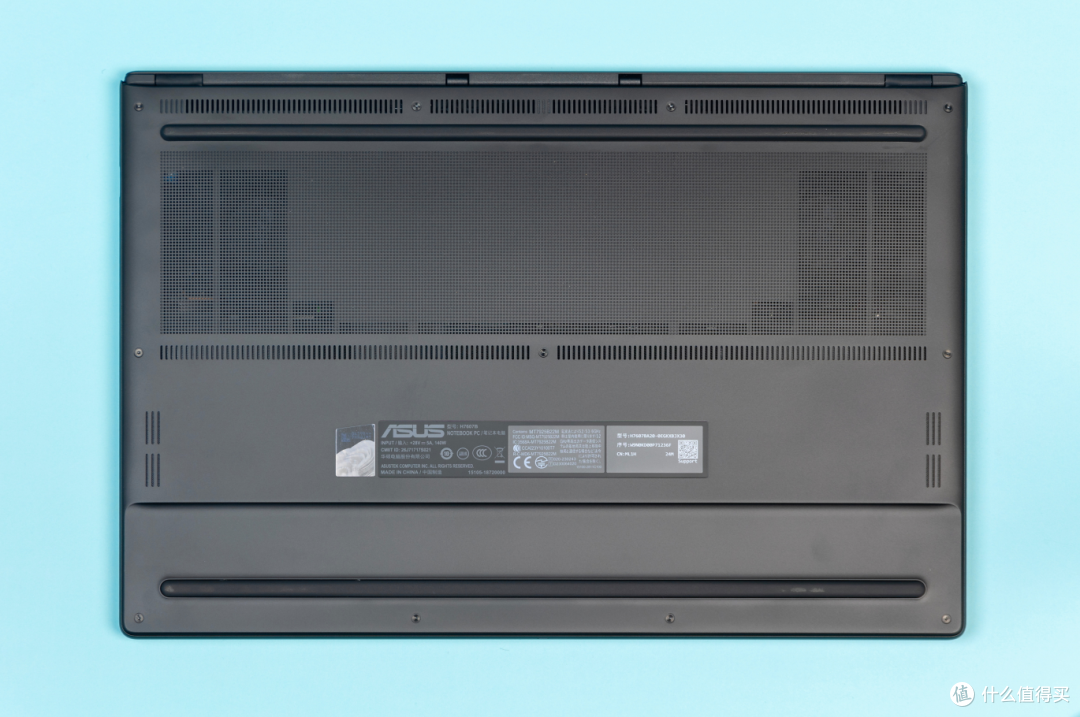
华硕 ProArt 创16 RTX Spark由于使用的是下沉式屏幕转轴,主要的出风口在D面靠后的位置。从标签看,华硕 ProArt 创16 RTX Spark配置的是99 Wh容量的电池,这个容量是国内外允许无需特殊报备带上飞机的电池容量上限。续航方面我们使用UL Procyon Battery Life Benchmark续航测试进行测试,这个测试不同于之前的PCMARK是模拟操作环境,而是直接调用真实的Office软件进行多任务操作来测试续航,更为贴近实际的使用场景。具体测试我设置的均衡性能模式/200 nit屏幕亮度/开启Wifi蓝牙,使用Office 2024专业版进行测试。
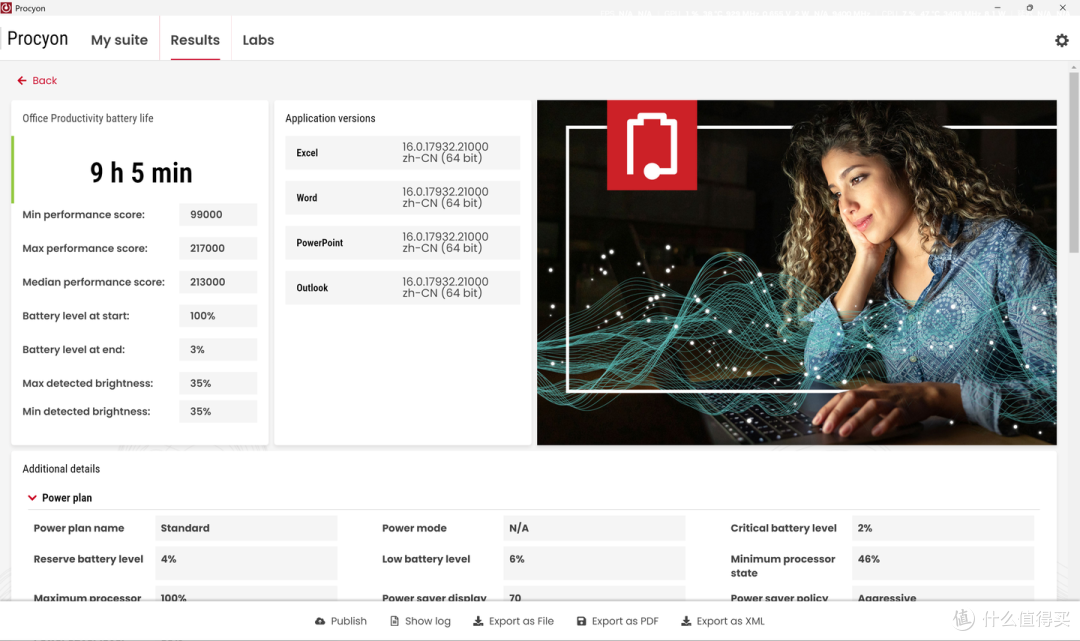
华硕 ProArt 创16 RTX Spark测试续航时间为9小时5分,并且这个测试不仅有续航测试时间,还有性能评分,华硕 ProArt 创16 RTX Spark的中位性能得分为213,000分。由于这是我第一次测试这个项目,缺乏之前积累作为对比数据。可能是由于这个测试软件也过于昂贵,网上使用的媒体和KOL也很少,这次就当做个数据积累吧。
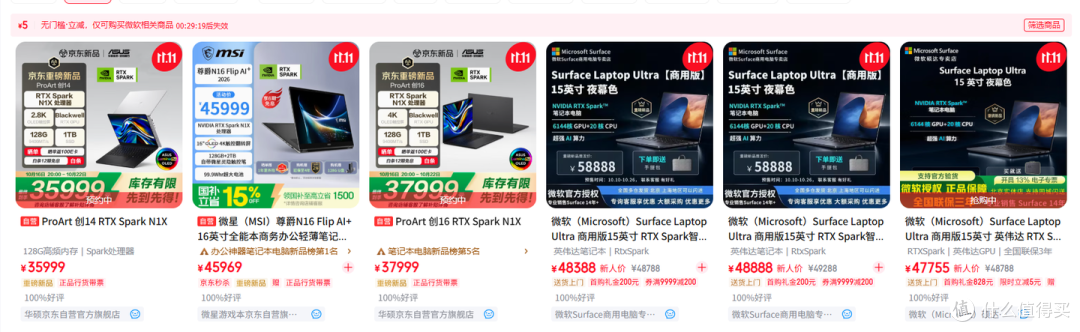
目前RTX Spark 128GB京东自营售价为35999元起,华硕 ProArt 创16 RTX Spark在其中销量最高,目前售罄处于预定抢购状态。如果你在需求方面的确打算购置一台RTX Spark笔记本,华硕 ProArt 创16 RTX Spark凭借顶级的DisplayHDR True Black 1400 3840x2400的屏幕,拉满99 Wh的超大容量电池和合适的价格,再综合前面测试不错的性能释放和散热表现,应该是目前最值得购买的RTX Spark笔记本。
当然,如果你觉得16英寸的尺寸偏大不方便,ProArt还有14英寸的P14可供选择,也是同价。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~









