桌上放着一只杯子。人要把它拿起来,眼睛先找到杯身,再找到把手,手才伸过去。
机器人做同一件事,顺序却常常是反的:先学怎么动,再在动作数据里顺便学怎么看。
小鹏和几所高校刚发布的 GroundingPI,想把这个顺序掰回来——先把“看准”练好,再谈动手。
11月4日,小鹏集团联合北京大学、香港大学等团队发布了这个约40亿参数的具身感知基座模型。IT之家知乎
官方口径很直接:在34项公开感知基准的综合评测中排第一。
具体分数是73.68%,对比对象是GPT-6 Astra的71.54%——后者的参数量远超它。知乎
评测覆盖检测、指代定位、OCR、GUI定位、布局理解等11类能力。
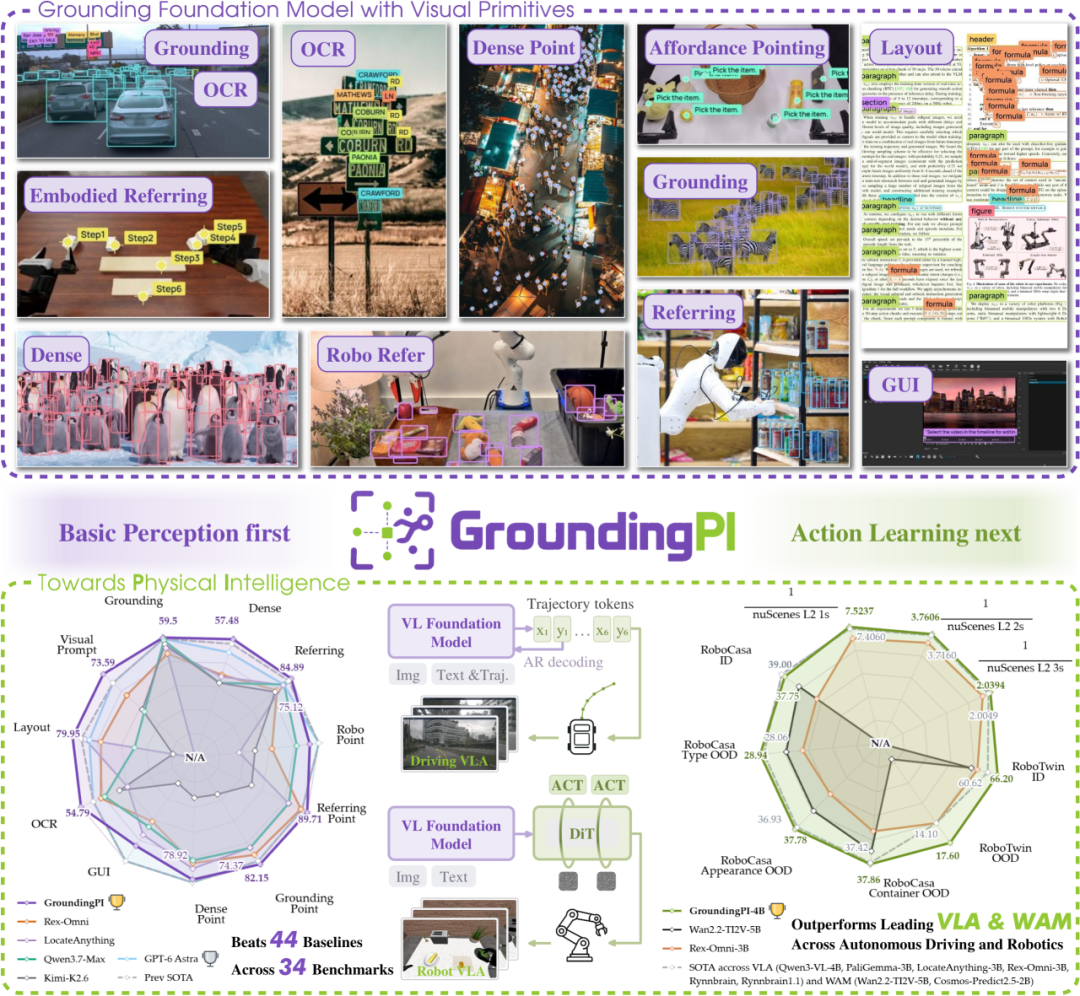
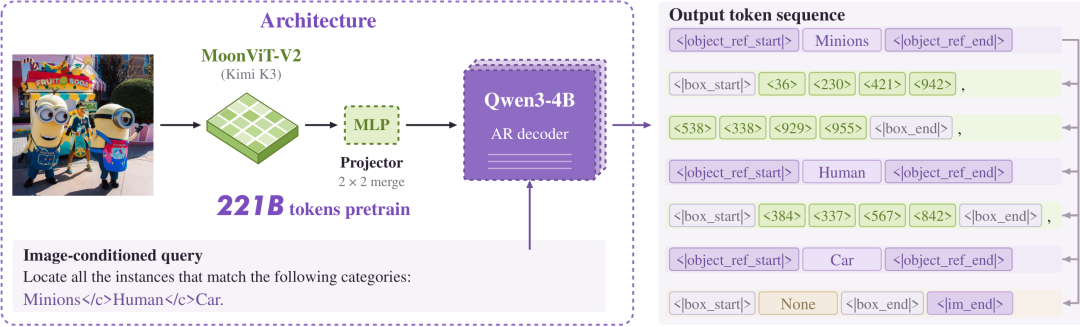
40亿参数并不算大。GroundingPI 没有跟着堆参数,而是把“点和框”当成一种视觉基元:用1000个量化坐标token,让模型像生成文字一样,自回归地吐出“类别+坐标”。
架构上是 MoonViT-V2 视觉编码器加 Qwen3-4B 语言解码器。训练分三步:多模态预训练、监督微调、GRPO强化学习。
关键在数据——它只用没有动作标签的纯感知数据训练。
这听起来有点偏执。毕竟大多数VLA模型,感知能力是从通用视觉-语言骨干网络里“捎带”来的。
问题是,这些骨干网络从没被专门训练来回答物理交互里最要命的问题:目标在哪,边界在哪,抓点在哪。
论文给了一个很直观的例子。Dense200密集检测基准上,Qwen3-VL-4B的F1mIoU只有14.02,GPT-6 Astra是65.04。知乎
桌面上堆满东西时,前沿通用模型的感知也会明显掉下来。机器人干活,恰恰最常遇到这种桌面。
感知不稳,代价会转移到动作数据上。稀缺的示教数据,本来该教机器人“怎么做”,却被迫同时教它“看什么”。
GroundingPI 的下游实验,测的就是这笔账。
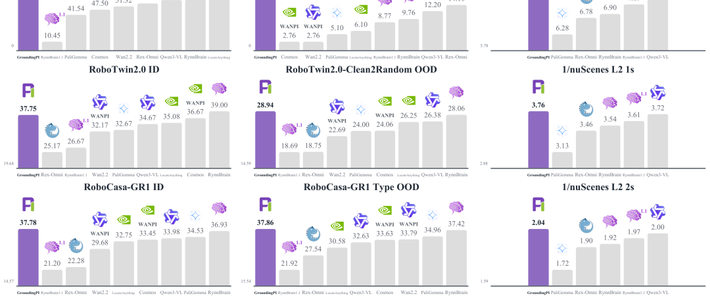
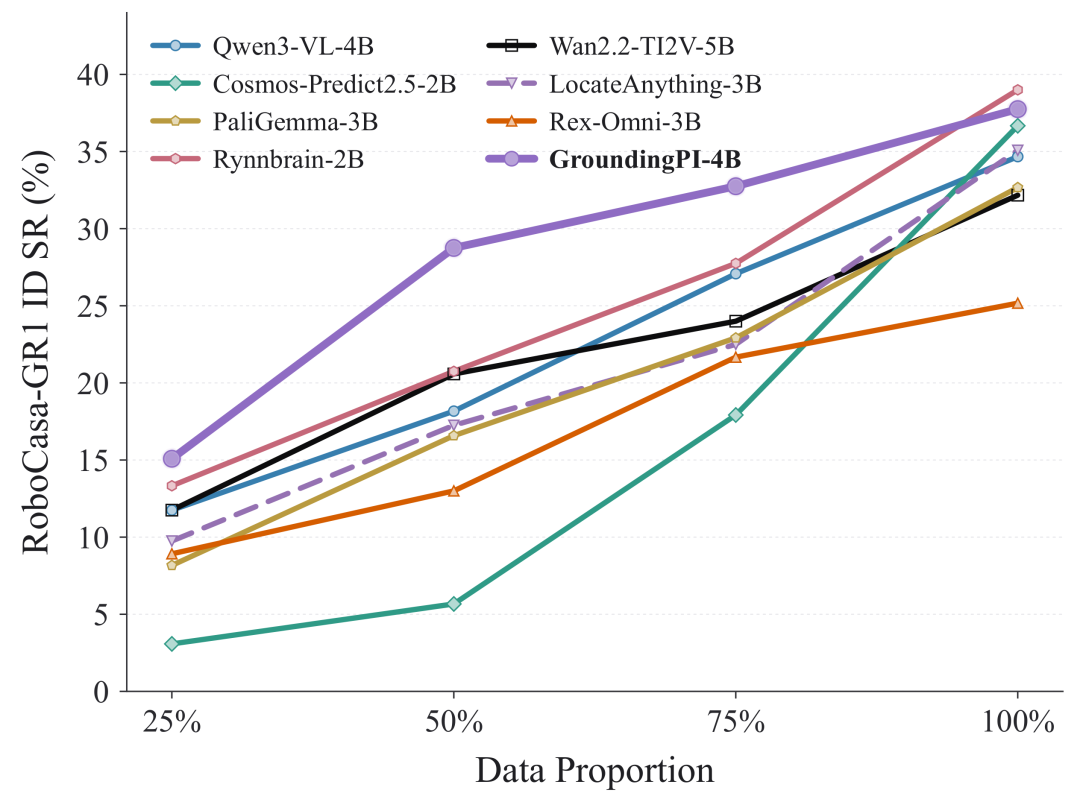
在 RoboCasa-GR1 上,只用50%演示数据训练的 GroundingPI,成功率28.75%,超过了所有用75%数据训练的对照基座,包括 RynnBrain 的27.75%。知乎
在 RoboTwin 2.0 的 Clean2Random 分布外测试里,它拿到17.60%,第二名 Rex-Omni 是14.10%,相对提升24.8%。知乎
预训练规模从88.4B token扩到221B token后,下游 OOD 操作成功率提高了约6.8个百分点。知乎
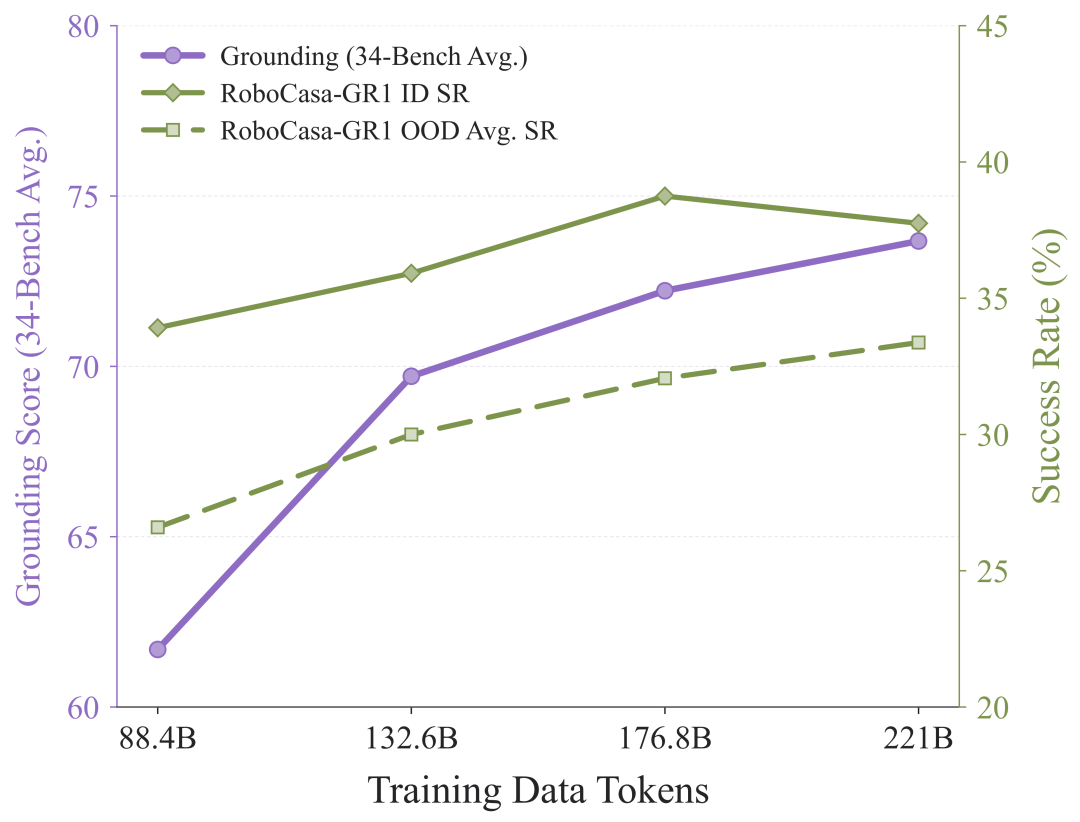
感知练得越扎实,动作泛化也跟着涨。
当然,这不是“感知一好,机器人就全能”。研究团队自己写得很清楚:73.68%是感知综合得分,不能直接等同于机器人操作能力。知乎
它也不是全面碾压。VisDrone 小目标检测上,GroundingPI 的40.44仍低于 SenseNova-Vision 的42.35。知乎
小目标这类硬骨头还在。它目前仍是科研原型,不是能直接装进产线的产品。
那小鹏为什么要把资源投在这?公司2026年在物理AI上的投入预计达到70亿元,并称已建立涵盖芯片、基座模型和AI Infra的全栈自研体系。凤凰网科技
IRON人形机器人的自动化产线9月已经启用,计划今年底量产、2027年上市交付。新浪汽车
对机器人来说,最难的不是造出一台能走的样机,而是把它放进不同的工位。
每换一个工位,就重新采一遍数据、教一遍动作,成本很难摊薄。GroundingPI 想做的,是把“看准”变成可复用的底座,让新工位的示教数据只用来学“怎么做”。
这套感知能力也不只服务机器人。小鹏的智驾和机器人共享同一套物理AI技术栈,感知、芯片、模型都在往一个底座上收。
对车主来说,短期内看不到直接的功能变化;但底层能力复用,是这家公司讲“物理AI”时最实在的部分。
回到那只杯子。真正值得记住的数字,可能不是73.68,也不是40亿,而是50%对75%。
当“看准”不再需要每个工位重新教,机器人上岗的门槛才会真正降下来。