

现在还用不了,也谈不上等内测。 截至11月21日,Gestalt只是Contra Labs与BenchFlow在11月18日发布的Frontier Design Benchmark榜单上一个挂着"Stealth"标签的匿名条目。设计圈真正该读的,是这张榜单本身说了什么:在由职业设计师投票的真实商业简报盲测里,AI第一次被排到了人类参考作品前面。IT之家微博
榜单规则很直接:33道设计简报,其中27道改编自Contra平台上真实客户的付费委托,每道简报由AI模型和人类设计师分别产出网页,35位职业设计师两两盲投,共4311票,再折算成Elo。结果公布当天,Gestalt以Elo 1931、胜率90%登顶,人类设计师的参考作品以1739分排第二,它是榜上唯一超过人类金标的模型,比第三名Claude Fable 5.2(1713分)高出218分。在与人类参考作品的直接对决里,设计师28次比较中有20次选择了Gestalt。小红书知乎IT之家哔哩哔哩知乎
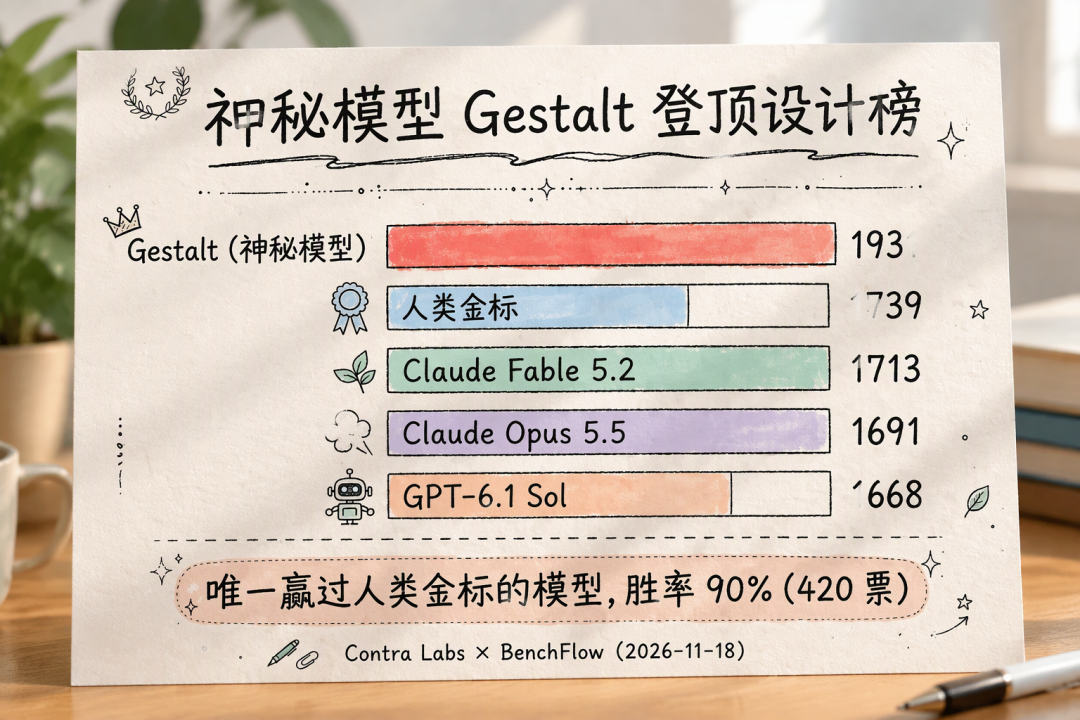
比名次更戳这行的,是附在榜单上的一套AI味检测(0到100,分数越高越像机器做的):人类参考稿0.9,Gestalt约1,Claude系列31到38,GPT系列41到53,Gemini系列54到57。翻译过来就是:它的产出几乎没有那种设计师眼熟的套路味——标题下垫一行小英文、渐变发光、满屏卡片。客户最烦的特质,第一次变成了一个可量化的评测维度。哔哩哔哩
它是谁家的孩子
Contra官网对它的描述只有一句,一个还在隐身中的高质量设计模型。中文圈在猜DeepSeek V5或智谱的新旗舰,英文圈则强调至今没人认领;Anthropic正赶在上市节骨眼上,"下一代Claude"的说法自然最有戏剧性。以上没有任何一种得到官方确认,都只能算猜测。有个容易认错的地方需要单独说清:人大高瓴学院GeWu-Lab今年10月发布的多模态研究模型也叫Gestalt,它是一张新基座性质的学术成果,和这次设计榜上的匿名条目不是一回事,双方没有任何已确认的关联。哔哩哔哩小红书微博36氪小红书
这张榜能证明什么,不能证明什么
在"能不能用"之前,先看清这张榜的证据边界。Frontier Design Benchmark在11月18日才首次公布,Gestalt几乎同时亮相,它不是在一块成熟基准上突然登顶,新榜配新选手,时机本身就值得存疑。榜也是Contra自己办的:其他模型由平台统一跑分,只有Gestalt是单独接入测试,重试了几次、花了多少钱都没有公开。更要紧的是,盲测衡量的是初稿的第一观感,真实商业交付里的反复改稿、在预算和工期里稳定交活,这张榜都回答不了。所谓"断层领先Claude 218分",目前只在偏好排序里成立,不等于真实产能。知乎小红书
商业设计师现在该干什么
手里的活照常用榜上已公开的模型干,Fable 5.2们仍是现在就能调用的第一梯队。这张榜真正递过来的有两样:把AI味纳入自己的验收清单,套路感不再是玄学;看清护城河正在移动——当模型也开始会挑,人靠的就不再是执行,而是判断。往后盯三个节点就行:官方揭晓Gestalt是谁的那天、API或产品入口开放的那天、盲测之外的设计师实际上手的评价。这三个节点齐了,"能不能用"才有真正的答案;在那之前,不必为它改变选型,也别急着替人类设计师输赢下结论。知乎

当前文章无评论,是时候发表评论了