

11 月 18 日,设计师接单平台 Contra 的研究团队 Contra Labs 和 BenchFlow 上线了一个设计榜单,叫 Frontier Design Benchmark。但榜单第一名不是具名厂商的作品:隐身模型的身份至今没有被确认,Contra 没有公布厂商、发布日期、价格或试用方式。这个代号 Gestalt 的匿名模型凭什么在设计能力上断层领先 Claude,它到底强在哪些实际场景?知乎知乎
这张榜测的就是「接活交付」
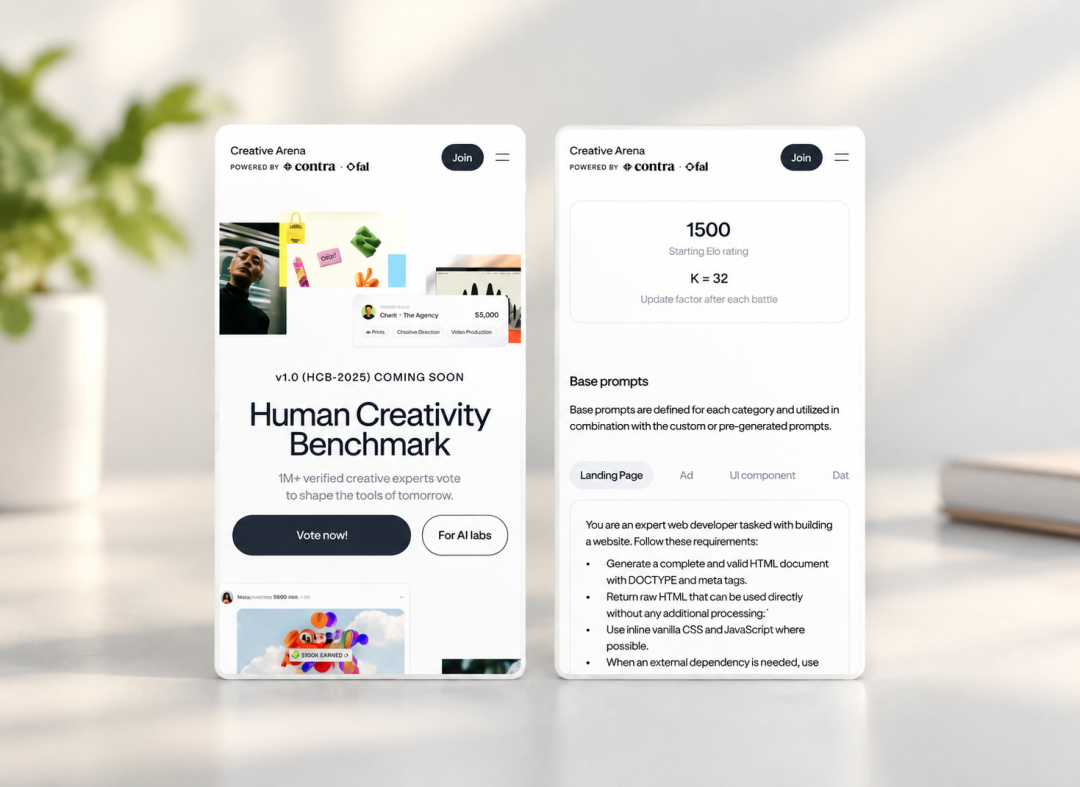
Frontier Design Benchmark 测的是 33 个真实商业设计任务、35 位专业设计师、4,311 次盲测。任务本身贴近真实外包:33 项设计任务里 27 项来自真实设计工作(仅对客户信息做了改写),另外 6 项来自创业公司合作项目,涉及网站设计、品牌展示、网页应用、移动端应用等不同场景。同一个简报,AI 模型和人类设计师各做一版,设计师在不知道作者身份的情况下两两对决投票——匿名模型 Gestalt 以 Elo 1931、胜率 90%(420 票)排名第一。第二名不是模型,是人类金标——人类设计师做的参考设计,1739 分,胜率 74%;第三名才是具名模型里最强的 Claude Fable 5.2,1713 分。在 AI 模型之间通常只差几十分的谱系里,Gestalt 领先人类参考设计 192 分,领先 Claude Fable 5.2 218 分,这才是标题里「断层」二字的来源。bilibili知乎小红书知乎知乎
榜单的评审维度涵盖色彩、字体、布局、可用性以及对任务要求的遵循程度。与人类金标稿的 28 次直接比较中,专业设计师有 20 次选择 Gestalt;对其他参赛模型的 423 次比较记录里,它获胜 378 次。全是接单交付时客户会挑的东西。所以「强在哪些场景」的第一层答案很直接:它强在这张榜覆盖的真实商业建站与品牌页面交付,而不是实验室里的抽象美学测试。知乎知乎
真正拉开差距的,是「不像 AI 做的」
这份榜单配了一个别的榜单没有的东西:slop 检测器,0 到 100 分,分数越高,页面越像 AI 生成的;基准团队扒了训练数据,发现 93% 的样本带着同一套视觉指纹——标题上方的小型大写微文案、01/02/03 编号版块、渐变滥用、卡片堆砌、玻璃拟态、超大圆角、纯黑深色模式、巨大居中英雄区。在这把尺子下,Gestalt 的 AI 味检测读数是 1.2,其他成熟模型都在 31 以上。Gestalt 和人类的差距在误差范围内,主流模型和人类的差距是两个数量级。换句话说,Gestalt 登顶的实质不是「比别的模型更会做设计」,而是「比别的模型更不像 AI 在做设计」——在盲评场景里,消除 AI 感比提升任何一个单项设计维度都更具杠杆效应。bilibili知乎
专业设计师认出好设计,靠的不是某个组件多精致,而是整体的「说得通」:主流组件式生成的组织原则是局部优先,每一个组件单独看都是「合理的设计模式」,但组装后的整体缺乏一种只有从全局约束出发才能获得的关系一致性。Gestalt 是格式塔心理学里的词,意思是整体大于部分之和,设计审美恰恰就是整体判断——排版、配色、留白、节奏,单拎出来都没问题,拼在一起好不好看,全凭整体感觉,起这个名字说明它就是冲着「品味」来的。知乎知乎
它没赢的地方,同样要说清
断层领先不等于全面碾压。在设计规范评分中,Gestalt 得到 83 分,而 Claude Fable 5.2 和 Claude Opus 5.5 都达到了 84 分。按规范逐项核对,Claude 仍占优——它赢在盲评的整体观感,不是赢在每一项。知乎bilibili
Gestalt 的作品也查无实图:公开画廊现有 12 个简报页,能看到人类稿和已具名模型的作品,但没有展示 Gestalt 的作品。生成成本同样未知,作为参照,Fable 5.2 的每网站成本保守估计为 127.22 美元,Gestalt 没有对应的成本数据点。小红书知乎
而且评测方与受益方存在结构性重合:Contra 既运营设计师市场,又发布评测设计师能力的基准,没有第三方复现。四盆冷水里说得很直白:检查表上它没赢、Elo 不能换算百分比、它只出现在这一个榜、这是垂类榜。知乎bilibili
至于它是谁,官方未披露,所有猜测都没有证据。社交平台上关于 Anthropic、Meta、中国实验室的猜测,都没有来源支撑。时间上的巧合倒是有据可查:Anthropic 已于 11 月 19 日(美国市场时间)以代码 ANT 登陆纳斯达克,上市当天官方没有发新模型,而这轮盲测里 Claude 系模型恰恰是被它甩开 200 多分的对象,但两者之间没有任何公开关联,不构成因果。bilibili知乎小红书
对用户来说,现在该做什么
对普通用户,Gestalt 揭晓前还不可用,现在公开能用、在这张设计榜上最靠前的仍是 Fable 5.2,先别急着改口。但这份榜单指出了一个值得留意的转向:设计生成能力的竞争轴,正在从「局部生成质量」转向「整体可接受性」。而且榜单中间已经断了一层:从第一梯队的 GPT-6.2 Astra(1638 分)往下,到 Qwen3.8 Max(1434 分),中间隔着 204 分,直接分成两个梯队,追赶的成本正在变高。选模型时少盯通用能力排名,多拿自己的真实需求去测:同一个 brief 让它和竞品各出一版,盲看一眼,这比任何榜单都更接近你自己的判断。接下来值得盯的信号有三个:官方是否揭晓身份并开放接口、作品是否会进入公开画廊、以及这套「去 AI 味」能力能否在其他基准上复现。小红书知乎知乎bilibili

当前文章无评论,是时候发表评论了