













 深耕数码、AI兴趣领域




4
1
高通完成HBC硅片验证,样品将于2027年上半年推出
2026-11-08 22:02:46
0点赞
0收藏
0评论
高通公司宣布,其第一代高带宽计算(HBC)芯片已在圣地亚哥实验室完成验证,为该公司面向AI推理的内存设计提供了早期的硬件实证。该芯片据称以接近实际量产的规模,运行了完整的内存读写路径和近内存计算,测试中使用了行业标准自动化测试设备,并采用随机生成的权重和激活值。

其目标是解决内存带宽问题。高通将其视为大语言模型推理的核心瓶颈,因为每生成一个token都需要将模型数据输送给计算单元。在数据中心规模下,数据搬运的能耗和延迟会影响吞吐量、功耗和总体拥有成本。HBC旨在通过将计算单元放置在更靠近内存的位置,来减少数据搬运并提升有效带宽。
高通的HBC设计采用晶圆对晶圆键合技术,将低功耗LPDDR芯片堆叠在带AI加速功能的有源基底芯片之上,将数据传输距离从毫米级缩短至微米级。据报道,这一方案使有效内存带宽相比LPDDR5X提升了18倍,每瓦带宽则超过预计中HBM4规格的5倍。
不过,这一能效提升略低于高通此前预计的6倍基准。高通表示,相关数据是基于实测硅片结果、经归一化至目标运行条件后得出的估算值,并与已发布的竞品规格进行了对比;最终性能可能因具体实现、工作负载和系统配置而有所不同。

高通还介绍了一个涵盖架构设计、制程开发、测试载体、硅片验证和产品集成的分阶段计划,并表示已与晶圆代工和封装合作伙伴合作,完成了晶圆对晶圆键合的认证。为应对堆叠层中的缺陷,该设计包含了冗余和重映射机制,可以绕过故障内存继续工作。
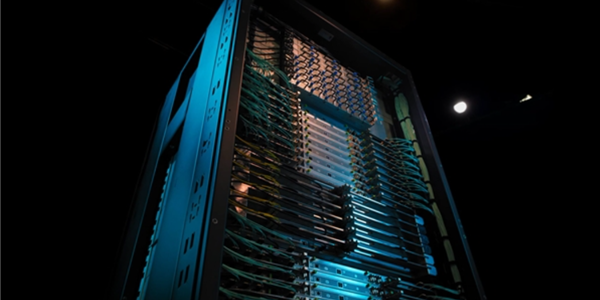
高通的商用产品预计将采用4层DRAM堆叠,较此前的两层方案有所增加。Dragonfly AI250计划于2027年上半年出样,将集成到高通的Dragonfly Rack推理基础设施中。规格方面,该硬件包括一个全液冷机架,配备38.6TB内存和每秒7.4 PB的有效带宽。

高通的内部发布策略将向服务器端倾斜:计划于2027年部署基于Oryon的C1000服务器CPU,随后于2028年在Dragonfly AI300中推出下一代HBC。










