

11月18日早上,开发者 sanixdk 在 X 上发了个东西:moochy chat。它把本地大模型塞进了浏览器标签页——不装 Python,不装 Ollama,不要 API key,不要订阅。知乎
数字小得有点离谱。推理核心叫 got4,一段不到 54KB 的 WebAssembly 代码,页面首次加载 135KB,两个数加起来不到 200KB,比一张手机照片还轻。首发接了六家的模型:MiniCPM、Qwen、Mistral、Llama、DeepSeek、SmolLM。有 GPU 走 WebGPU,没 GPU 用 CPU 顶,模型下进标签页之后,断网也能聊。演示地址 chat.moochy.dev 当天就能打开,状态栏直接摊着引擎、速度、显存占用、线程数,上下文窗口 8192 token。知乎
有意思的是,这条帖子自己几乎没水花——核查时只有 3 条回复、6 个喜欢、542 次查看。把它推出去的是面壁智能 OpenBMB 的官方账号,当天上午转发,确认 MiniCPM 接进去了。至于项目本身,帖子里没有代码仓库,页面全文搜不到 github 两个字。演示先行,代码还没露面。知乎
不是一个人在瞎折腾
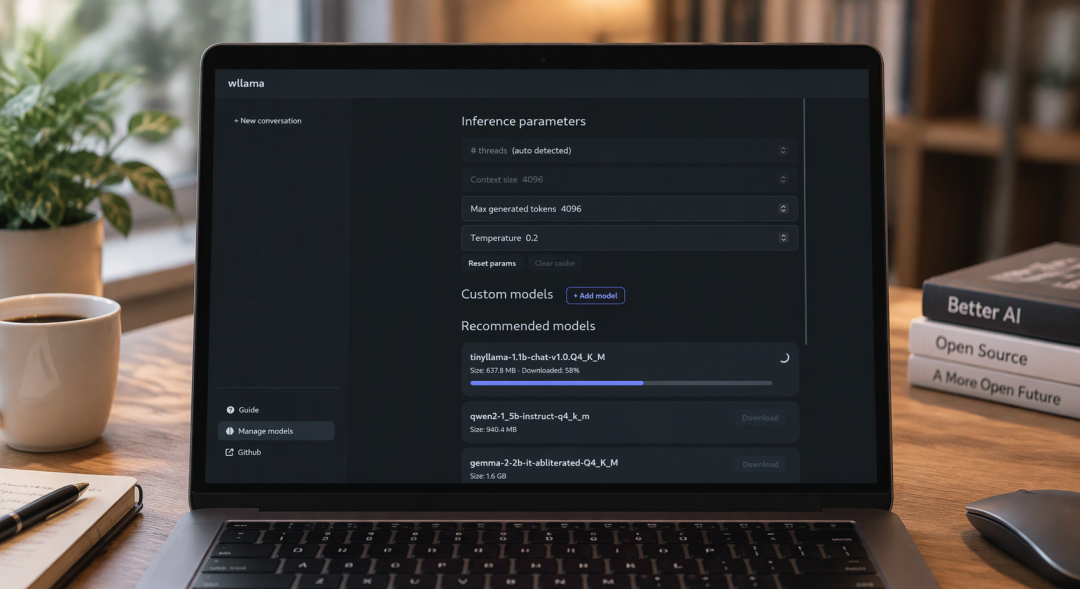
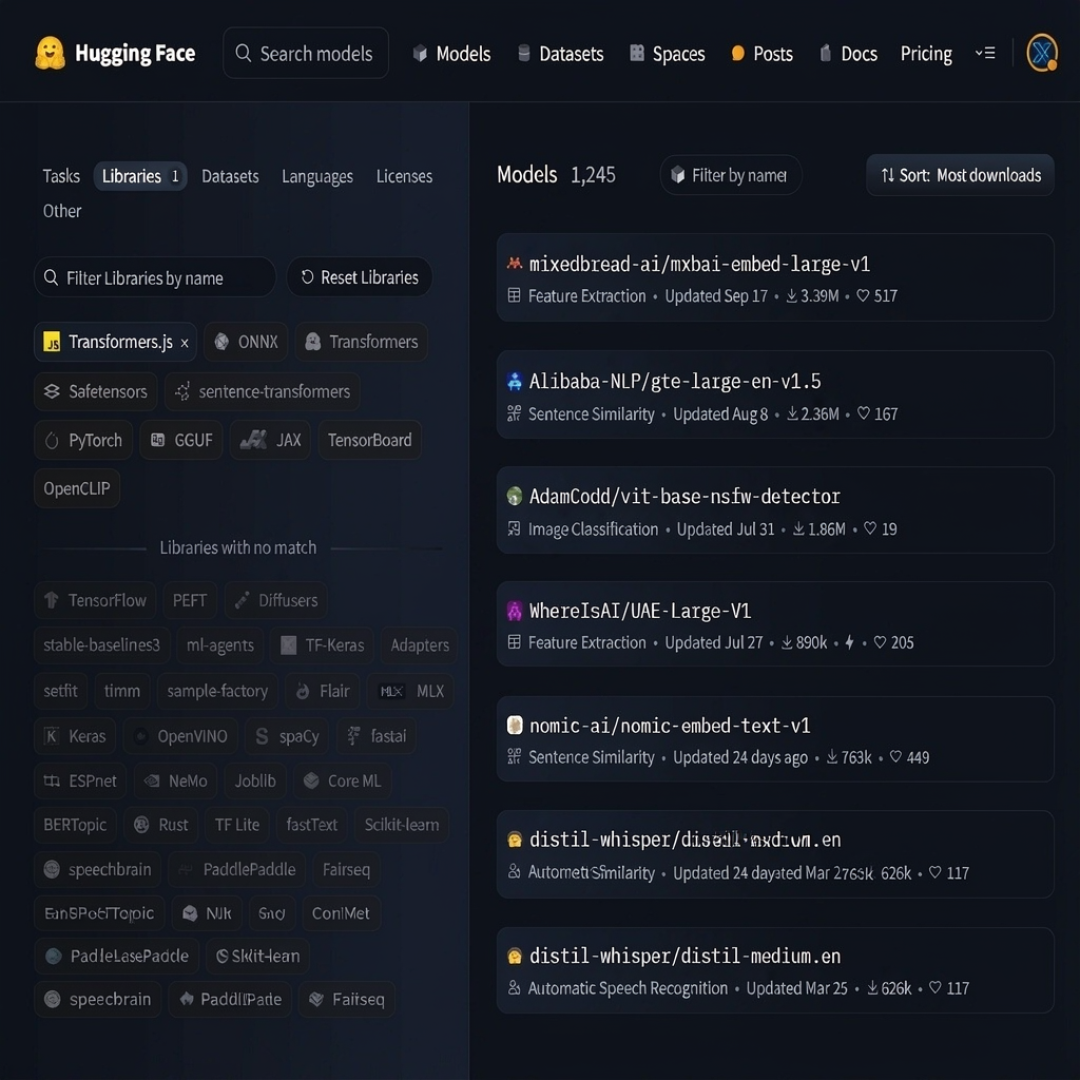
浏览器里跑模型这条路,早有人跑通了。WebLLM 来自 MLC AI,最新版带 163 个预编译模型,还公开过实测条件:Llama 3.1 8B 在 M3 Max 的 MacBook Pro 上,每秒 41.1 个 token。wllama 把 llama.cpp 编成 WebAssembly,直接跑 GGUF,代价是单文件 2GB 上限,多线程还得服务器送两个跨域头,不给就悄悄回落单线程。Transformers.js 是 Hugging Face 的 JS 版,官网上按它筛出来的模型有 1245 个。知乎
还有一条更省事的:Chrome 从 148 版起,把内置的 Prompt API 放进了稳定版。Gemini Nano 早就躺在你硬盘里了——User Data 目录下 OptGuideOnDeviceModel 里一个 weights.bin,4072MiB。官方文档写得很直白:用这个模型,系统不会向 Google 或任何第三方发送数据。知乎知乎
天花板也很硬,就三条
第一条是内存。浏览器一般只给 2 到 4GB,模型基本只能用到 7B、4bit 量化这一档。对照体积就清楚了:Llama 3.2 1B 下载 695MB、跑起来占 880MB;Qwen3.5 2B 下载 1.06GB、占 2.2GB;到 Llama 3.1 8B,光下载就 4.5GB、要占 5GB——超了。所以别指望标签页里跑 30B。知乎
第二条是硬件,而且它会悄悄给你分班。Chrome 在决定给你哪个模型之前,先让 GPU 跑一段测试着色器:考得好给 4B,考不动给 2B,再不行退回 CPU。有人拿 2015 年的老 MacBook 试,chrome://on-device-internals 里 Nano 明明白白写着 Ready,可旁边 Performance Class 是 VeryLow,Possible Capabilities 只有 Image。WebLLM 怎么都装不上——那块 Iris 核显的 WebGPU 很可能被回落到 SwiftShader,也就是拿 CPU 软件模拟 GPU,requestAdapter 能拿到设备,真编译计算管线就稳定失败。知乎知乎
第三条是速度宣传得打折听。moochy chat 说自己比 WebLLM、wllama、Transformers.js 都快,部分模型最快每秒 150 个 token,但模型、机器、量化精度一个都没给。能对照的是 webyIQ:同一个 Qwen3.5-2B、同一组提示、同一个 Chrome,作者手写的 WebGPU 计算核跑到 620 tok/s,WebLLM 94,Transformers.js 31;换到只有 2 个计算单元的 AMD 核显,620 掉到 37,WebLLM 4.7,Transformers.js 直接崩溃。机器一换,差出 16 倍多。知乎知乎
那这条路到底怎么用
分工清楚就行。临时试个模型、断网环境、给人演示、不想为一两次需求折腾半小时环境——标签页够用,省掉的正是最烦人的那一步。Chrome 那个本地 scam_detection 也值得单说:可疑短信、钓鱼链接在设备上被看一眼就完事,不用上传给谁。知乎
要跑 30B、要长上下文、要常驻服务、要放敏感资料,还是回显卡那条路。8192 的上下文窗口,接得住一个问题,接不住一份长文档。
想自己验,先去 chrome://gpu 看 WebGPU 那一段,那才是你的通行证。再开 chrome://on-device-internals,别只盯着绿色的 Ready,翻翻旁边有没有 VeryLow。然后打开演示页,挑最小的模型下载,下完把网断了发一句,看它是不是真离线。知乎
最后两句提醒:聊天记录只存在本地,换台电脑就没了;moochy chat 眼下除了"本地运行"这句话,没有代码和审计可查,敏感内容先别往里放。

当前文章无评论,是时候发表评论了