10月24日晚,知网AIGC检测系统完成第五代算法升级。这几天知乎、微博上最扎心的帖子都跟它有关:一字没改的论文,AI率从14.6%飙到74.7%。更狠的是有位学术博主晒出实例:9月发表时检测为0%的文章,用新系统重测,AI率直接到了79%。有学生吐槽,提前查过的人不得不再查一次图个心安,一来一去得花两笔钱。微博知乎微博
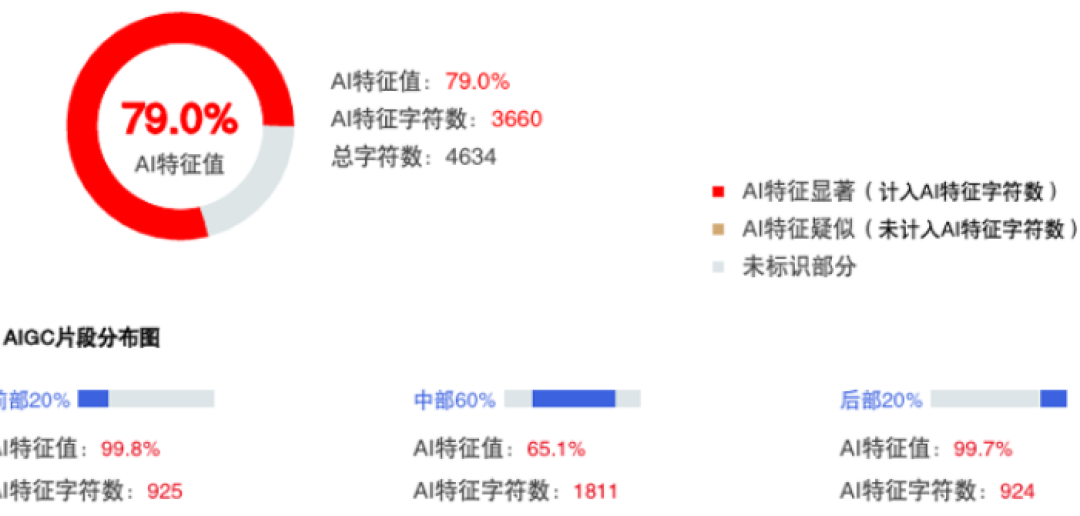
这次升级的核心在于检测思路变了:不再只盯词汇和句式特征,而是分析段落推进、论证层次和跨段落的风格一致性。同义词替换、语序调整、手动把长句拆短,这些流传最广的降AI手段,现在基本无效——系统已具备识别初级“降AI工具”改写痕迹的能力。微博
检测变严只是压力,真正的问题是:为什么你的稿子一直有AI味?
AI味不是几个词的事,是写作习惯的事
一位改了二十多轮稿子的作者在微博复盘过:她一开始也照网上教的换词,“因此”改“所以”、“什么”改“啥”,结果越改越怪,像穿西装套了双拖鞋。后来才想明白,AI的问题是整个习惯跟人不一样——写出来什么都是对的、干干净净、一句废话都没有,可人说话不是这样的。微博
知乎上一位审稿人的总结更系统,他审过的AI稿几乎每篇能对上三四条破绽:段落等长,像用尺子量过;一上来就宣布“有三个原因”,再挨个填进去;冒号列举满篇都是;“不是什么,是什么”这类伪洞察句式;把“效率与体验”“深度与温度”成对捆着用;结尾一定要把全文重说一遍。知乎
一位专门观察AI文案的作者还补了一条:AI的每句判断都要留退路,“有潜力,但还不能证明”“值得研究,但还需验证”,肯定、限定、否定更强结论、再给条件,一套风险对冲打完,什么也没说。知乎
这些单看都是小毛病,叠在一起就是那股“塑料膜感”。
真正有效的改法,排序变了
那位审稿人把八条破绽按危害排了序,结论出乎意料:结构、句式、冒号都是表面,改一改就能去掉;唯独“没有具体的人和数”致命,因为它不是写法问题,是材料问题——AI手里没有那件事,怎么写都是空的。知乎
但对普通写作者来说,这恰恰是最值得抓的杠杆。把一段话改成有名字、有地点、有数字的版本,哪怕句子笨一点、结构乱一点,读者也会信。具体的东西没法凭空造,它要么存在,要么不存在。写周报就把“持续推进中”换成“周三上线了A功能,留存比上周高2个点”;写文案就把“深受用户喜爱”换成你真的看到的一条评价。
顺序应该是:先补具体材料,再删空话,最后才轮到句式。跳过第一步去磨句子,等于给烂木头抛光。
不想自己磨,社区有现成工具
GitHub上藏师傅的Humanizer-zh已经一万多star,9月底刚大更新过。它不是检测工具,是一份给AI读的润色规则:31条检查表,其中F类专门治中文病——长定语、“进行+动词”、被字句堆叠、四字词排比。它的原则写得很死:先保住信息和确定性,再谈文风,原文写“可能”就不许改成“确定”,缺数据也不替你编。安装只要一行命令,Codex、Cursor也能用。微博
写前端的另有Hallmark,专治AI页面的紫蓝渐变、发光球和永远三等分的卡片,用反模式清单硬性拦掉模型的默认发挥。知乎
不过两边的作者都留了同一句丑话:这些工具救不了结构散的稿子,也证明不了“这是人写的”,更不保证过任何检测。
立场更激进的是Martin Fowler,他上周发了篇《LLM Voice》,劝作者别让大模型起草初稿——哪怕后期人工修改,那股味也很难去净,读者会像撞见恐怖谷一样不想再读。他的做法是AI只当搜索工具,正文自己写。微博
对靠AI写周报和文案的人,不用这么狠。一个务实的分工是:AI出初稿,你补细节、删套话,最后自己读两分钟。AI味去掉多少,取决于你往里放了多少只有你知道的事。