AI给你写的代码第一次跑通那一刻,是真的上头。
说几句话,页面就出来了;再补两句,功能就有了。有人两周做出一个能收钱的小程序,搁以前,这活儿要干两个月。小红书
但最近小红书上的一篇帖子捅破了这层热闹:《使用Vibe Coding创业的受害者,已经出现了》。那些靠一波流上线的人,开始陆续交学费了。
翻车不在上线时,在上线后
帖子总结了几类受害者,每一条都很扎心:
需求一改,系统就塌。 加个会员等级、改个字段,三个页面跟着报错——因为代码里全是硬编码,当初只是让AI一路往下写,没设计过边界。
数据模型一开始就是错的。 状态存成字符串、订单流程写死,前期跑得欢,后期没法统计、没法追踪、没法扩展。
只写了Demo里最顺的那条路。 支付失败、网络超时、用户重复点击,代码里统统不存在。没日志、没重试,线上出了问题,你连哪儿出的都不知道。
权限形同虚设。 前端把按钮藏了,不代表后端校验了。用户A能不能看到用户B的数据,真实用户一进来就见分晓。
最惨的是:上线后看不懂自己的产品,就像接手了一堆"已离职老员工"(AI)写的屎山代码,根本没人懂,而且你还没法开除他们。小红书知乎
为什么大家都在踩同一个坑
微博博主宝玉xp点破了一个现象:人人都用AI编程,代码产出的方差反而比以前更大了。以前人一天写几百行,现在动辄几千上万行,数量把方差撑大了。AI把"生成代码"的成本压到接近零,却没降低"验证代码"的成本,一分都没有。微博
换句话说:跑通的爽感是AI给的,翻车的账单是你自己付的。
把验收变成肌肉记忆,就四步
一位给研究生上课的老师,把课件整理成了一套Slides《Vibe Coding:从"代码能跑"到"结果可信"》,在微博被广泛转发。核心是一套外行也能听懂的工作协议:微博
先定义规格,再让AI动手。 要什么、边界在哪、异常情况怎么办,先写清楚,别一句话丢过去开盲盒。
先建立测试,再改代码。 AI说"测试通过了"不算数,你得自己跑一遍。
每次改动看Diff,控制变更规模。 别让它一次改五百行,然后你闭眼点"全部接受"。
用Git管好版本,敢于回滚。 看不懂的代码直接回退重来,好过在错误的地基上继续打补丁。
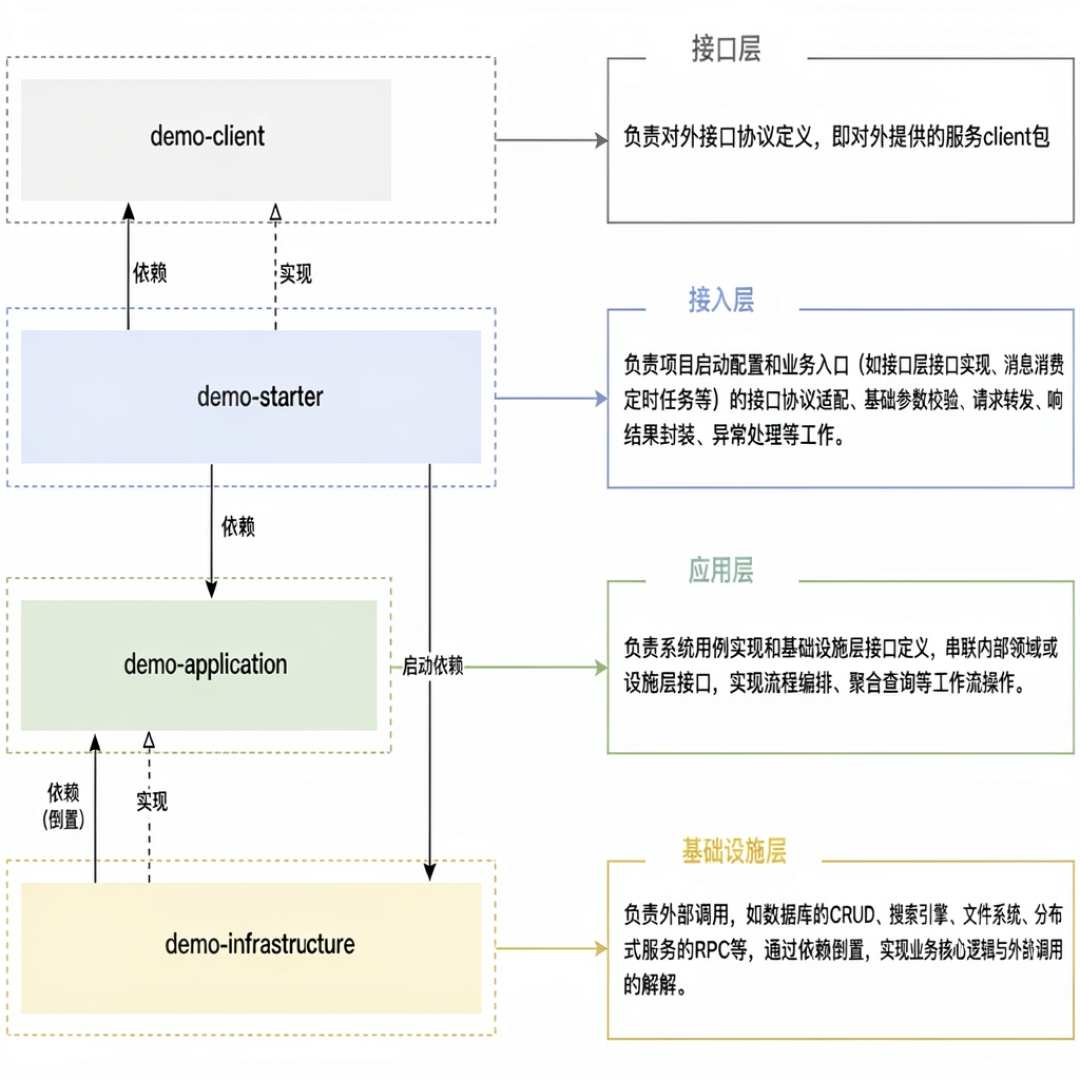
36氪采访的一位首席架构师Carlos Kelkboom更狠:看不懂的代码,直接扔掉。他曾经发现AI在一个月里把同一个功能重复实现了五次,从此立下规矩——自己先搭好项目骨架,AI对需求理解不够透彻就不准写码,产出偏离预期就整体回退。36氪
大厂已经这么干了。美团技术团队披露过一个业务系统:31万行代码,90%以上由AI生成,但提交前要先过AI自查环节,检查规范和缺陷,再由工程师重点审业务逻辑。生成可以快,检查必须跟上。36氪
最后
那套Slides里有两句话,特别值得贴在显示器上:
代码可以不亲自写,结果必须自己负责。
把执行交给AI,把判断留给人。
AI编程拼的从来不是谁生成得快,而是谁接得住。