

「之前光盯 tok/s 根本不知道算好还是烂,白折腾两天」——B 站这条评论,说的是本地跑模型的人都撞过的墙:参数改一堆,速度动一点,然后不知道继续还是收手。哔哩哔哩
11 月 16 日,GitHub 上多了个 MIT 开源的 Agent Skill,叫 inference-optimisation。到 21 日,1348 星、122 个 fork。它不给参数清单,给的是一句话:先把天花板算出来。
天花板就是一道除法
decode 阶段卡在显存带宽上。上限 ≈ 实测带宽 ÷ 每吐一个 token 要读多少字节。注意是实测,不是标称。GitHub知乎
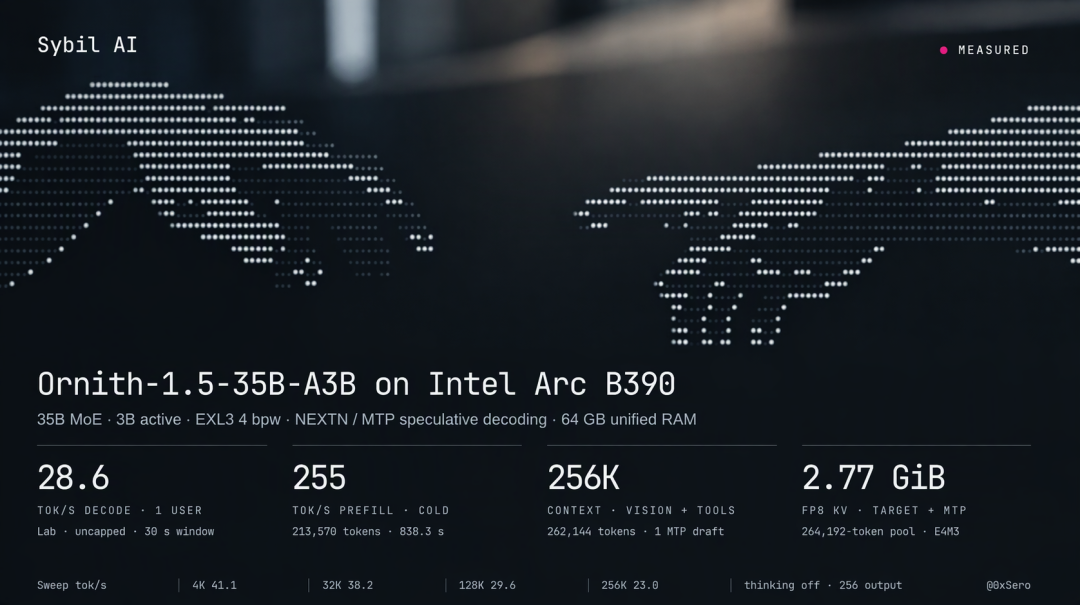
仓库里有个算好的例子。Intel Arc B390 核显笔记本,64GB LPDDR5X,标称 153.6GB/s,实测拷贝只有 115GB/s。模型是 Ornith-1.5-35B-A3B,EXL3 4bpw,256 个专家里取 8 个。每 token 要读三块:路由专家 16.26GB × 8/256 = 0.508GB,dense 部分 0.758GB,LM head 0.382GB——6bit、24.8 万词表。加上工作上下文的 KV,合计 1.68GB。GitHub
115 ÷ 1.68 ≈ 68 tok/s。这是不开投机解码的物理上限。GitHub
开了呢?一个草稿头配裁剪过的 draft head,上限 97;两个草稿头,约 103。但这模型的 MTP 头在深度 2 的接受率只有 14%,走两个草稿那条路从一开始就不通。真实目标区间是 88~97,他们实测跑到 53,约 55%。剩下的差距在量化 GEMV kernel——verify 图里等效带宽只有 76GB/s 左右。用户想要的「100 tok/s」,答案是:不在物理里。GitHub
这套除法不是纸上谈兵。配套 registry 里同一台 B390 有完整记录:爬坡前 lab 门 28.6 tok/s decode、255 tok/s 冷 prefill,爬坡后 41.0 和 667,并发从 1 路 262K 变 4 路。下图是爬坡前的实测卡。GitHub
慢,很多时候不是卡的锅
同一张 Arc Pro B70,同一个 Qwen3.8-27B:llama.cpp 跑 Q4_K_M 是 25.0 tok/s,换成 vLLM + EXL3 4bpw 是 91.2。3.6 倍。16 并发更夸张,56.0 对 365.2,6.5 倍。
RTX 3090 那组更接地气。Qwen3.8-27B EXL3 3bpw 加 MTP,散文 96.2、代码 141.1 tok/s。换成 Qwen3.6-35B-A3B,251.7 和 357.9。就一张 24G 的老卡。GitHub哔哩哔哩
你晒的提速,可能是量错了
Skill 里的 methodology.md 全是踩过的坑,几条特别扎心:
数 SSE chunk 当 token 数。开了投机解码,一个 chunk 里塞好几个 token,速度直接少算。
用「随机词」造长文档,以为 1.3~1.9 token/词,实际 3.5。标称的 32K、128K,真跑的是 58K、232K。
笔记本拔电源或者开均衡模式,慢 8~10%。后台有点 CPU 负载,一台笔记本 4080 从 107 掉到 75 tok/s。GitHub
同一套配置,隔一小时测出 53.8 和 49.5。所以它的规矩是「对照—候选—对照」夹着跑,至少 6 次取中位数。
有条 117 tok/s 的「纪录」,是模型在循环输出一个编号列表。
它到底怎么干活
一次只改一个变量,改完夹在两次对照中间跑,赢不了两边就不认。失败的也写进 PLAN.md——作者说负结果才是最可复用的产出。最后还要过长文本大海捞针、并发满 KV 压测,再加加载、对话、推理、工具调用、上下文、速度六道门,才允许叫「最好」。GitHubGitHub
用法很轻:clone 下来拷进 ~/.claude/skills,跟 Agent 说一句「在 40GiB 上限内爬坡 :8000 上的模型」就行。不想用 Agent,直接跑 scripts/ceiling.py,也能先把自己的天花板算出来。GitHub
该泼的冷水
上面所有数字都是 sybil-solutions 一个团队在自家硬件上的自测,我没找到第三方复现。仓库从 11 月 16 日建库到现在只有一次提交,levers 和 gotchas 是快照,引擎一升级就得重核。B70 是专业卡,B390 是核显,跟你手上那张不是一回事——能抄的是方法,不是数字。96.2 那组只标了「单用户」,没写上下文长度。GitHub
一句话带走:实测带宽 ÷ 每 token 字节数 = 你的天花板。先算这个,再决定今晚要不要继续熬。
当前文章无评论,是时候发表评论了