

知乎上有个提问几乎没人答:AI和LLM领域有哪些大道至简的想法?回答的人一开口就是"咋没人答呢"。可能是太简单的东西不好摆上台面。但翻了一圈讨论你会发现,这个领域真正的几次关键跃迁,全都是一句话能说透的那几行。知乎
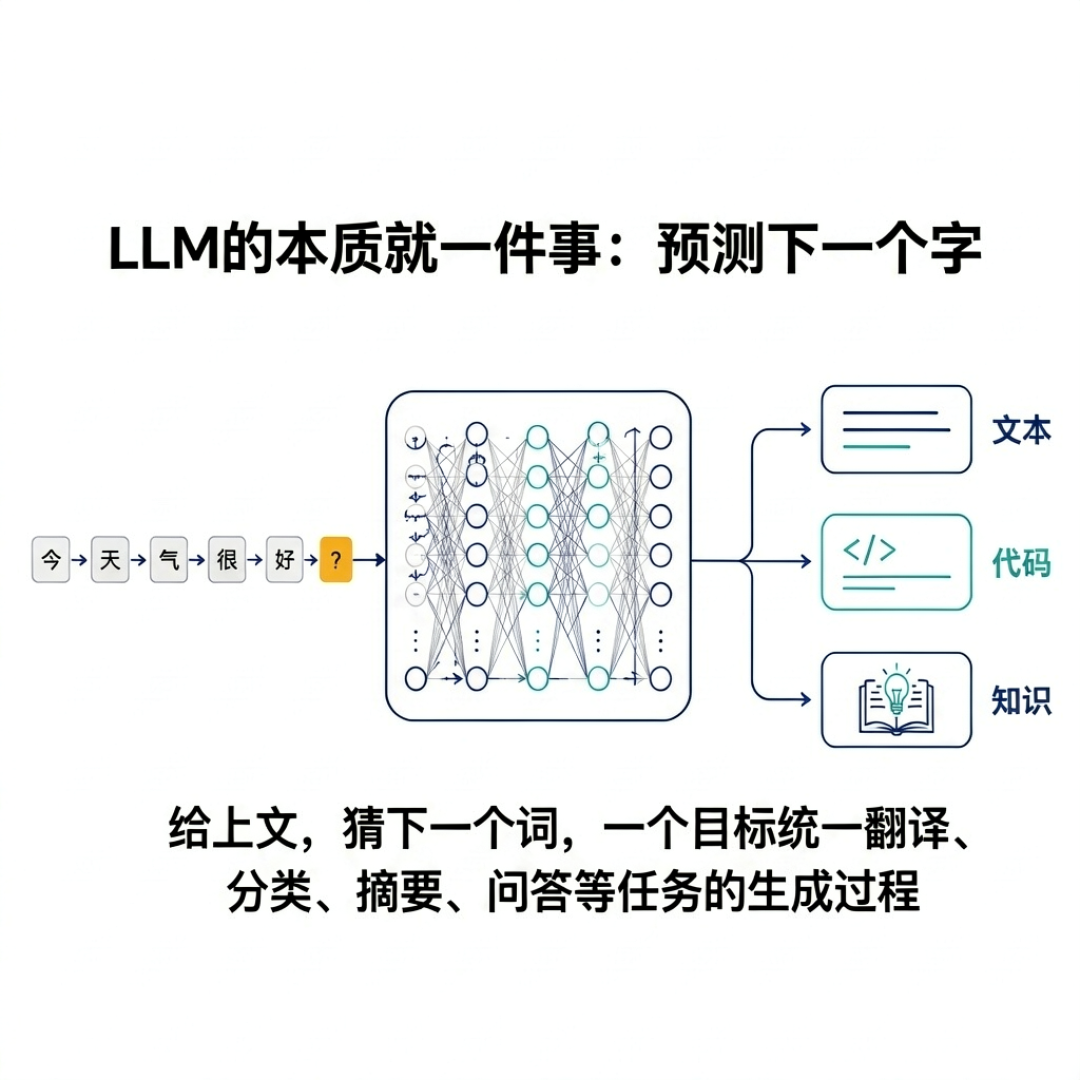
① LLM的本质就一件事:预测下一个字
“给上文、猜下一个词”,一个目标吞掉了过去所有任务专线——翻译、分类、摘要、问答,全塞进同一个模型。没有更聪明的招,它是一个字一个字,猜出了一个时代。
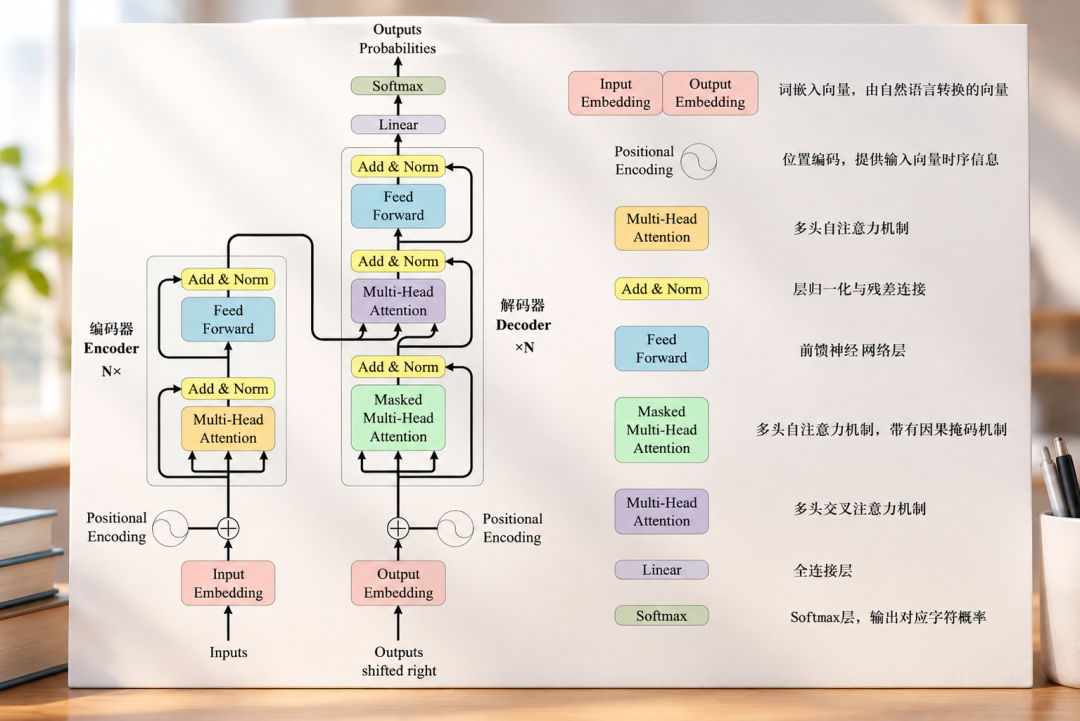
② Attention is all you need
论文标题本身就是大道至简的示范。Transformer扔掉RNN的逐步循环、扔掉CNN的局部卷积,只留自注意力:每个字自己看全文,自己决定该信谁。架构简单才敢放大规模,今天所有大模型都是这句话的后代。
③ 苦涩的教训:人类注定输给算力
Sutton那篇一页纸的文章足够扎心:最后赢的从来不是人类写的巧妙规则,而是能持续吃掉算力的通用方法。AI发展史,基本是一部"手工技巧"输给"规模"的历史。知乎知乎
④ Scaling Laws:性能可以先算再训
损失随参数、数据、算力按可预测的规律下降。"大力出奇迹"这句流行梗,本质就是这条规律的工程化:你不需要知道模型具体学会了什么,你只需要知道预算够不够。
⑤ 最狠的研究技巧,都"小"得离谱
有人把这个问题答得很硬核,列了几个例子:ReZero,在每条残差分支上乘一个初始化为0的可学习标量,网络开局就是恒等映射,深层训练立刻稳了。Adafactor,优化器不存完整二阶矩矩阵、只存行列和,显存直接省下来。不发明新架构,只把问题里唯一的那根线头拎出来。知乎
⑥ 工程外壳:模型+工具+一个循环
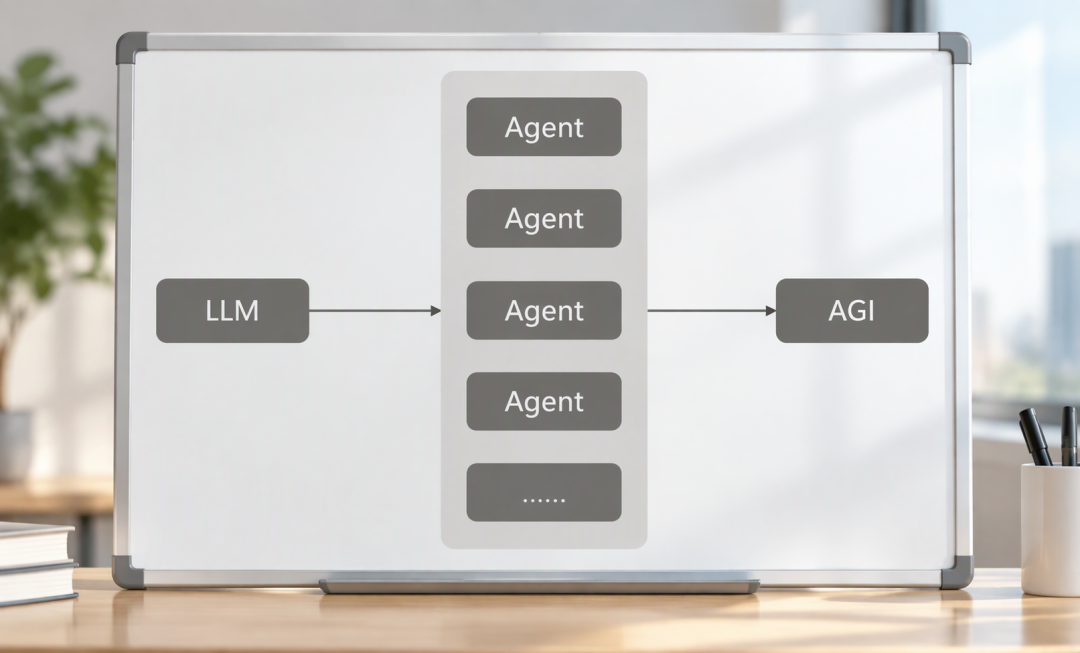
做Agent的人回头看,核心就是while循环+工具调用。小红书用户晒"3条/loop命令撑起整个工作流"。有人vibe coding的转折恰恰是放弃精雕Prompt——“反而有种大道至简的感觉”。小红书小红书
不过今天,“大道至简"第一次遭到反对。知乎热文宣布"苦涩教训的终结”:摩尔定律放缓、单位token价格还得降,工程师开始造"丑陋但高效"的设计——稀疏查表、索引器跨层复用。评论区吵翻了,有人说这是"大雕花时代",也有人算得更冷静:算力成本也是less is more,成本越高智能会越少。知乎
所以最准的结论不是"简单永远赢":大道至简说的是"目标简单"——预测下一个字、吃算力——而不是"实现永远干净"。算力红利还在,简单就是王牌;红利吃完,轮到那些"丑陋"的优化上场。
下次有人问你"大模型到底怎么回事",你可以先回一句:它只是在预测下一个字。能把这一句话展开讲透,这个领域就都在你手里了。
当前文章无评论,是时候发表评论了