

全网在催智谱发 GLM-5.5,但它放出的两件事比参数瓜更实在
最近搞 AI 开发的朋友大概都刷到过这一幕:11 月中旬,在一些"要求智能体提交代码时署名所用模型"的 GitHub 项目里,署名突然变成了 GLM-5.5。而这些项目的提示词里压根没提过 5.5——模型自己漏了底,智谱下一代旗舰大概率已经在灰度。新浪财经哔哩哔哩
于是催更现场惨烈:有人在知乎喊话"智谱不要比憋气了,赶紧把菜端上来……再不上就凉了"。各条爆料底下的高赞评论全是"发吧发吧,再不发真死了"。知乎
但大家押的那个参数瓜——3.5 万亿——基本是自我安慰。智谱近期真正放出来的是两件事,一件关于数据,一件关于系统,比盘口有意思得多。哔哩哔哩
先说数据。唐杰在清华高级机器学习课上开场就亮账本:GLM-130B 时代 0.4T token,GLM-4 到 15T,4.5 是 23T,GLM-5 到了 28.5T——下一个目标 100T。这个数是他自己估的:全世界互联网上能洗干净拿来训的,大概就这么多。微博
洗数据有多狠?一套 RefinedWeb 式流程跑完,原始网页只剩 11.67%;微博这类数据基本全过滤,点赞、语气词、骂人都不配进训练集。他们自研的 haruka-parser,比测过的最佳开源解析器多捞回 50% 的网页 token,高质量 token 多了 150%。模型使用高峰在上午 11 点和下午 3 点,后半夜集群闲下来也不浪费——拿去给数据打标、打分。
唐杰的原话很直白:“做基模的人手上最核心的就是数据配方,配方被别人知道了,这是机密”——“对于预训练的人,这一半都是他们的命”。微博
再说系统。9 月 17 日唐杰发布智谱 RSI 首个成果:GLM-5.3 驱动的 Infra Agent,在超过 10 万张国产芯片组成的集群上,从零参与搭建生产级推理系统——自己读反馈、提假设、改代码、跑实验,两周把端到端吞吐量提到了原来的 3.2 倍。同期 GLM-5.3-Flash 化名"Ox-Alpha"匿名上线测试,6 天调用超 62 万亿 token。微博
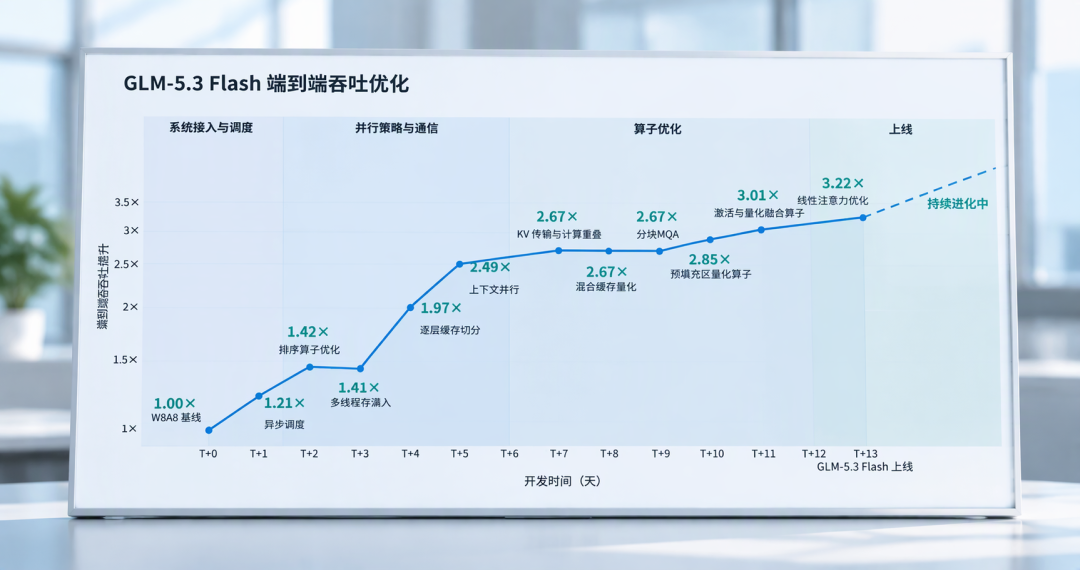
唐杰把它概括成一句话:模型优化系统,系统承载模型。下一代 GLM 还没出生,跑它的地基是上一代 GLM 自己搭好的。量子位
第三,冷水也得泼。灰度只是署名推测,“3.5 万亿参数”"跑分超 Opus 5.5"全是爆料和盘口。"100% RSI"是社区线索,智谱自己也反复强调还没有实现 RSI。李飞飞和 Jeff Dean 已经点名硅谷滥用 RSI 概念。发布时间、参数规模、定价,统统未知。知乎知乎量子位知乎
但对普通用户,观察点其实已经清楚:5.5 真发出来,值得盯的不是有几 T,而是编程能力能否延续 5.x 在程序员群体里的口碑、1M 长上下文还在不在、价格策略能不能保持性价比身位。至于市面上流通的"第三方低价 GLM 套餐"——官方定价口径还没换代,先别急着囤。
结论就一句:智谱的沉默不是没牌,是锅(自建系统)和粮(100T 级数据)都还在地里长着。土壤真铺成了,GLM-5.5 的进步幅度,可能比任何参数盘口都实在。
当前文章无评论,是时候发表评论了