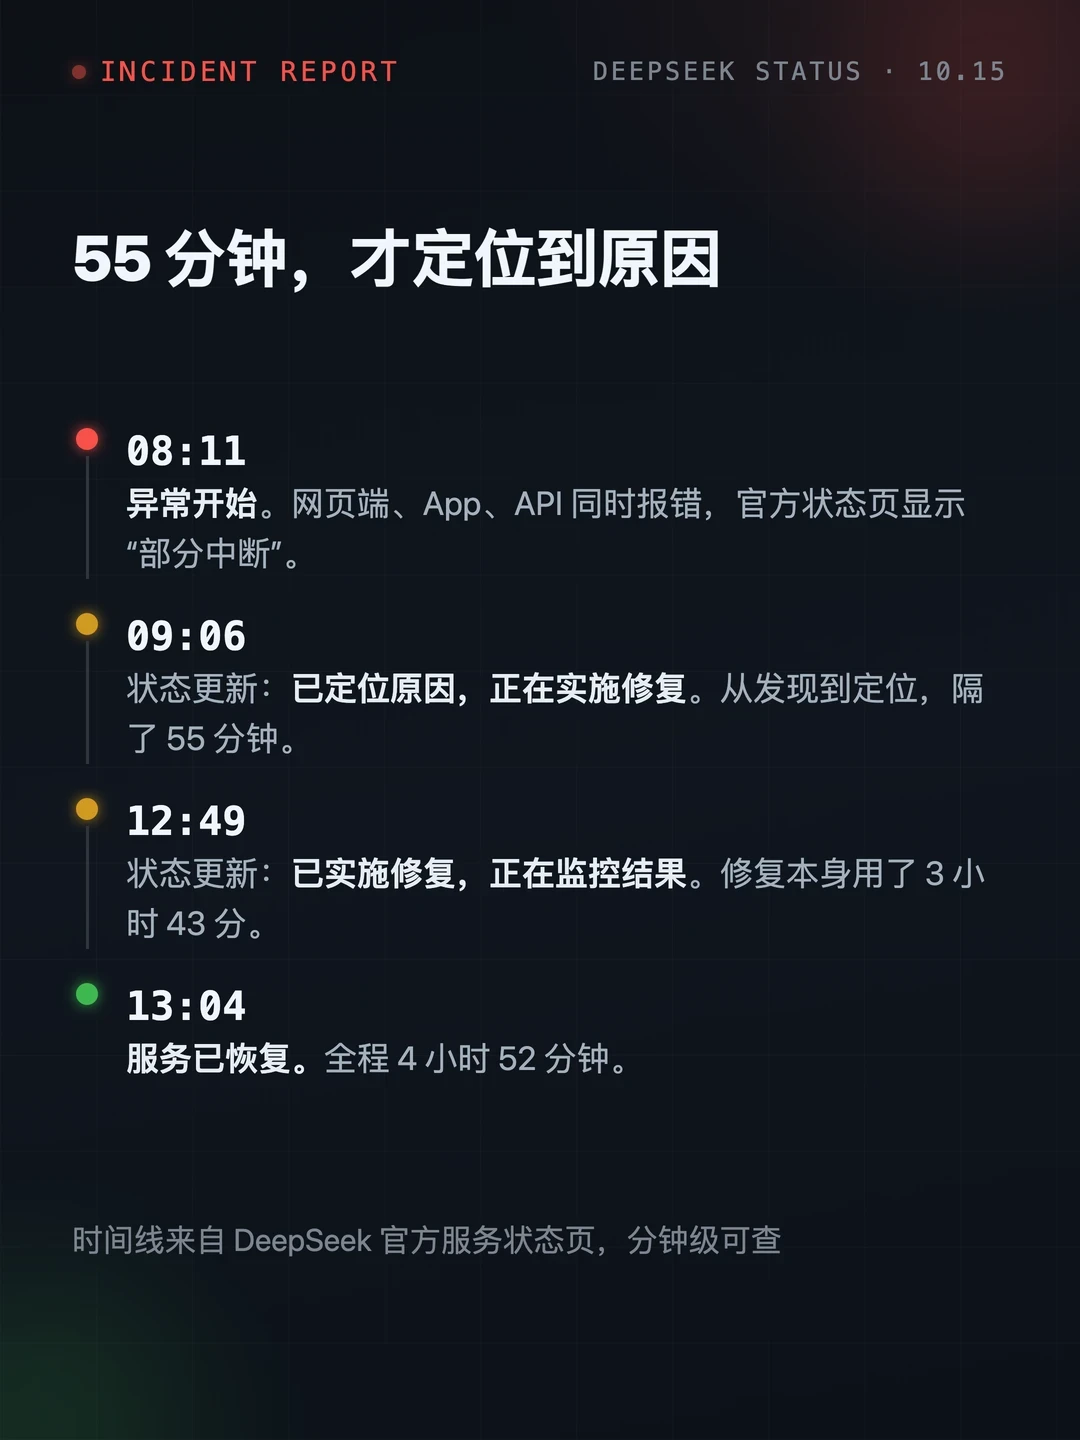
10月15日上午,不少人点开DeepSeek,迎面是同一行字:服务器暂时不可用。网页端、App、API一起停摆,直到13:04才恢复,前后4小时52分钟,「DeepSeek崩了」直接冲上微博热搜。知乎微博
别以为只有云端用户受伤。有位知乎网友说,他电脑上DeepSeek网页版、DeepSeek Harness、WorkBuddy里挂的模型正各跑各的任务,宕机时一起弹「网络异常」——他第一反应居然是检查自己家网断没断。知乎
当晚官方发布《服务恢复及补偿通知》,评论区一片晒到账截图,有人只有几块钱,有人拿到三千。看着挺大方,但细看规则就知道,这笔钱赔的是什么。微博知乎知乎
赠金好退,三个细节躲不开
第一,退的是赠金,不是现金。钱留在账户里,后续API计费先从赠金扣。翻译一下:送你一周免费用量,不是赔你损失。知乎
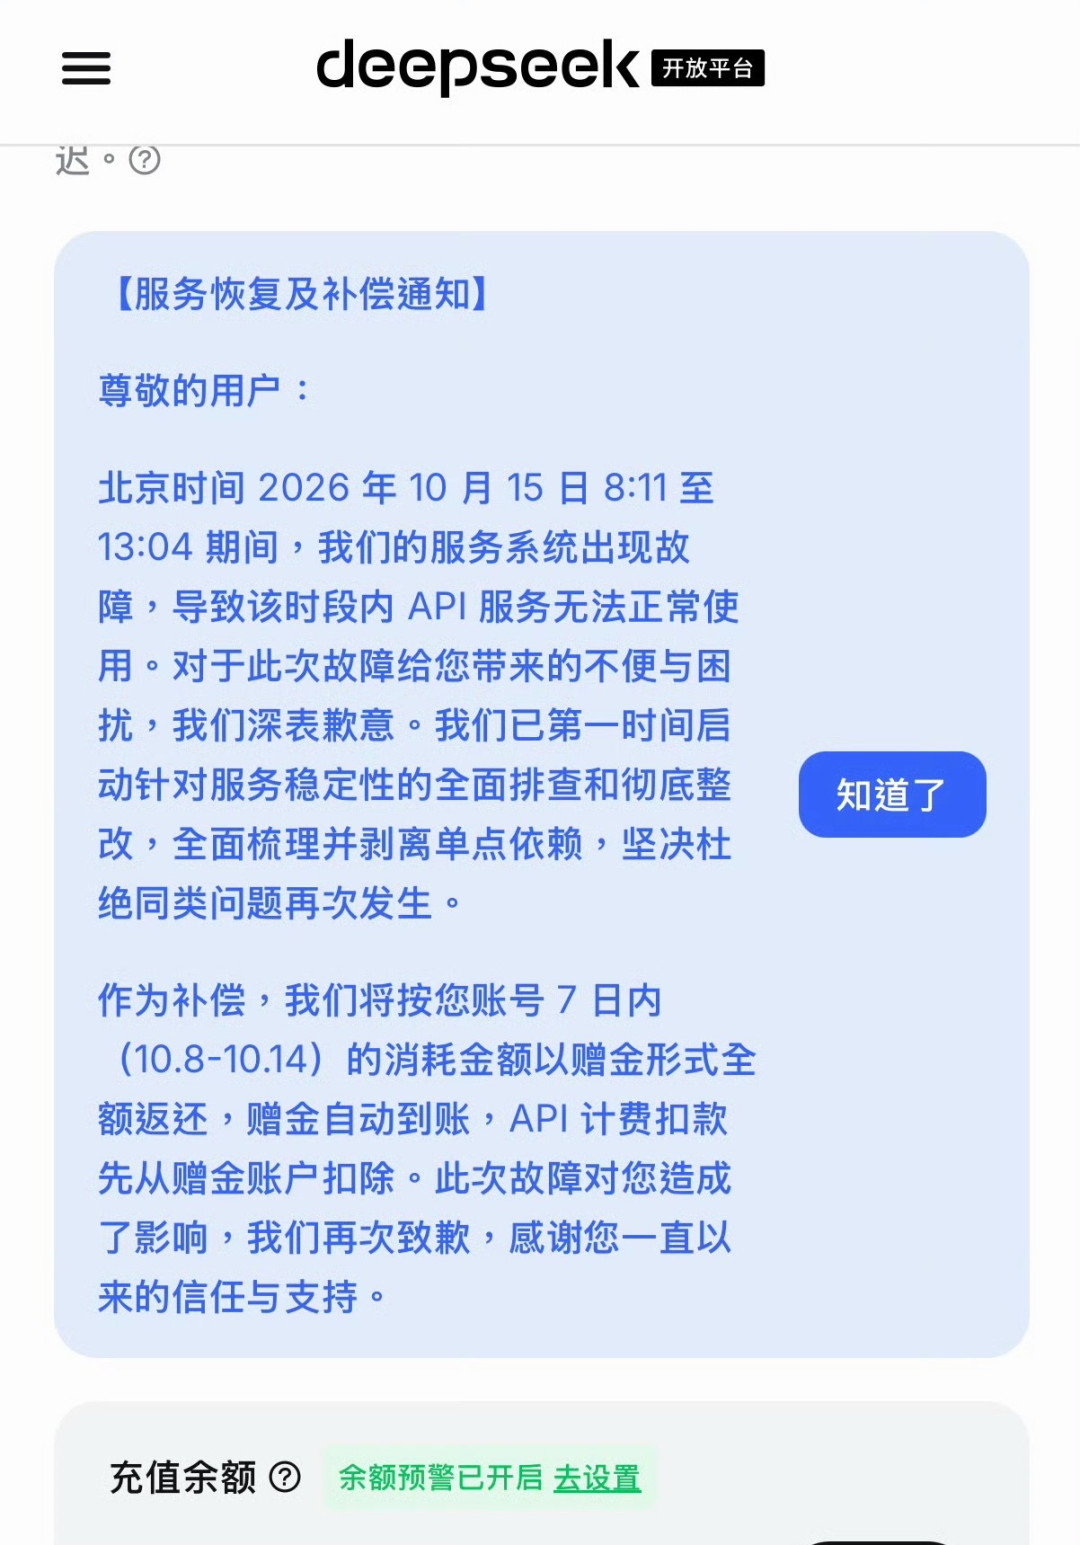
第二,补偿基数和你当天的损失无关。算的是10月8日到14日这一周的API消耗——上周用得多退得多,上周恰好没用,那就只有几块钱。知乎
第三,根因至今成谜。通知里倒是写了整改方向「全面梳理并剥离单点依赖」,但具体哪儿坏了没交代,SLA承诺也没见到,第一财经问询截至发稿未获回复。下游也跟着遭殃:挂了DeepSeek模型的WorkBuddy,随后宣布给用户补500积分。微博知乎知乎知乎
真正疼的不是钱,是断掉的活
对轻度用户,宕机只是「晚点再问」。但把AI嵌进工作流的人,5小时停摆就是实打实的停工:客服无人应答、文档流水线排队、代码任务卡在半路。知乎
前面那位网友的公司,DeepSeek一断,大家临时切到K3,部门领导的项目还没跑完,5小时的额度瞬间被吃光知乎。更疼的是,任务中途换模型,上下文全丢——改到一半的文档、跑了一半的工具链,都得重来。更无奈的是连带效应:当天不少人逃向其他云端模型,发现对面也变成了「极度拥堵」。而这并非偶然,DeepSeek状态页记录显示,9月2日、15日、10月12日均有中断,9月以来另有9次「性能下降」。时代财经统计,年初至今服务异常达44次。海外同样如此:9月3日美东时间,ChatGPT、Claude、Grok在92分钟内相继故障;Anthropic也公开承认过,需求涨势跑赢了自家基建扩建。当整个行业的算力余量都紧张,「AI即服务」就有个天生的软肋:机器不在你手里,业务连续性就不在你手里。小红书知乎知乎
本地不是万能药,但得留一手
那两天,「本地部署」「离线大模型」肉眼可见地成了社交平台高频话题。但先别急着欢呼,本地也不是万能药。知乎
现实情况是:消费级电脑跑的本地模型大多经过量化,写文案、查资料、轻量对话,8B级小模型就能顶;但大规模代码、长文档分析这类重活,质量和速度跟云端旗舰仍有明显差距。备胎的意义是保底线不断,不是替代主力。
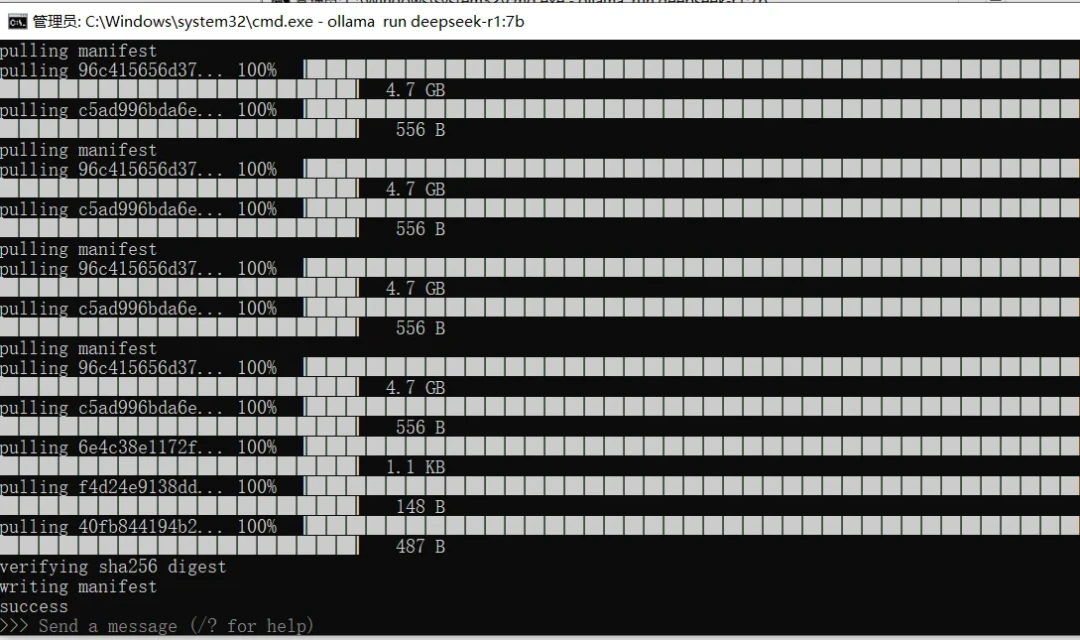
所以更稳的姿势是双轨:平时云端干重活,自己机器上常备一套随时能起的本地模型,守住那些「不能停」的轻量流程。顺手给自己留道演练题——如果云端消失5小时,你的机器能接住多少活?
赠金到账了,断掉的活没人赔。订阅制AI时代,租来的算力终究是租来的;自己机器里留的那一手,才是真安全感。