













10
15
748GB内存塞进桌面,英伟达这台机器卖67万
2026-10-08 22:05:14
0点赞
0收藏
0评论
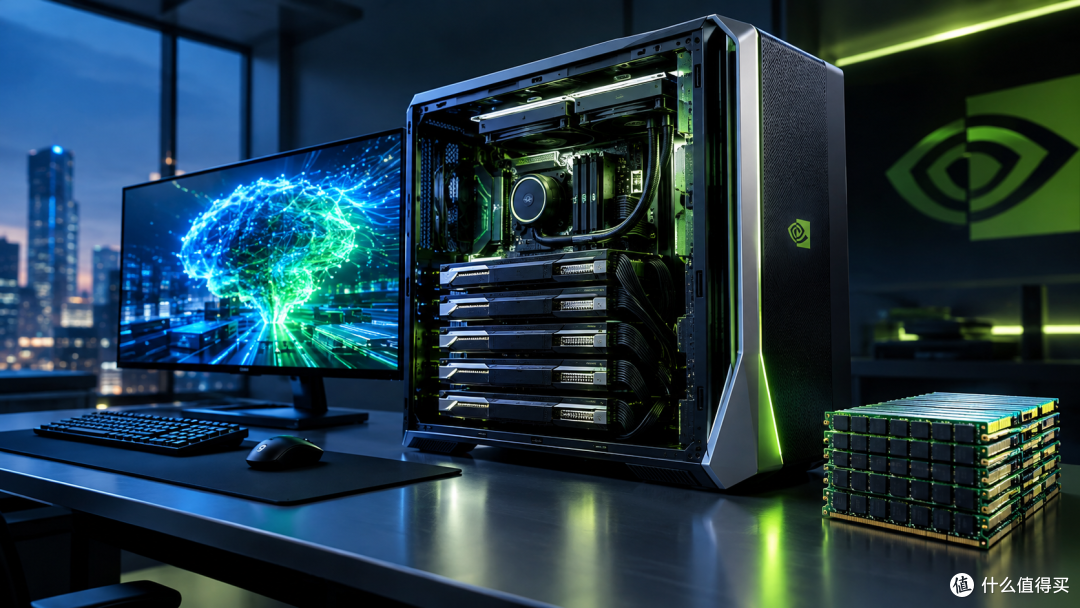
英伟达昨晚给 DGX Station 开了一个 Windows 版本。整机 748GB 统一内存,官方说法是能在桌面上跑 1 万亿参数的模型,价格约 10 万美元,折合人民币 67 万左右。
一边跑模型,一边用 Office
它要解决的是一个很具体的麻烦。今年早些时候那版 DGX Station 换了 GB300「Blackwell Ultra」,只支持 Linux,于是企业里的开发者被切成两半:模型跑在 Linux 上,Office、邮件、审批流在 Windows 上,同一份活干下来得养两套环境。财富 500 强里大多数公司的采购、账号体系和安全审计本来就围着 Windows 建,为了跑模型再招一支 Linux 运维队伍,这笔常年开销比机器本身还贵。Windows 版把这段路抹掉了,不换环境,算力直接接进现有桌面。
748GB 是两段内存加出来的
748GB 不是一块大显存,是两段内存加出来的数,来历完全不同。GPU 侧 252GB HBM3e,带宽 7.1TB/s,比上一代 GB200 最高的 192GB 涨了一截;CPU 侧是一颗 72 核 Grace 芯片配 496GB LPDDR5X,两边靠 NVLink-C2C 连起来,链路带宽 900GB/s,对外表现成一个 748GB 的池子。
这两个数要分开记:252 和 496 的带宽差约 18 倍。模型权重可以睡在便宜的那 496GB 里,真正算起来、要反复读写的那部分必须待在 HBM 上。池子总量决定你装不装得下,HBM 那段决定你跑起来顺不顺——它像一间带地下仓库的车间,不是把车间本身扩到 748GB。显存压力确实在缓解,新的 NVFP4 精度下,稠密低精度算力比上一代提升约 50%,精度与 FP8 的差距通常在 1% 以内,显存占用比 FP8 少 1.8 倍、比 FP16 少 3.5 倍。100 万行代码、上万亿参数这些说法,靠的就是这一档。
官方给的算力是单机 20 PFLOPs。这个数字前面写着一个前提,NVFP4,同一台机器换成 FP8 或 FP16 重算一遍,20 PFLOPs 会明显往下掉。厂商报算力时把精度写在哪儿,比数字本身更值得先看两眼。整机功耗 1600W,这是插在办公室里的设备,电路和散热得提前确认,不是随便找个工位就能放下的东西。
它也不是唯一选项。AMD 一个月前发布的 Threadripper Halo Station,用 96 核 Threadripper Pro 9995WX 配 2 到 4 张 Instinct MI350P,HBM3e 容量可以在 288GB 到 576GB 之间扩展,系统内存最高 2TB,预计 2027 年上市,价格可能在 10 万到 15 万美元之间。留给英伟达的窗口期大概是三个季度。
把租云的账单写下来比一次
账要这么算。按每天跑 8 小时、电费 1 元一度粗算,一年光电费四千多块,24 小时不关机的话这个数会涨到 1.4 万元左右,机位、空调和运维还没算进去。采购价约 10 万美元,按三年折旧摊平,每年固定成本二十多万。你打算把它放办公室之前,把同样负载租云一年的账单写下来,跟上面这几个数比一次:差距不大,说明你还没到需要它的规模;卡常年不闲、模型又要读客户内部资料,答案通常反过来。
有正在算这笔账的,把你们的数发在留言区,我挺好奇这道题在真实团队里长什么样。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~








