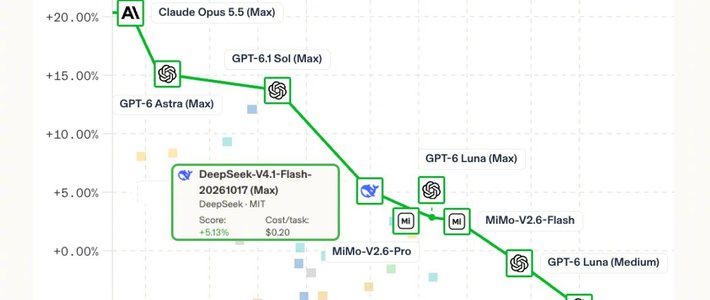
10月20日,Arena更新榜单:DeepSeek-V4.1-Flash-20261017(Max)位列Agent Arena开源模型第一、总榜第11,评测基于约7500次真实使用会话,相对平均模型的综合净改善约5.1%,单任务成本中位数约0.20美元。 总榜第11的含金量不是"又一个开源第一":排在前面的10个位置全部属于闭源模型,而它的单任务成本比排名更高的对手都低。东方财富
这个榜考的不是考题,是真实会话
Agent Arena不是让模型刷静态题库。和考卷式基准不同,它的成绩来自用户真实使用会话:干没干成、用户是否买账,直接决定排名。这也是10月中旬小米MiMo-V2.6-Pro曾凭以登顶开源榜的那把尺子。快科技
Arena公布的分项更能说明问题:任务成功确认、用户正负反馈、Bash命令执行可靠性、可引导性四项指标中,1017全部位列开源模型第一,其中任务成功确认一项在总榜上排第8——哪怕只算"把活真正干成"这一个维度,它也只输给七个闭源模型。 IT之家同步转述的榜单结论还有一条:工具幻觉问题少、已进入性能成本帕累托前沿,这正是Agent开发者最在意的两个指标——前者决定它会不会编造一个不存在的工具结果,后者决定它值不值得批量投产。东方财富IT之家
第11名是抢回来的,不是捡到的
开源榜第一这个座位,十几天前还不在DeepSeek手里。10月中旬,小米宣布MiMo-V2.6-Pro在Agent Arena开源模型榜单排名第一;按其公告所引Arena数据,MiMo Pro每任务成本约0.11美元,比当时位列开源第2的DeepSeek V4.1 Flash还低15%,是性价比曲线上的另一个极端。 1017版本上线后,DeepSeek先是在10月19日拿下Code Arena: WebDev开源第一,随后在10月20日把Agent Arena的座位也夺了回来,整个开源头部位置像走马灯一样换人。微博智东西
含金量因此有了对照组:这不是在无人区称王,而是在国产开源互相追咬的换座节奏里夺回的座位。需要同时看清的是,其整体排名仍落后于顶尖闭源模型,只是花钱比这些对手少得多。 第11名证明的是开源阵营与顶尖闭源的差距在收窄,而不是已经抹平。未来图灵
便宜是怎么算出来的
发布当天这事看着并不炸裂:网页、App、API同步切到1017,官方公告一句话"能力升级,价格不变",模型权重照常放上Hugging Face与ModelScope。 涨分集中在最考Agent的基准上:Terminal-Bench 4.0从31.2涨到42.3,提升35%,官方对这次更新的定位也只是V4.1-Flash的小版本迭代。知面李建泉
账本的另一半是价格结构。输入缓存命中时,每百万Token输入价在高峰时段0.04元、空闲时段0.02元,综合成本约为Kimi K3的1/10。 在DeepSWE v1.1这类一整条开发链路的测试上,1017做到了77.0%的Pass@1,对应约0.2美元一个任务;同场约73%分数的Claude Opus 5,单任务花费要70多元。智东西算法一只狗36氪
同一天开放的自研搜索Search/Fetch接口补上了最后一块:Agent联网检索按每千次成功调用5元计费,11月1日零时起才正式收钱——检索这一步不收钱之前,模型便宜只是前半句账单。知乎
含金量不包括什么
便宜的另一面是时间。开发者Ibragim Badertdinov用十道"人一小时能干完、模型常翻车"的生产脏活实测:DeepSeek每任务平均0.045美元,是Claude Opus 5.5的38%、GPT-6 Astra的约1/5.8;但平均耗时2分38秒,Opus只要37秒,它平均要走15.3步才交一份活,而Opus是3.7步。 它不是想得更少,而是在"演算、验证、回滚、再试"的闭环里用步数换准确率——把试错做得足够便宜,才是这次更新真正的机关。知面
榜外也有短板:HLE硬知识测试42.6分,落后Opus 5近14分;NL2Repo、ProgramBench同样差一截——知识密集型和大型项目重构类任务,它还不是最优解。 稳定性同样要计入:发布前两天,10月15日DeepSeek网页端与API曾中断近5小时,官方按用户前一周消耗全额返赠金,媒体统计这是年内第19次服务中断——对把Agent接入生产流程的团队,这是选型时绕不开的变量。李建泉知面
围绕这次更新的"模型指纹"截图风波也不宜计入榜单可信度:检测器把新模型输出判得更像GPT-6 Astra,有人据此猜"套壳"。但涉事工具ModelTrace的README自己写明:未被指纹库收录的模型也可能被归到已有候选中,结果不能当作决定性证据;1017权重已公开,核查有比截图更扎实的入口。 榜单成绩本身产生于Arena端的真实用户会话,这张截图既不能给登顶加分,也不构成减分项。AI造物局
对能接受"夜里跑批量、闲时生成代码"的用户,总榜第11加单任务一两块钱,意味着以前舍不得交给AI的活现在可以放开手让它试错;对实时交互场景,三倍耗时仍是真实成本。接下来看两个信号:11月1日搜索接口正式计费后,Agent整套账单是否还站得住;以及被MiMo-V2.6-Pro盯上的开源榜首,能坐几天。