这两天刷 AI 圈,你大概率刷到过同一个词:ASD-STE100。
10 月 2 日,Karpathy——就是那位 OpenAI 创始成员、前特斯拉 AI 总监、发明了 “vibe coding” 这个词、今年 5 月刚加入 Anthropic 的 Karpathy——发了条关于"怎么理解 AI 输出"的推文,然后整个圈子炸了。微博上有博主一句话总结:“ASD-STE100 + HTML 现在成了 AI 圈的新魔法数字”,这条微博一天不到拿了 72 个赞、41 次转发。小红书当天就有人实测,知乎有人拉出四个模型做受控测试,机器之心、36氪连夜出了解读稿。知乎微博36氪

有意思的是,这次火的不是新模型、新产品,而是一套 40 年前给航空维修手册定的写作规范。Karpathy 拿它治的病,每个重度 AI 用户都熟:AI 的废话。
他到底说了什么:答案已经生成,理解还没发生
这条推文的核心判断是一句话:我们今后会花多得多的时间,去理解大模型的输出。知乎
逻辑不复杂。AI 干的活越来越多——写分析、写代码、跑流程,人的角色就上移成监工:看结果、查问题、决定采不采用。瓶颈从"生成"挪到了"理解"。Karpathy 之前在红杉 AI Ascent 大会上还说过一句更直白的:你可以外包你的思考,但你不能外包你的理解。
现实是,AI 的输出越来越长、修辞越来越花。你问一个问题,它秒回几千字,读完还是不知道第一步该干嘛。有微博博主感慨,这已经是今年第三次和 Karpathy 产生共鸣:第一次跟他学用 LLM 搭知识库,第二次是语音输入,这次是理解输出——每次都踩在普通用户的痛点上。微博
所以这条推文给了一组"让输出变得能看懂"的办法,一共四级,一级比一级狠。
第一级:让 AI 像航空维修手册一样说话
先说火出圈的 ASD-STE100。
它的来历是这样的:上世纪 70 年代,欧洲航空维修越来越国际化,同一本英文维修手册,要给不同国家、不同语言背景的技师看。一句话被读出第二种意思,可能就是一次维修事故。于是航空业主动给英语上枷锁,逐步发展成 ASD-STE100 规范。最新版 Issue 9 包含 53 条写作规则、约 900 个批准使用的基础词,还有约 1200 个建议避免并给出替代写法的词。机器之心
它的精神概括起来就几条朴素规则:一个词只有一个意思;一个东西从头到尾只叫一个名字,不许为了显得"文采丰富"轮换同义词;短句;主动语态;一句话只说一件事。小红书

发现没有,这套规则跟大模型的写作习惯完全反着来。模型爱换着花样用同义词、爱堆长句、爱打比方,ASD-STE100 故意让语言变"无聊",换来的是零歧义。
Karpathy 的用法就一句提示词:
Explain [topic] in 80% ASD-STE100
为什么是 80%?因为完整规范是给专业技术文档设计的,日常问答一板一眼全执行会僵硬得像在读波音手册,留两成弹性刚好。机器之心
第二到第四级:能画图就别写字,能做网页就别画图
Karpathy 自己认为文字只是起点,后面还有三级:
第二级,图表。 提示词就一句 “Explain this as a diagram”。一张图比一堵字好消化,而且哪怕这张图只服务你一个人、看完就再没人用,生成它也是划算的。
第三级,网页。 “Give me the answer in HTML”。现在模型写前端已经强到能直接给出带布局、动画、交互的页面。机器之心的解读里举了个好例子:想理解神经网络里的"学习率",文字告诉你"太小收敛慢、太大可能震荡";网页直接给你一个滑块,你自己拖着看小球的下降轨迹实时变化。这时候模型已经不是在"解释",而是临时给你做了一个帮你理解的小工具。机器之心

第四级,他最看好的:讲解视频。 提示词是 “Make a 3b1b-style explainer video on [topic]”。3b1b 就是 3Blue1Brown,那个用程序化动画把抽象概念一步步"演"出来的知名科普频道。配音接 ElevenLabs 的 API,没有密钥也可以让模型帮你找能本地跑的免费替代。Karpathy 说这条路"真的开始行得通了"。推文发出后,一位叫 Tibo 的开发者马上实测:只给了一句"解释一下 Shazam 是怎么工作的",模型就生成了一段专门讲解 Shazam 原理的视频。
四级方法背后是同一个概念,Karpathy 管它叫"大型、定制、用完即弃的软件产物"(large, custom, disposable software artifacts)。逻辑是:代码生成几乎零成本了,过去不值得专门做的东西,现在可以随手做、看懂、扔掉。理解本身,也变成了一件可以被 AI 加速的事。小红书
实测盘点:有用,但不是对谁都有用
到这里如果你已经想抄提示词了,先等等。中文互联网这两天反应速度极快,实测结论分三类,都值得看。

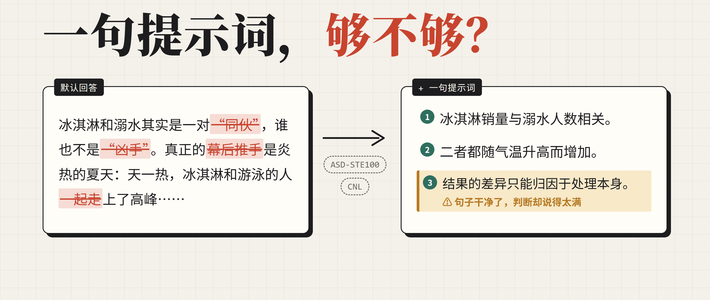
第一类:明显有用。 知乎博主"诚然"做了个中文受控小测试,用 DeepSeek V4 Pro、GPT-6.1-sol、Kimi K3、GLM-5.3 四个模型,对比四种提示方式:默认、只加 ASD-STE100 的名字、只加 CNL(受控自然语言)的名字、手写一套具体规则。结果很直观:GLM 默认回答里把冰淇淋和溺水称作"同伙"“凶手”,Kimi 满篇"幕后推手"“我推你”,加了规范名字之后,这类修辞确实明显减少,换成短句和直接叙述。知乎

第二类:没多大用。 同一个测试里,GPT 的默认输出本来就很克制,自己就会写"可能"“如果其他条件也控制得当”,加了名字之后变化主要在段落组织上,“看不出有什么额外的好处”。诚然的结论很直白:名字管不管用,还得看模型原本是怎么写的。也有网友把普通回答和 ASD-STE100 版本并排对比,结论是"好像也没什么区别"。毕竟简单问题模型本来就答得短,套规范不会天翻地覆。小红书上甚至有一篇标题就叫《Karpathy 给了你四条新想法,但我建议你不要》的帖子,作者实测后认为:这些方法的落地非常依赖模型能力,现在效果不尽如人意。知乎机器之心小红书
第三类:最需要警惕的——好读不等于对。 这是整个测试里最有价值的发现。DeepSeek 的 CNL 组在介绍随机对照实验时写出了这样的句子:"两组唯一的差别,就是’是否接受处理’。因此,结果的差异只能归因于处理本身。“句子短、指代清楚、读起来相当干净——但它把一个需要前提和限定的判断,写成了排他结论。对照组里 ASD 组和具体规则组用的都是"主要来自”"更可能来自"这种留有余地的说法。诚然的总结一针见血:文字读起来像技术手册,并不代表内容就经过了技术审查。知乎
还有个细节:模型有时会在回答末尾自称"已遵循 STE100 原则"——这同样不能当证据,要看它实际写出来的东西做没做到。
谁该用、怎么用:三步走,从成本最低的开始
把正反两边的实测拼起来,适用人群其实很清楚:
值得试的: 经常要读长技术解释、多步骤操作指南的人;VibeCoding 和 Agent 用户(工具描述、报错信息、Agent 之间的指令,恰恰是误读成本最高的场景);写 README、写文档、做知识管理的人。
不必折腾的: 日常只问天气菜谱的轻度用户;手头模型默认输出已经干净的(比如测试里的 GPT);以及需要 AI 提供情绪价值和文采的场景——这套规范会把比喻全杀掉,包括那些好的比喻。
具体上手,建议按三步走:
第一步:零成本,一句话试试"名字锚点"。 不用背 53 条规则,直接在提示词里提规范的名字就行。中文措辞可以直接抄诚然调过的版本:
请借鉴 ASD-STE100 的受控表达原则,用自然中文解释。保留必要的前提、适用范围和不确定性。
注意最后那半句是关键,专门防"好读陷阱"——规范治的是歧义,治不了过度自信,限定条件得你自己点名要。如果你更需要把术语一个个定义清楚、逻辑关系理顺,换这句:
请使用受控自然语言(CNL)风格的中文解释,保留必要的前提、适用范围和不确定性。
用"借鉴"而不是"严格遵守",因为我们只是借用这套英文规范的表达原则写中文,本来也验证不了输出是否完全合规。知乎

第二步:不满意,再补自己的规则。 不用全抄,挑 5-8 条贴合你场景的:短句、一事一名、主动语态、保留限定词。网上还流传一个更工程化的玩法:让模型随机抽取过去一周你和它的 10 段交互,用 ASD-STE100 逐条检查——哪些回答当时不够清楚、哪里产生了歧义、套用哪条规则会更好——最后把真正有效的那几条写进用户级 AGENTS.md。让真实痛点决定哪些规则进你家,比无脑全套用聪明得多。
第三步:重度用户直接上 skill。 其实早在 Karpathy 发推前三个月,就有人把这套规范做成了开源的 asd-ste100-skill,专门用在工具描述、报错信息、Agent 间指令、system prompt 这些场景,还分了两种模式:Strict 模式给误读成本高的内容(程序步骤、工具描述、Agent 指令),STE-flavored 模式给 README 和解释性文本——保留句长、主动表达这些原则,但不把词汇锁死。这基本就是"80% ASD-STE100"的产品化。另外,数学和技术内容还有一条网友补充的路线:让 Agent 用 TeX 直接输出 PDF 技术报告,公式、代码、示意图各得其所。机器之心
最后,两个观察信号
这件事的后续,建议盯两个点,比急着背提示词更有意义:
一是模型会不会把"理解友好"直接内化。诚然和小红书那篇反方帖子其实押的是同一个方向:这些技巧现在依赖模型能力、效果参差,但如果方向被验证,厂商大概率会把它做进默认输出。到那时候,今天手动加的提示词就成了过渡期补丁。
二是第四级"讲解视频"什么时候从开发者玩具变成一键功能。Karpathy 最看好的恰恰是这一级,但目前实测传播最广的还是第一级文字规范——中间的落差,就是产品和模型接下来要填的坑。
回到开头那个问题:这套 40 年前的航空规范,值不值得你今天就试?我的答案是:一句话的成本,值得;但请带着"好读不等于对"这个前提去用。毕竟 Karpathy 整条推文真正想说的不是让你学航空英语,而是——AI 替你干的活越来越多之后,看懂它干了什么,正在变成你自己的核心工作。











