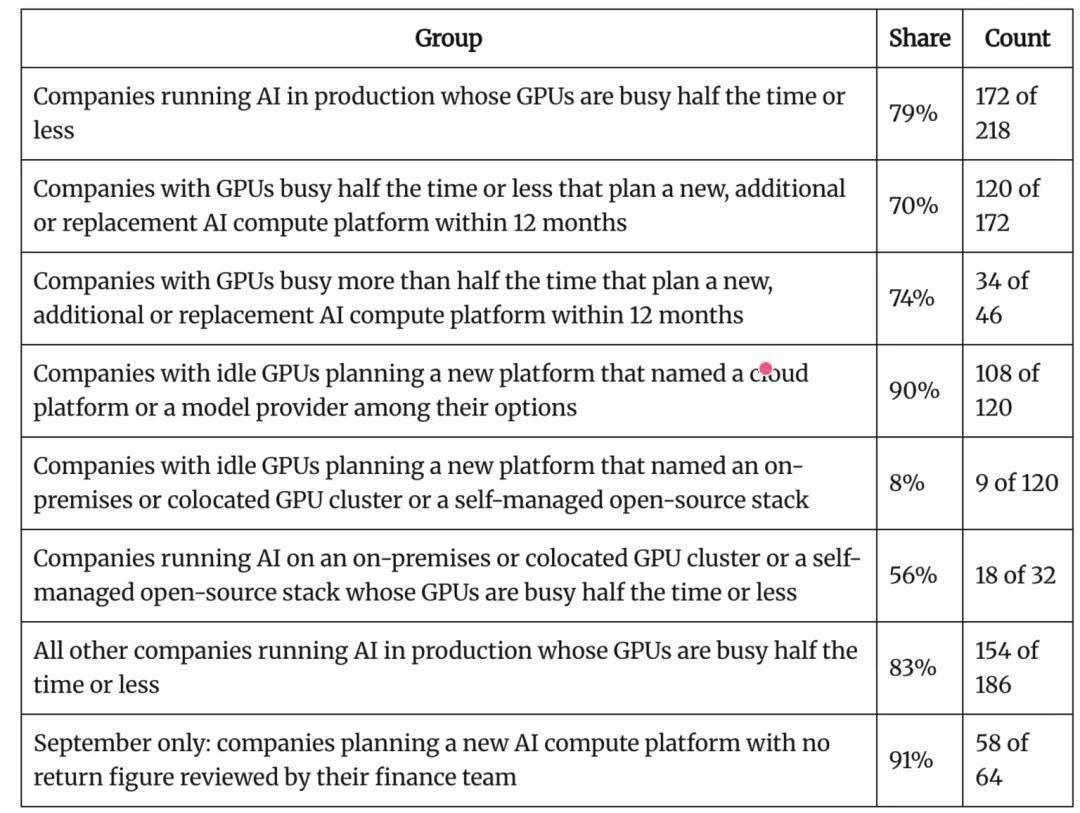
AI 算力军备竞赛打到今天,出现了一个魔幻数据:79% 的企业受访者表示,自家 GPU 算力至少一半时间完全闲置。同期还有 70% 的企业计划在未来 12 个月内新购 AI 计算平台。你花真金白银请回来的"一万个工人",怎么就开始偷懒了?这本账不只是大厂会碰上,很可能你的桌面上那台主机也一样。机器之心
先把证据边界划清楚
这是 VentureBeat 旗下研究机构对 2026 年 7—9 月三轮 VB Pulse 调查的汇总:385 名来自员工 100 人以上机构的合格受访者。闲置率在三个月里稳定在 77%—81%,79% 是最新一期。更值得注意的是,计划换平台的企业里 91% 拿不出经财务审核的 ROI 测算。它不能证明 AI 是泡沫,但"钱花了多少"和"活干了多少"之间的落差,是真实存在的。机器之心
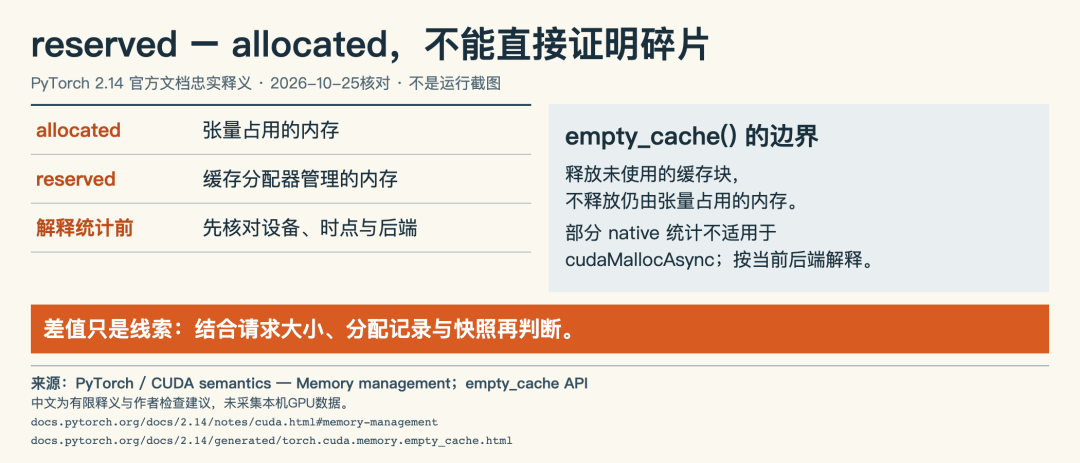
为什么显存满了,算力却没用满?
GPU 并行圈一句话就能说透:显存是仓库,算力是工人,仓库满了不代表工人在搬货。常见的"闲着"分三种:知乎
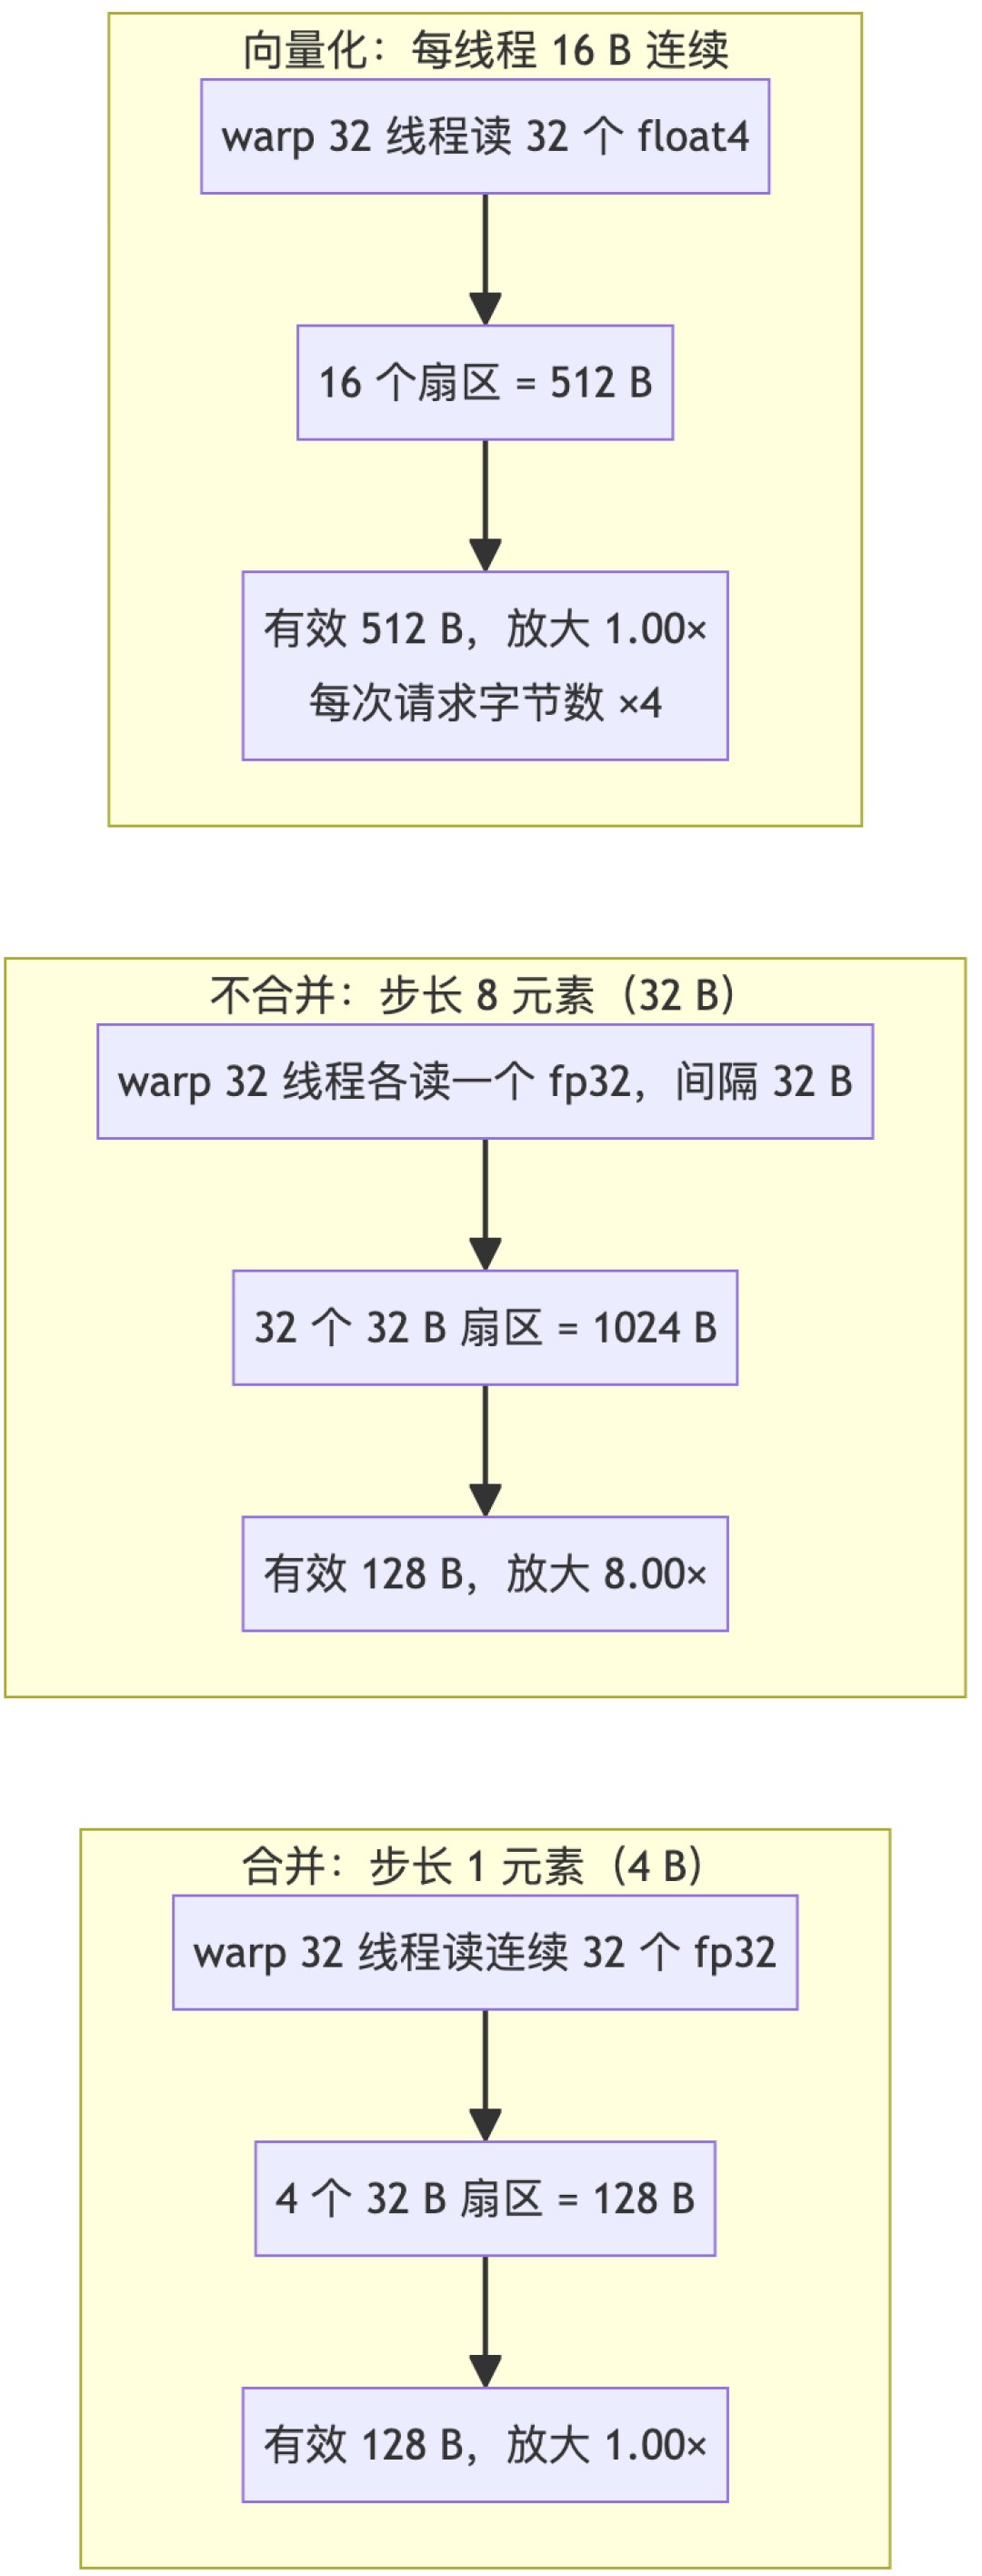
内存墙:逐元素运算这类操作算得飞快,但大部分时间耗在从显存读数据、写回结果上,计算核心只能干等带宽;
并行任务太少:哪怕模型参数把显存塞满,只要 batch size 只有 1、2,就等于 100 个工人搬 2 件货。多数工人还是空着手,计算单元大面积闲置;知乎
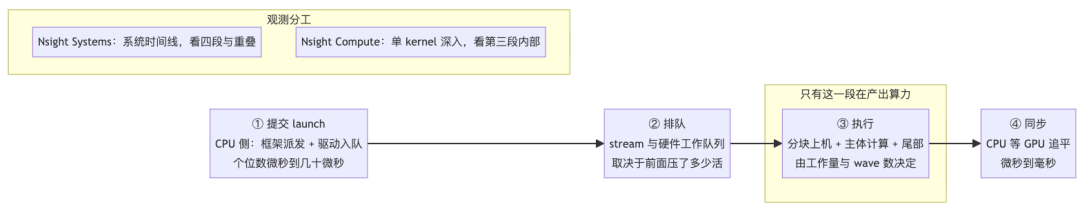
发射开销吃掉时间:用 PyTorch 写代码看着在指挥 GPU,其实是 CPU 每发射一个算子要花 5—15 微秒,而 H100/B200 算一个小矩阵只要 2—3 微秒——GPU 大部分时间在等下一条指令。这时候你盯着 nvidia-smi 利用率满屏 100%,其实全是泡沫。知乎
第三种正是 CUDA Graph 在推理侧火起来的原因:把几百个算子的发射"录制"成一张整图,CPU 只发一次,GPU 内部的等待空窗直接消失,Decode 延迟近乎腰斩。vLLM 还靠 Chunked Prefill 让 Prefill 阶段也蹭上这份红利——但要不要上,得先分清自己卡在 CPU 发射还是 GPU 计算上,账要按阶段算。知乎
闲置的卡和爆掉的账单同时存在
讽刺的是,调研里企业的钱正在另一边哗哗地烧:员工疯狂调用模型 API,Uber 几个月就烧光了全年 AI 预算,"Token 狂欢"被迫收官;而自建 GPU 却在机房吃灰。计划换平台且 GPU 闲置的企业中,90% 投向公有云与模型 API,仅 8% 考虑扩建本地集群。Gartner 还预测,到 2028 年单个 Agent 工作流的推理成本要涨 5 倍以上——不是 Token 单价变贵,而是 Agent 吃 Token 比单价降价快得多。机器之心
普通兴趣玩家能抄的作业
租卡、买卡之前先测瓶颈:卡在带宽和并行度不足上,答案可能是加大 batch、开混合精度;卡在发射开销上,答案才是 CUDA Graph;
本地跑推理记得开启 KV Cache 和上下文缓存:NVIDIA 工程师实测,Claude Code 场景下后续请求 85%—97% 的上下文可缓存复用,而缓存读取价格低至普通输入的 1/40 到 1/10。省下来的不只是算力,还有真金白银;机器之心
真用不满的卡,评论区已经给出路子——按时租出去,或者干脆按需租用消费级显卡,用完即关。
当然,有一部分"闲置"是故意的:为业务高峰预留冗余、按项目周期屯卡,实验室利用率天天 80% 反而意味着抢卡大战。所以这份调研真正扎心的结论只有一句:比闲置更可怕的,是你不知道卡到底在闲什么。