
这个月,本地AI迷你主机市场有点热闹:极摩客EVO-X5 Pro正式开售,192GB+2TB版定价46999元,号称支持本地运行320B参数大模型。TOPC TXA2-495紧随其后发布,2TB版发布价45999元。两台机器搭载的都是AMD新旗舰锐龙AI Max+ PRO 495,统一内存192GB。微博知乎
性能是真的。实测中DeepSeek-V4-Flash级大参数模型每秒生成14个token,能用,但不算快。知乎
35B级轻量模型则直接从每秒62个token拉到90个,已接近云端模型的输出速度。但价签也摆在那:4万6,快赶上一辆代步车。知乎

于是另一拨人换了思路:一台买不起,就多买几台小的拼成集群——用网络连起来,一起干活。这不是野路子,三个真实案例已经摆在桌面上。
案例一:Framework把集群做进了硬件里
模块化电脑品牌Framework的新款Desktop这个月也开启预售,同样搭载PRO 495+192GB,售价6799美元,而上一代128GB版才卖3449美元。内存涨价的刀,中美用户一起挨。微博知乎
Framework自己都表态,现阶段定价已经是"中短期内获得的192GB内存最低价",首批货还因为DRAM供应问题直接售罄,11月才能发货。微博
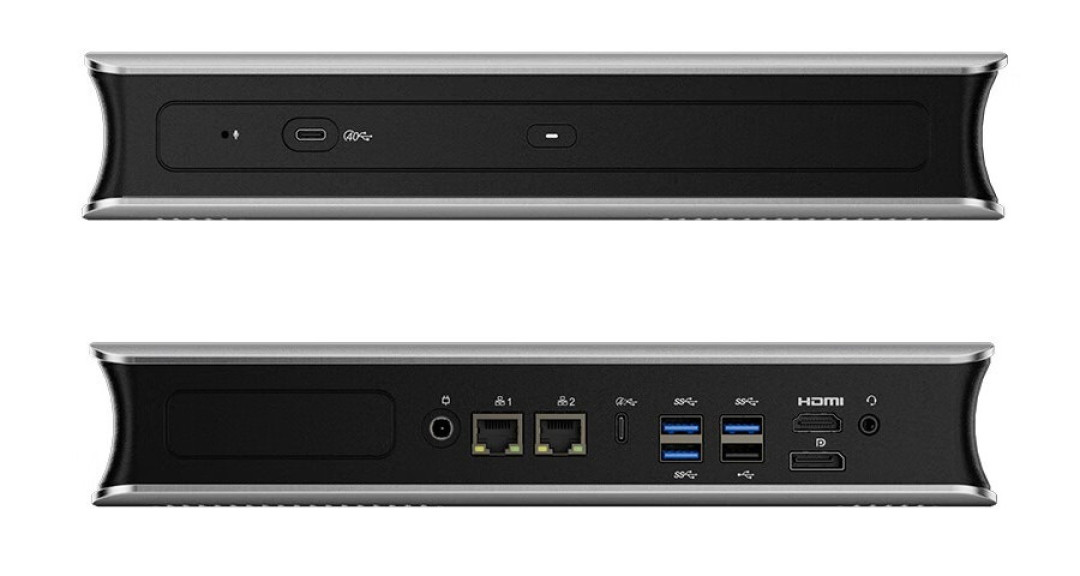
它的设计很有意思:PCIe插槽尾部做成开放式,插一块Intel E810网卡,多台机器就能走RoCE协议直接通信,官方标称50Gbps,还能用张量并行加速推理;主板是标准Mini-ITX规格,可以直接插进机架。这个姿势摆明了:不是一台机器单干,是一堆机器组团干活。知乎

案例二:20台机器进了教室
10月15日,一条视频展示了另一种玩法:20台迷你主机搭出一套AI教学集群,主角正是4万6一台的极摩客EVO-X5 Pro。对教学场景来说,这天然比一台大机器合理——总不能让学生排队用一台主机。哔哩哔哩
案例三:国产玩家早写进了详情页
天钡NEX395,搭载锐龙AI Max+ 395,12999元,是冲着AI去的型号。知乎
单台也不弱:64GB统一内存,核显1080P高画质跑《黑神话:悟空》83帧,装得下Qwen3 Next 80B量化版(约48.5GB);详情页还直接写着,可以通过双USB4把多台设备做成集群,“要构建个人中心,可以花个十来万搞一个”。知乎

泼盆冷水:集群不是显存拼接
先说清楚一件事:这代统一内存迷你主机,单台内存带宽约256~273GB/s。而机器之间走网络,50Gbps的RoCE折合只有约6.25GB/s,差40多倍。翻译成人话:知乎
想把一个超大模型拆到几台机器上跑?速度会被网络拖死;
但每台机器各跑各的模型、各接各的用户?集群算力基本能线性叠加。
所以集群的正确姿势是"分任务",不是"拼脑子"。想流畅跑3200亿参数大模型,老实攒钱上192GB单台或者租云端;要并发、要实例、要慢慢扩容,才是集群的主场。
这条路适合谁
小工作室、教育机构:需要N个并发实例,一台1万3比一台4万6好立项,不够随时加;
手里已有大内存迷你主机的极客:单台64GB先把70B/80B量化模型跑起来,缺算力再加一台;
不推荐:只想"跑一个超大模型"的人——集群帮不了你,而且组集群还得配高速交换机、做网络调优,不是零成本。
双11就在眼前,4万6的192GB新机短期不会降价,后续批次价格甚至可能随DRAM行情继续调整。集群路线的意义在于:本地AI算力不必"攒半年、一次入场",从12999元起步,缺了再加一台。算力自由从来不是一口吃成的,是一台一台攒出来的。微博












