你有没有下载过那种「跑分天下第一」的开源模型?发布会PPT上无敌,装好之后连简单逻辑题都算不明白。
这不是个别体验。今天海外本地大模型社区置顶了一把「照妖镜」,专门抓偷背题库刷榜的模型:公开题全背过,真实任务一塌糊涂。小红书知乎
巧的是,最主流的那张榜单,刚刚把规则重写了。10月27日,评测机构Artificial Analysis发布Intelligence Index v5。第二天,Gemini 4 Carbon以59分登顶,Claude Opus 5.5(58分)、GPT-6 Astra(57分)跟在后面。知乎
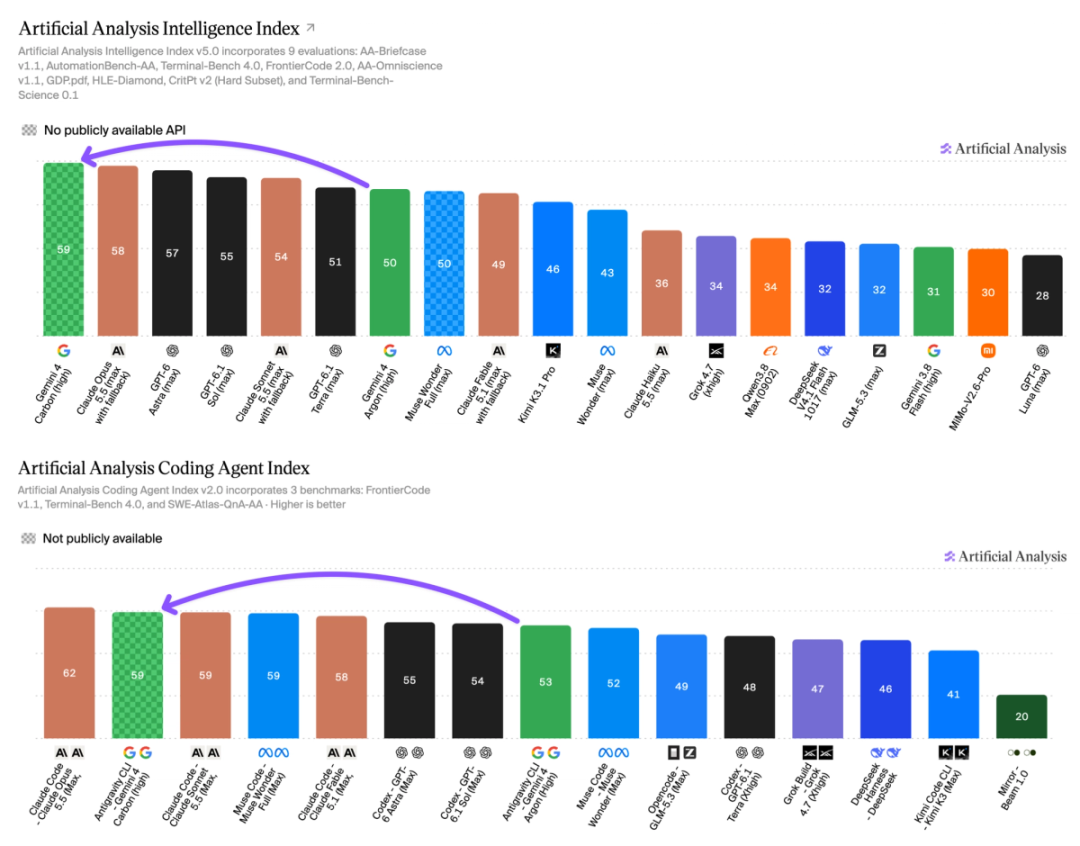
更扎眼的是开源阵营:开放权重模型与榜首的差距,从3分扩大到了12分。已放出权重的模型里,DeepSeek V4.1 Flash-1017和GLM-5.3只拿到32分。知乎
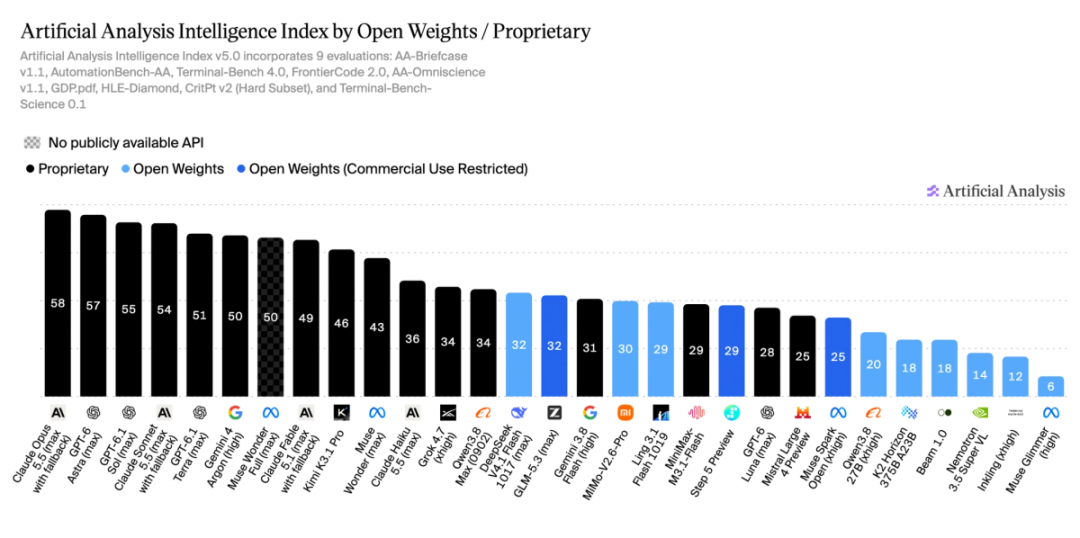
开源模型一夜之间「变笨」?r/LocalLLaMA有帖子直接喊话要找AA的替代品,抱怨GLM、Qwen要么没被收录、要么权重很低。知乎
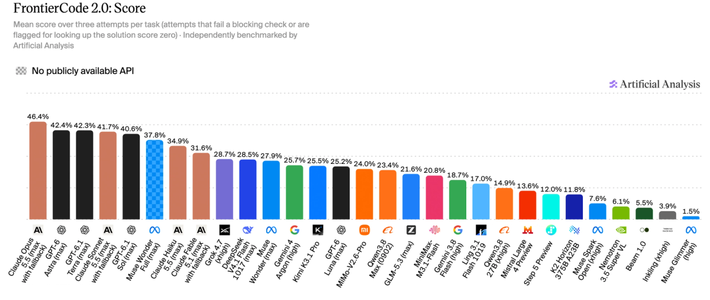
先别急着开麦。新版共有9项评测,知识工作、编程、科学、通用能力各占四分之一,60%的总权重换成了私有测试集或不公开答案;新增的FrontierCode 2.0包含真实开源仓库中的132项编程任务,判定标准是「维护者愿不愿意合并」——过不了任何一项阻断性检查,这次尝试就记零分。知乎
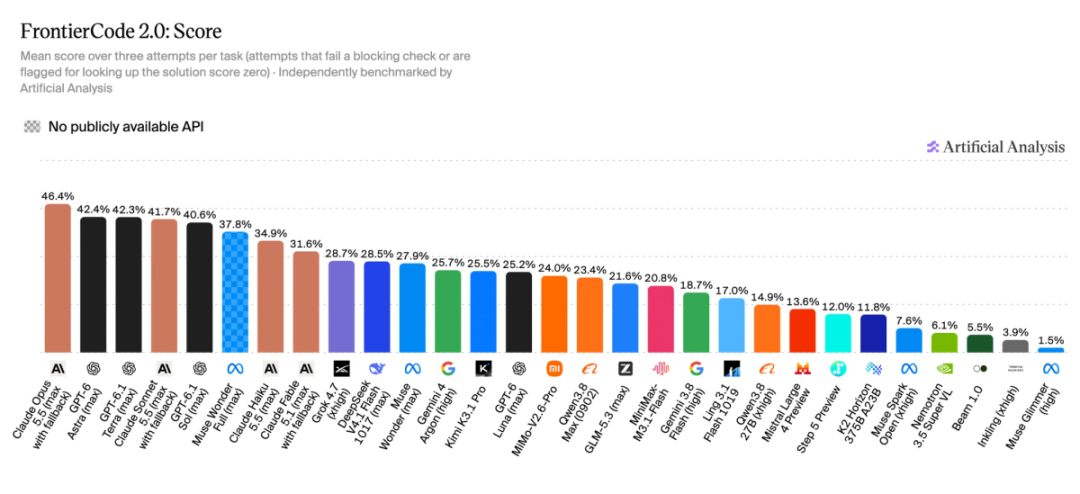
研究者Nathan Lambert提醒:题目和权重全换了,排名变化不等于能力退步;但他同样指出,私有题也让外部社区没机会检查题目本身有没有错。知乎
于是榜单陷入两边都不信的状态:公开题会被背,私有题像裁判不肯亮规则。对只想在本地跑一个模型的人来说,这不是大佬内斗,是选模型的方法要更新。
现在本地用户选模型,看什么?
第一,先看设备,再看榜单。 小红书那个126条评论的「本地大模型选哪个」,底下一致口径:多少显存、多大内存、预算多少。跑不动,榜一也白搭。小红书
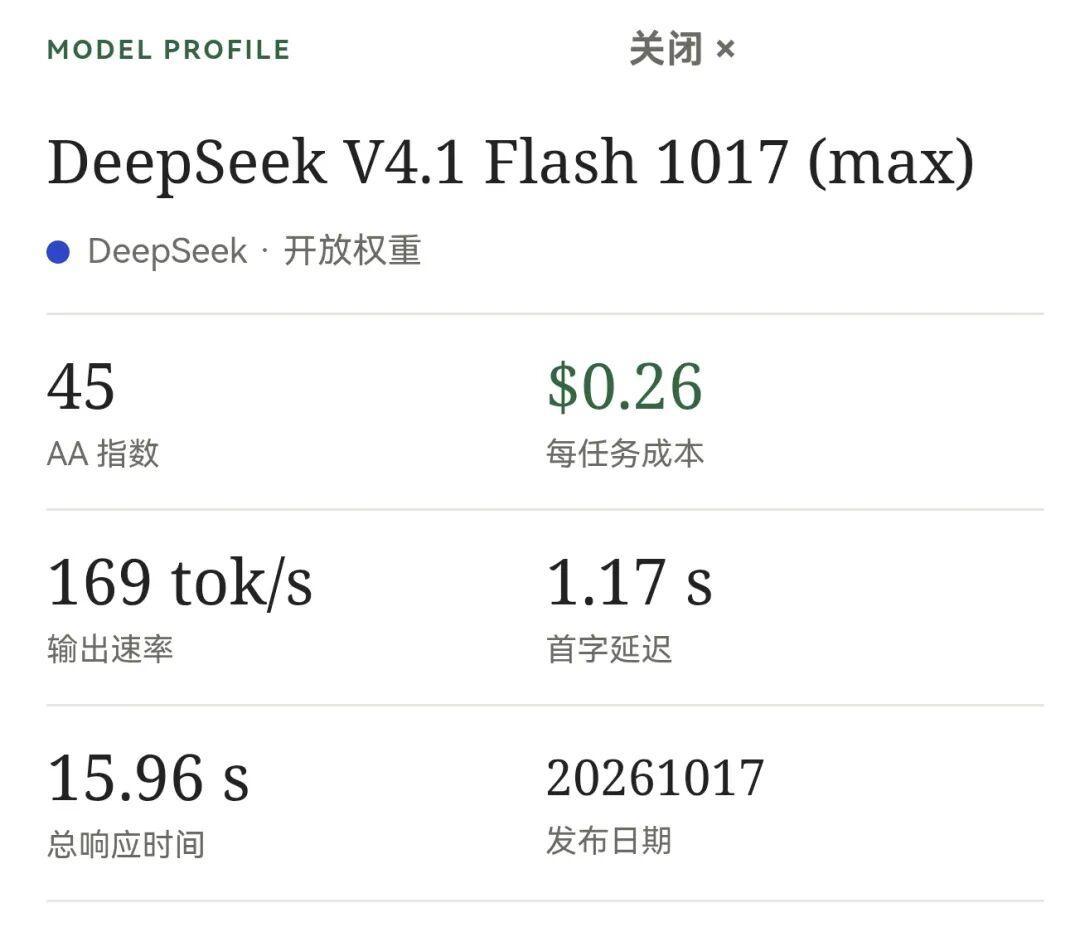
第二,别看总分,看分项。 登顶的Carbon在知识工作Elo上输给Kimi K3.1 Pro(1609对1678),在编码智能体组合指数上也输给Opus 5.5的搭配(59对62)。写代码、做长文档、处理表格根本不是同一道题,指数、每任务成本、生成速度、首字延迟这些分项数据,才是「你能不能用」的依据。知乎
第三,看社区实测,别看发布会。 声称多项核心基准反超Qwen3.8-27B的新开源33B,实测结论是「有点东西,但不多」。B站那期「开源榜第一,到底是不是刷出来的」实测视频下,高赞热评就一句——「就问你跑分高不高」。知乎哔哩哔哩
第四,终裁权:自己跑20条任务。 知乎一篇《你照着排行榜选模型,排行榜也在选你》给的做法:不看总分看分项,不看分项看自己的任务。抽20条你真实会遇到的问题,在自己机器上跑两个小时。榜单告诉你哪个模型「平均更好」,这20条才告诉你哪个「对你更好」。知乎
榜单还值得看吗?值得,但它现在只是初筛。掏大几万装机器之前,先跑完你自己的那20条。