

这两天试了 Gemini 4 Neon,最大的感受是:它的中文理解和沟通能力,已经到了很能打的水平。
它不只是能看懂中文指令,还比较容易沟通和调整。
对于日常写作、复杂问题分析,以及需要反复修改的任务,上手体验都不错。
实际用下来,再对比其他一些模型 ,差距还是挺明显的。
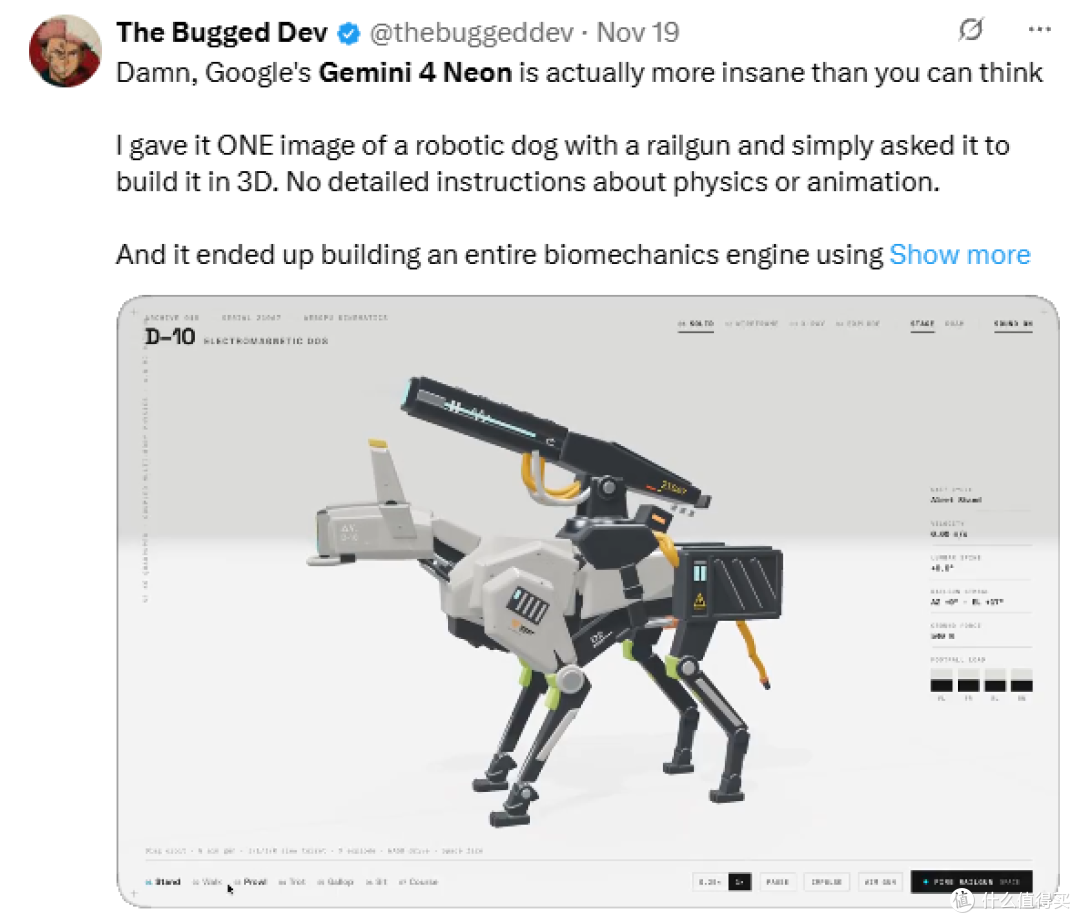
当然,这不意味着它在所有场景下都是最优选择。比如中文任务,我个人依然觉得 DeepSeek 很强;考虑到价格,DeepSeek 的性价比也非常有竞争力。
但如果你的需求不止于日常对话,还包括编程、知识工作和复杂推理,Gemini 4 Neon 值得关注。
不是旗舰,却可能是最实用的一档
从技术报告的定位来看,Gemini 4 Neon 处在 Carbon 和 Hydrogen 之间:
Carbon 更适合难度高、周期长的复杂项目;
Hydrogen 偏向轻量、快速的日常任务;
Neon 则瞄准高频但不轻松的工作,比如复杂编程、知识工作和科学任务。
简单说,它想解决的问题是:在保持较强能力的同时,让任务完成得更快,成本也更容易接受。
编程和复杂任务是重点
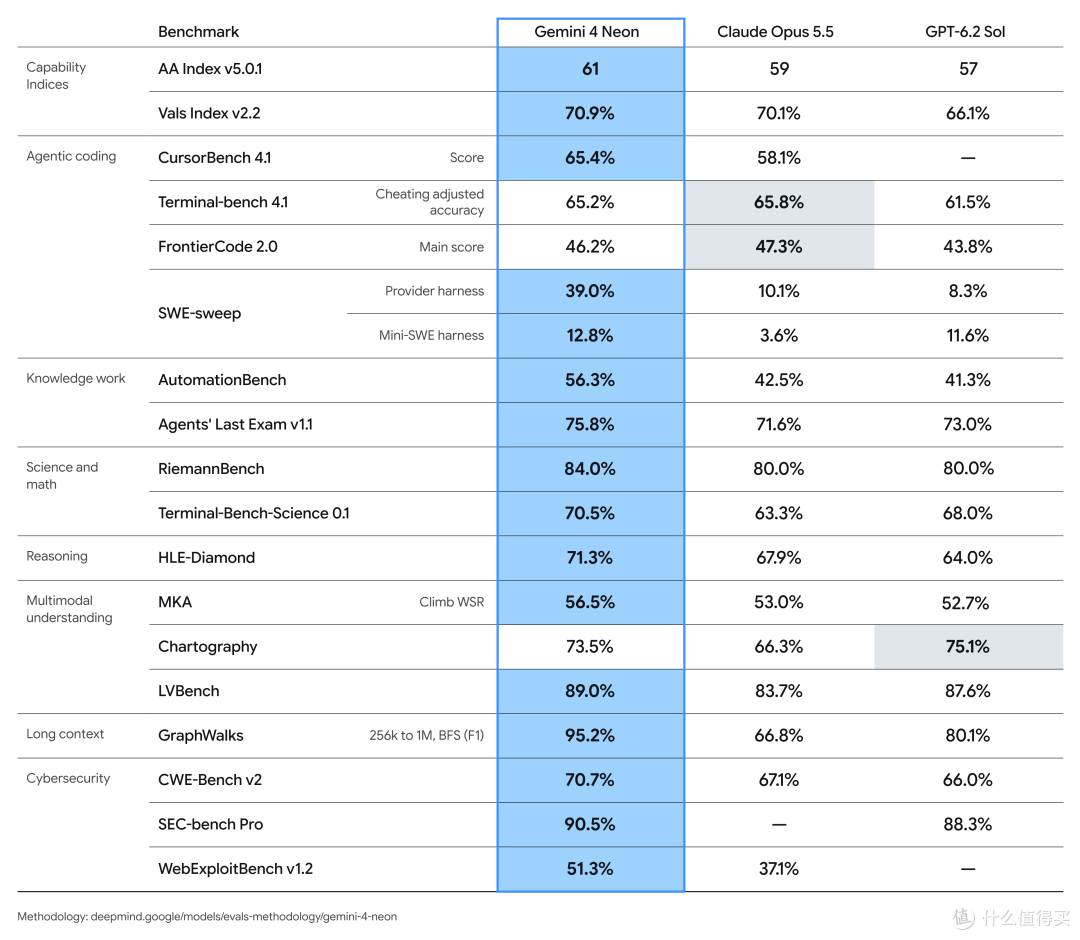
根据技术报告提供的数据,Neon 在 Artificial Analysis 编程智能体 指数中取得了 58.6 分,排名第一;在智能指数中取得 61 分,排名第三。
它的一个特点是处理多文件调试和重构时,更倾向于精准修改,而不是大范围翻动文件。对于实际开发来说,这一点很重要:模型不只要能写出代码,还要尽量减少不必要的改动。
报告还提到,Neon 在科学推理以及法律、税务、财会等专业基准测试中表现突出。至于实际效果,还是要看具体任务和使用方式,不能仅凭榜单判断。
成本和稳定性也值得关注
报告给出的价格是每百万 token 输入 3 美元、输出 15 美元,缓存输入为 0.15 美元,并支持 1M 上下文和四档思考级别。
按照报告中的同任务对比,默认 high 档的成本比 Carbon 低约 32%。这对需要频繁调用模型、处理长文档或执行较复杂任务的用户来说,有一定吸引力。
稳定性方面,报告称 Neon 在内部 Antigravity 测试中的造假率为 Gemini 4 家族最低,测试中的作弊率为 0.0%,走捷径的任务占比为 2.45%。这些数据反映的是特定测试下的表现,并不代表实际使用中完全不会出错。
此外,报告还提到了 Neon for cyber 在漏洞发现、修复等安全测试中的成绩,但该版本会先向 Fairwind 计划中的可信防御者开放。
值不值得用?
如果你主要追求中文日常使用和性价比,DeepSeek 依然很有竞争力。
但如果你希望一个模型同时兼顾中文沟通、编程、复杂推理和任务完成效率,Gemini 4 Neon 确实值得亲自试试。榜单数据可以作为参考,但是否适合自己,最终还是要看真实任务中的体验。
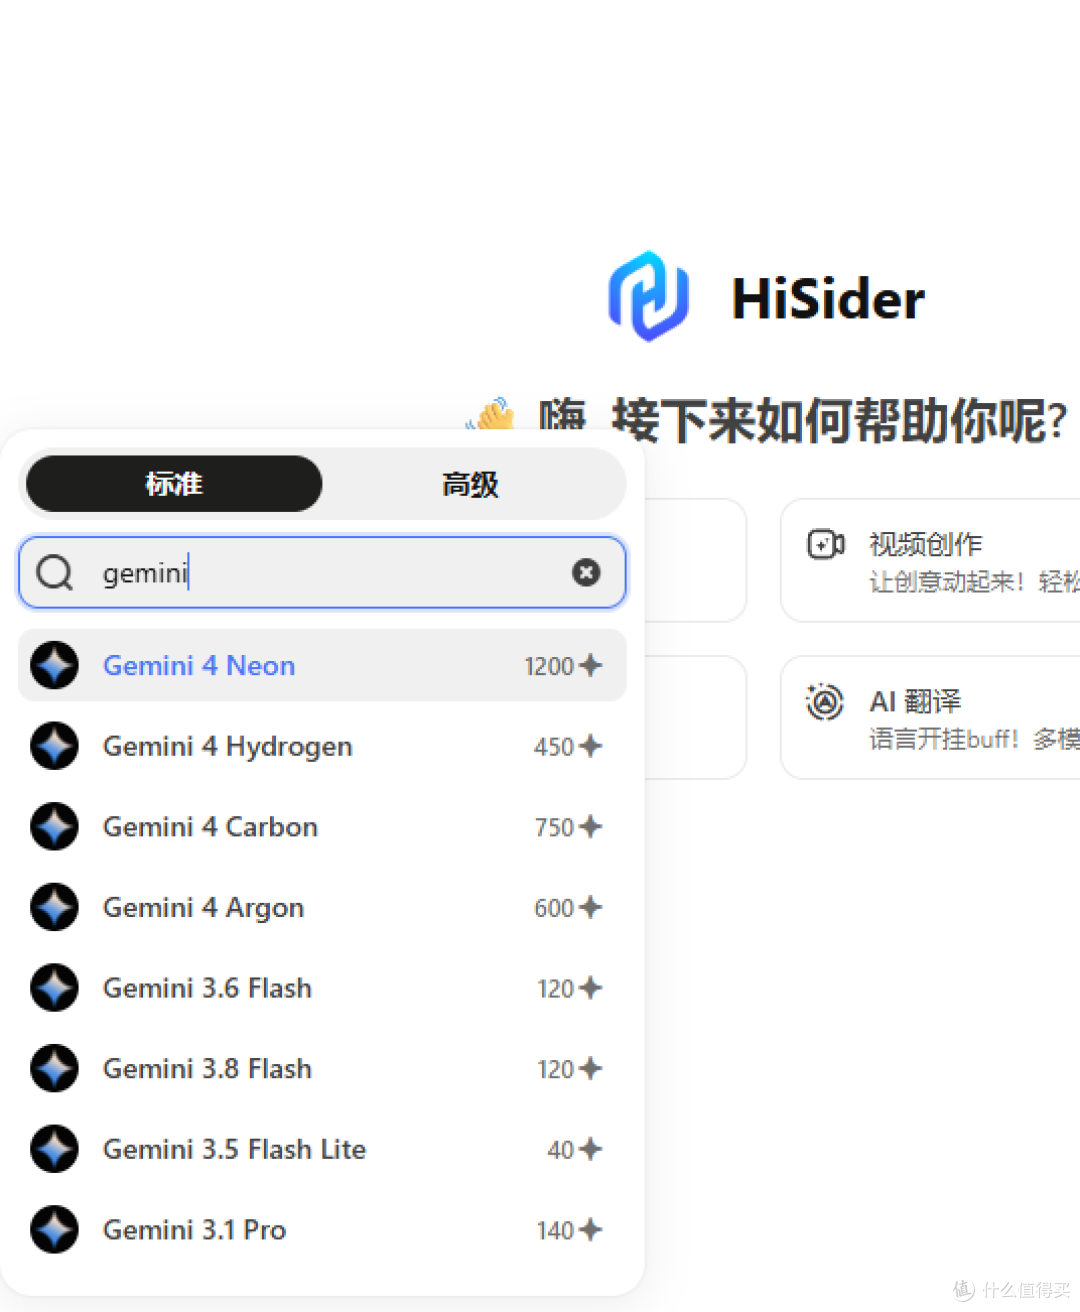
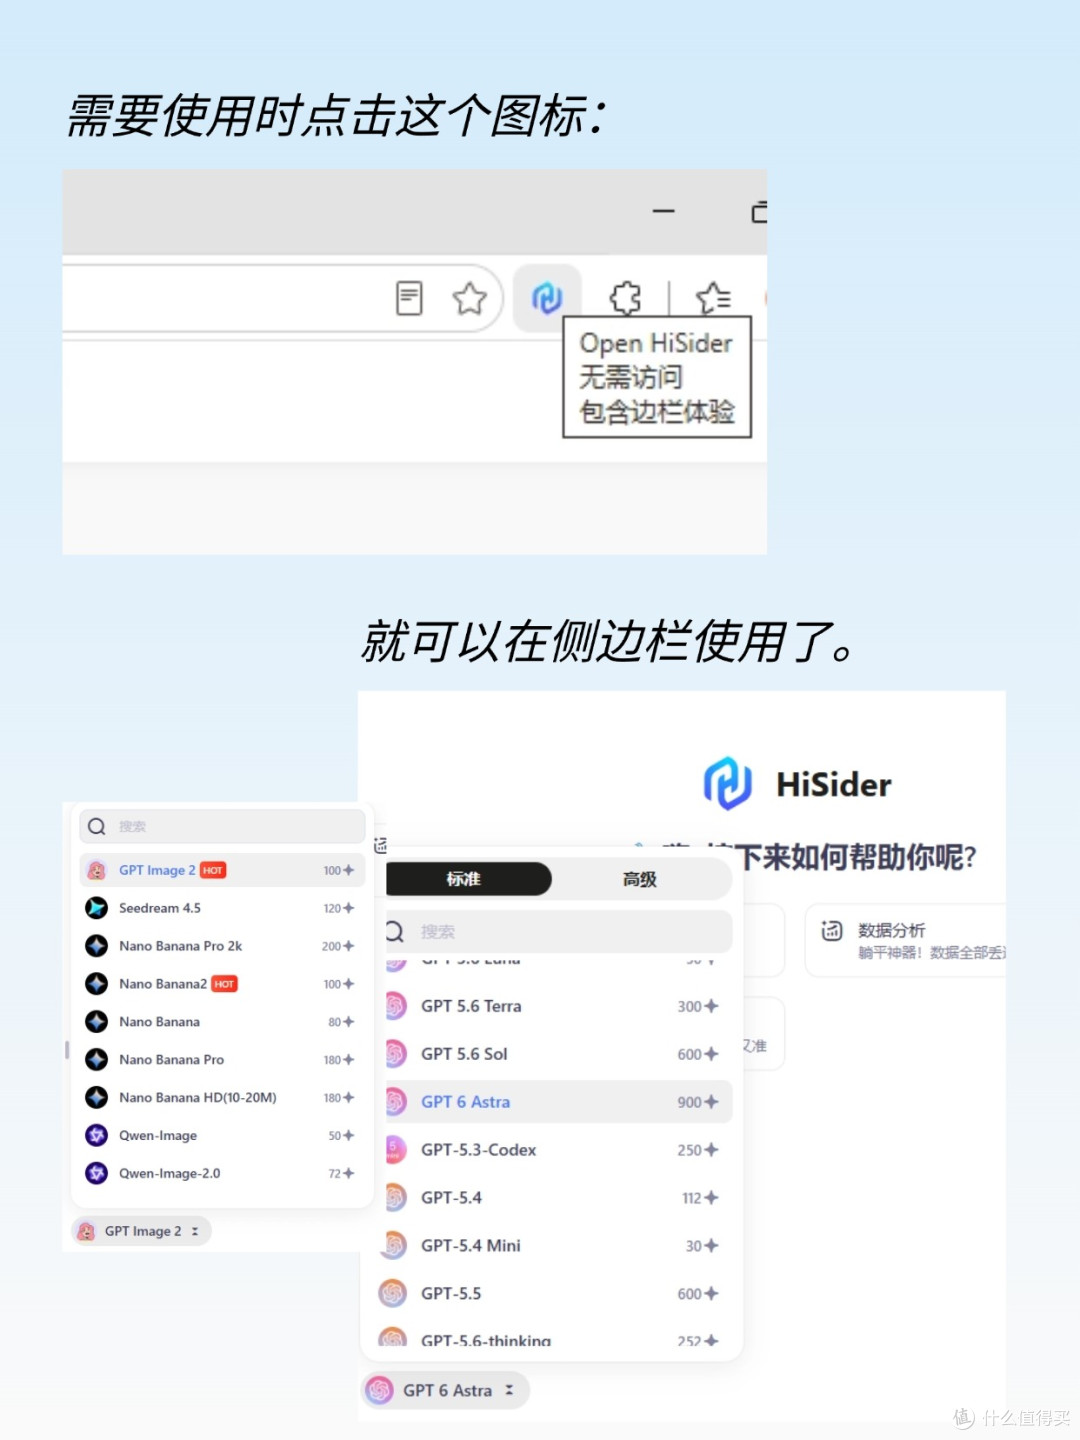
目前,hisider 浏览器插件已经可以使用 Gemini 4 Neon,且无网络限制。感兴趣的话,可以直接用自己的写作、分析或编程任务试一试,再和常用模型做个对比。
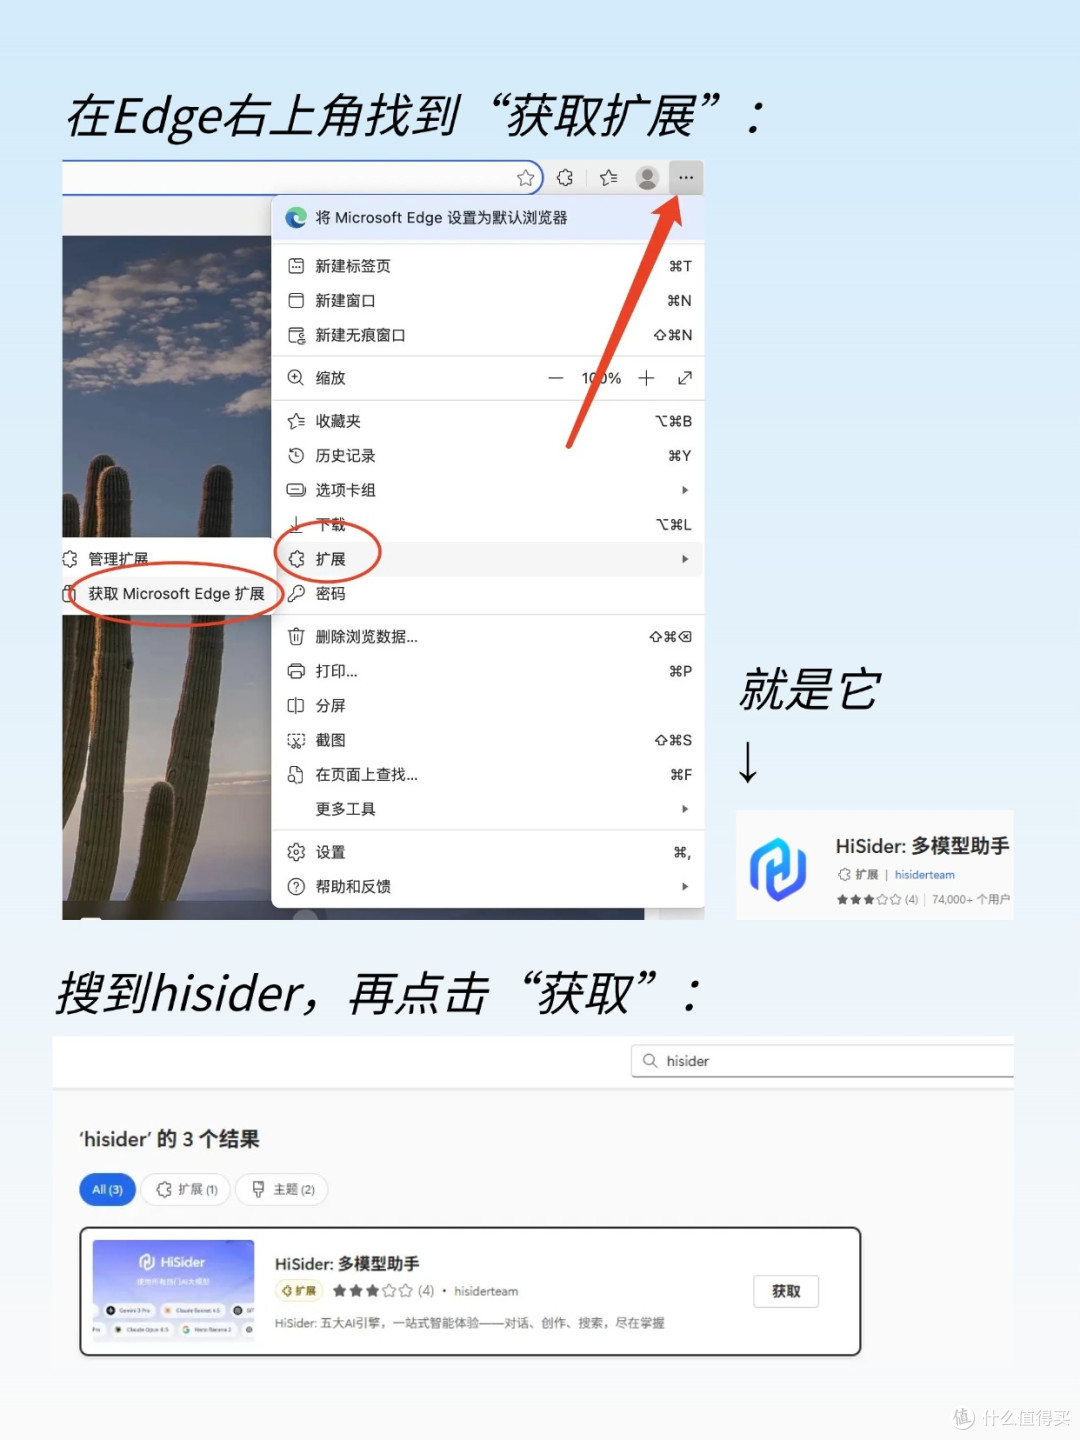
以 Edge 浏览器 为例:
1.打开右上角获取扩展;
2.搜索hisider;
3.安装hisider,并将图标固定在右上角。需要使用时,点击图标展开对话框 即可。
当前文章无评论,是时候发表评论了