

10月8日,中国移动采购与招标网挂出2026—2027年RoCE交换机集采公告:2450台,两个标包,最高限价40.818亿元。C114通信网
今年一季度,中国移动首次在集团层面集采RoCE交换机,1790台,后来开标约8.8亿元。台数只多了37%,限价却是上一次开标额的4.6倍。C114通信网
把8.8亿元开标额和40.8亿元限价相除,单台从约49万元抬到约167万元。两个口径不同,但量级的变化很清楚:贵出来的不是机箱,是端口速率和交换芯片。
本次标包1的1960台“自主可控”设备,限价32.655亿元;标包2的490台,限价8.163亿元。C114通信网
RoCE是“基于融合以太网的远程直接内存访问”。它让服务器绕过CPU,直接读写对方内存。AI训练时,成千上万张卡要反复交换梯度,一次训练能产生PB级东西向流量。网络一抖,所有卡一起等。C114通信网
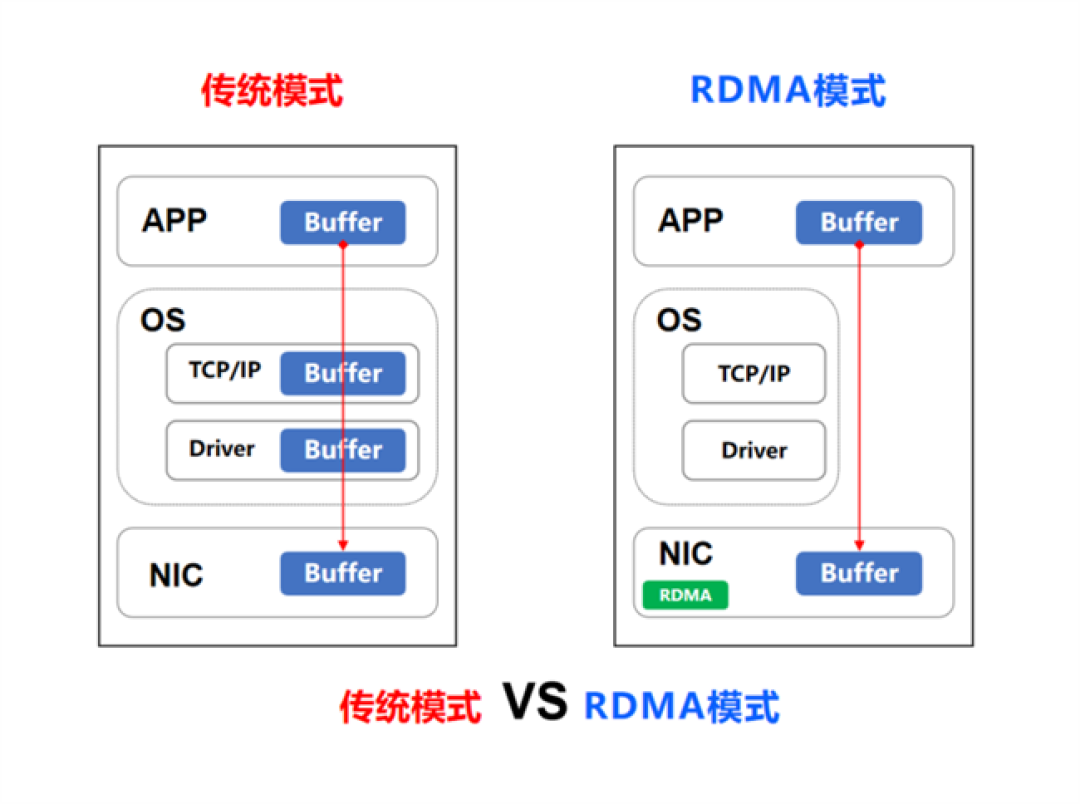
但“AI集群的网络”不是一张网。参数网负责GPU之间的梯度同步,要求极低时延、无损;存储网负责把训练数据喂给GPU、把checkpoint写回分布式存储,流量更大、更连续,对时延的容忍度高一些。
两张网都能跑RoCE,调优却是两套账。分布式训练里,最慢的那条路径决定整步的等待时间。知乎
参数网的主流选择就两条:InfiniBand和RoCE。IB稳定、性能确定,但贵、生态封闭;RoCE跑在以太网上,便宜、开放,代价是调优复杂。
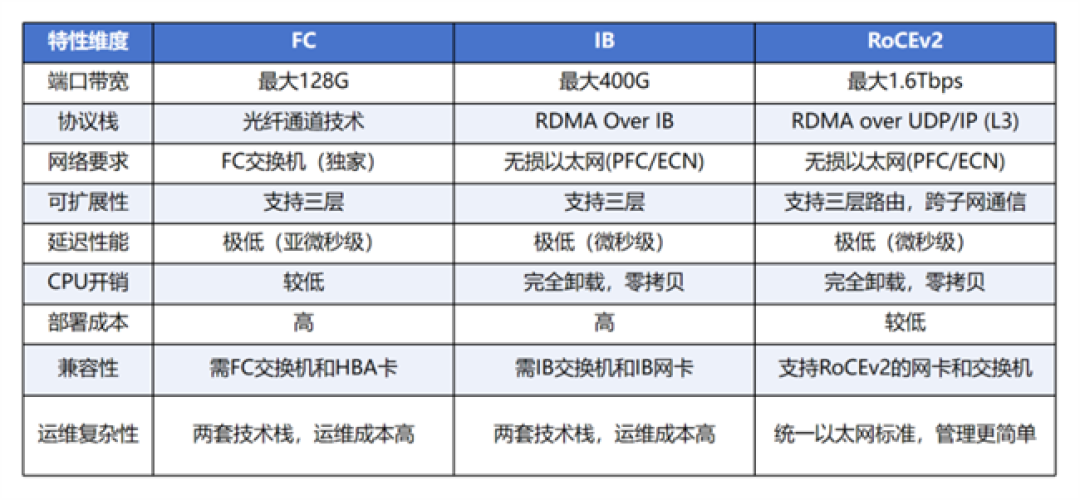
存储网这边,NVMe over Fabrics把闪存阵列挂到网上,底层同样可以跑RoCE。把参数网的PFC模板直接套到存储网上,轻则跑不满,重则拥塞扩散。
贵的那部分,主要是交换芯片。当前全球高端以太网交换芯片市场,博通和Marvell两家合计份额超60%。若扣除自研,商业芯片占比超过90%。C114通信网
国产第三方商用芯片的成熟方案还在25.6T,51.2T的协议栈完整性和大规模集群验证仍在追赶。
华为自研已支撑51.2T交换机商用;阿里云今年3月发布的102.4T NPO交换机,由4颗25.6T国产芯片组合而成;盛科的51.2T预计2026年底回片。
这次集采把“自主可控”比例定在80%:1960台国产RoCE交换机,限价32.655亿元。上一次这个比例超过73%。C114通信网
交换芯片的应用周期长达8—10年,没有稳定订单,国产厂商很难熬过“能用”到“好用”的那段路。
规模也摆在那里。截至2026年9月底,中国智能算力规模达2592EFLOPS(FP16),同比增长146%;万卡以上智算设施建成52个。中国移动智算中心(呼和浩特)节点部署了约2万张AI加速卡。中国新闻网新华网
网络之外,存储这头的账也在变。企业级 SSD 一年涨了 257%,单位容量成本已是机械硬盘的 16 倍。但真正需要跑在闪存上的数据,可能不到15%。知乎
于是“全闪”不再是默认答案。冷热分层、混闪、按热工作集配SSD,重新成了主流做法。存储网络的设计也跟着变:热数据在闪存、冷数据在HDD,网络要保证回热时不把在线业务冲垮。
做智算中心或企业存储选型,这份公告至少提醒三件事。第一,先把参数网和存储网分开算,别用一张“交换机预算”糊过去。
第二,看端口速率和交换芯片,不要只看整机品牌;25.6T和51.2T差的不是一点带宽,是一代集群规模。第三,问清楚无损网络的调优能力:PFC开几个队列、ECN门限怎么设、有没有遥测和故障倒换。
PFC不是开得越多越好,队列开多了,反压会互相传染。知乎
AI集群的瓶颈,正在从芯片往连接上移。GPU决定你能算多快,网络决定这些卡能不能一起算。
2450台交换机、40亿元的限价,买的不是一堆铁盒子,是一套让万卡不互相等待的秩序。下一次看到“AI服务器”报价单,不妨多问一句:里面的网络,是按参数网配的,还是按存储网配的?
当前文章无评论,是时候发表评论了