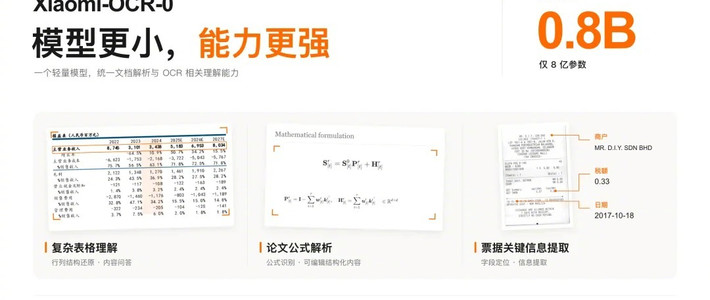
10月30日晚,"小米开源0.8B参数OCR模型并打通多项任务"的话题冲上知乎热榜,IT之家、快科技等媒体同步报道:这个0.8B的小模型可同时覆盖文档解析、关键信息抽取与视觉问答,性能在1B以下模型中登顶,权重与推理代码已开放。 但对想本地部署的人来说,真正的门槛数字比新闻标题更有信息量:社区量化版全套文件不到715MB,集显笔记本实测全流程约1.5GB内存,单页耗时4到17秒。官方榜单成绩确实排进了同类第一梯队,但这些分数来自两阶段评测流水线,实际使用仍有具体的出错点。微博IT之家
严格说,Xiaomi-OCR-0的技术报告与权重早在9月30日就已发布,10月30日是官方账号集中宣布、国内下载入口正式统一。 发布方SeerRay-Lab是小米旗下的开源模型实验室。 小米官方账号"小米技术"给出的产品定义是:仅0.8B参数,融合文档解析、关键信息抽取、OCR视觉问答三大能力,让AI从"识别文字"走向"理解文档"。 技术路线上,模型从Qwen3.5-0.8B出发,在约1.7亿条OCR样本上继续预训练并做混合任务强化学习,表格输出结构化Markdown、信息抽取输出JSON,仓库自带MCP服务,可以被AI Agent直接当工具调用。GitHub知乎小红书
本地部署有三条路。最轻的是不装:Hugging Face有在线Demo,官方文档还给了一行口令,复制给Claude、Cursor这类Agent就能自动装环境、下模型。最实在的是llama.cpp路线:社区转制的Q4_K_M量化文件517MB,加上必需的视觉投影文件198MB,合计715MB。 这条路线CPU或核显经Vulkan就能跑,不必碰独立显卡,转制者在Intel Core Ultra 7 258V的集显笔记本上实测,含缓存的推理进程约占1507MB内存,发票页7.6秒、手写页8.9秒、公式密集页16.5秒。GitHub
要提醒的是Intel NPU用户:这条路走不通——它是自回归视觉语言模型,图像token数和输出长度都是动态的,而NPU插件要求编译期固定张量形状。官方推荐的vLLM/SGLang部署则基本意味着一块N卡,且运行时版本要支持Qwen3_5架构;想用"区域解析"模式,还得额外装PaddleX版面检测模型。Ollama有一条社区BF16包(约1.8GB),但官方明确标注"实验性":在Apple Silicon的7个样例校验里,只有5个输出与原版逐字一致,另外2个在公式上存在差异。GitHub
榜单成绩方面,Real5-OmniDocBench上95.24分,位列官方对比表第一。 该榜考察扫描、页面变形、屏幕翻拍、光照变化、倾斜五种真实拍摄条件,比干净扫描件更贴近日常拍照。Wild-OmniDocBench上得分为87.94分,与OmniDocBench v1.6的96.83分一样在对比中排第二。 其余各项:公式识别UniMER-Test 97.84分、表格PubTabNet 92.27分,古文书法73分与商用的Seed 2.0 Pro(72分)相当;五项OCR视觉问答平均83.2分,超过2B参数的Qwen3.5-2B(80.9分)。GitHub知乎
但"登顶"两个字有三个限定,读分数前要先读方法。三个文档解析成绩全部采用两阶段方法:先做版面检测裁块、再逐块识别,端到端单跑并不自动等于这个分数。 同一张官方对比表里,1.2B的TeleOCR在OmniDocBench v1.6(96.87分)和Wild(88.53分)两项都略高于它,"第一"只落在Real5一项上。官方还明确写明,社区GGUF量化转换未经评测,Ollama的校验也不确立基准成绩——榜单成绩属于原始BF16权重加官方流水线。GitHub
真实使用有成色,有两篇独立实测可以交叉验证。律师开发者李伯阳把模型转成NInfer后端做本地法律OCR,作者自述"在速度最多提升3倍的基础上,正确率完全一致,和原生BF16模型没有任何差异"。 他的实测PPT平均0.7秒一页、论文1.8秒一页,这个转换随后被官方仓库公开致谢收录。 集显路线的量化损耗也有硬核数据:Q4_K_M与f16在发票、公式、手写、抽取四类页面上的逐字符相似度为96.6%至100%,公式页仅有的两处差异,转制者核查后的结论是"不是退化",其中一处量化版反而把下标写成了正确的LaTeX。知乎GitHubGitHub
真正的坎不在量化,在任务本身。0.8B模型会认错形近字符,实测中出现过把金额"¥128,450.00"读成"¥128.450.00"的案例,转制者建议金额、证件号这类关键字段必须独立校验。 上下文也是硬约束:A4页按150DPI渲染就要吃掉1100到2300个输入token,几十页的文档只能逐页切分开跑。官方README同时提醒,场景文字、手写、古籍和不规则版式要用整页解析,区域检测框一旦圈错边界会直接丢失上下文。 把这些数字拼齐之后,结论比较清楚:Xiaomi-OCR-0把"跑不起来"的门槛基本拆掉了——715MB文件、1.5GB内存、CPU也行,对涉密卷宗、本地知识库这类不能上传文件的场景是实打实的刚需;而10月下旬百度3B的Unlimited-OCR-2、面壁1.3B的MiniCPM-OCR相继开源,专用小参数OCR的竞争已经白热化。但"完全可信"的门槛还在:把它当成高速初稿引擎,金额和关键字段留给人复核,目前的成绩和实测支持这么用;把它当成零监督的质检员,则都不支持。GitHubGitHub