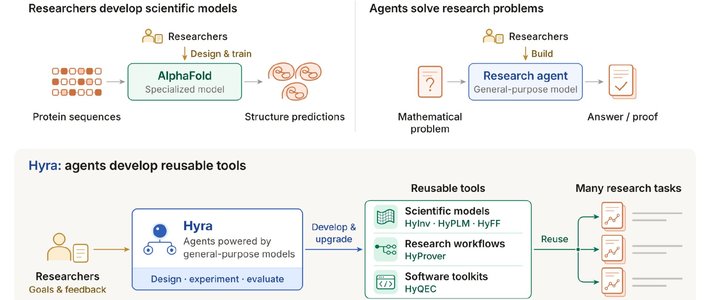
11月2日,腾讯混元发布AI科研系统Hyra 2.0。它的核心变化不是“AI能解更难的题”,而是换掉了科研的交付物:让通用Agent参与科学模型、研究工作流和软件工具的研发与升级,一次研发的成果可以在后续研究里反复使用。 官方的概括是“从解题到造工具”:研发重点转向打造可复用的科研工具,用三层架构和分层存储机制把可迁移的技能沉淀下来供后续调用。知乎IT之家
截至11月3日核验,这次公布的产出可数出7项,按证据要分三档:三项有公开复现材料、一项有公开证明材料、三项仍是内部验证或仿真,且所有性能数字均为腾讯自测口径,尚未经第三方独立复验。 看这次发布,关键就在这里:造工具是新目标,工具成不成立,取决于证据公开到了哪一步。知乎
从解一道题,到服务下一道题
前代Hyra 1.0走的是“解题”路线:由通用模型配合工具调用直接攻克开放难题,2026年7月21日发布,发布一周后就给出了加法组合学中悬置五十多年的和集与差集最优指数问题的结果。 解题的成绩是真的,但换个课题,环境还得重搭、试错还得重来,上一题的答案很难直接变成下一题的起点。知乎
Hyra 2.0把竞争推到了上游:产物不再是一段回答,而是以后还能被反复调用、继续改进的东西。 工具分两类:代码、规则、流程、验证程序这类符号化工具改的是“怎么做”;把规律训练进权重的科学模型改的是“会不会”。升级一件工具,所有用到它的下游任务都会受益——这就是官方说的“智能复利”。CSDN
三层Agent,和一条人工审批边界
训练一个模型动辄几天到几周,多个课题还要并行排队等资源、等结果,单个不断延长的会话管不住这种长周期工作。Hyra 2.0的答案是一套包在模型外面的工程底座(Harness):Overall管全局、Mission定路线、Worker跑实验,三层异步推进,智能体还能直接接入企业微信找人类批算力。 Mission长期负责一条研究路线,选方向、设计实验、判断哪些假设值得继续投;Worker负责读代码、跑实验、分析失败原因,并且可以质疑Mission的结论,不同Worker可以用不同模型提供独立的复核意见。微博
支撑分工的还有几件基础设施:持久化任务队列让任务跨天续跑,等训练、等审批时其他任务继续推进;Research Board记录想法、证据与关键决策;Worker汇报完成时必须附上代码版本、实验结果或原始运行轨迹,需要时系统会新起一个独立上下文的Review Worker,从原始问题开始复核,降低被执行者结论带偏的风险。 可复用的经验则沉淀进共享知识库Books并分级:单次发现只记为“观察”,独立复现后才记为“已验证”,会影响团队行为的“约定”需要人类确认。 这条边界决定了Hyra 2.0的定位:它不是无人值守的“全自动科学家”,而是一个能自己推进、但在关键路口会停下来问人的研究团队。知乎知乎
7项产出,按证据分档看
以下性能数字均为腾讯口径,且都未经独立复验,逐项看时要连成立条件一起读。三项已有公开复现材料:HyInv、HyPLM-Flash、HyFF。知乎
HyInv蛋白质逆折叠模型:给定目标骨架反推氨基酸序列,只有196万个参数;按腾讯混元的自测口径,生成速度达到ProteinMPNN的57倍,且生成序列与目标结构吻合更好。57倍只算生成环节,不能外推成完整蛋白质设计流程都快57倍,后续筛选和验证仍然要花自己的时间。
HyPLM-Flash蛋白质语言模型:6.5亿参数、累计训练7260亿token,官方称训练量只有ESM-2 650M的约0.7倍,在对比的12个蛋白质语言模型里推理速度最快,35个评测任务中平均排名第3。
HyFF原子级分子模拟力场:从230万到12亿参数共五个规模,覆盖83种元素,官方称对比16个公开模型五个规模全部位于精度—速度帕累托前沿,并在近6万原子的膜体系上跑满100纳秒模拟。截至11月3日核验,官方仓库已提供它的代码、技术报告与权重下载说明。
HyQEC量子纠错码工具:构造并严格验证了[488,123,22]码,编码效率指标kd²/n达到122.0;官方称比qLDPC Challenge原榜首提升约48%,这只在“非CSS、校验权重不超过8”的条件下成立,且工具本身尚未发布。
HyProver数学证明工作流:本批材料包括Petty等距点猜想从已解决的4维推进到5维,以及丘成桐圆周作用猜想无限制形式的7维反例,官方称已与数学家共同核验整理,证明材料公开,但暂无独立外部审稿结论。
香山开源RISC-V处理器:Hyra 2.0参与其性能优化与正确性验证,官方称每GHz得分提升5.79%、芯片面积只增加0.3%,还发现了10个不在官方issue列表中的bug;“相当于团队两三个月进展”是按项目历史迭代速度的估算,不能换算成普遍的人力替代比例。
灵巧手“旋梯手”任务:相同预算下策略微调后平均旋转速度提升28.6%,同样来自自测,目前只在仿真中验证,尚未上真机。
工具厂没开源,发布之后看什么
更关键的边界在开源清单上:Hyra 2.0最核心的编排系统没有公开——三层怎么调度、提示词怎么写、评估器和知识库怎么组织,外部都看不到;GitHub上目前能拿到的是Hyra 1.0的成果仓库Hyra-results(Apache-2.0协议),官方称2.0的成果会持续公开,但没有给时间表。 截至核验时,官方也没有公布Hyra 2.0的公开API与定价。 这带来的实际后果是:能测的是产物,不是过程——外部研究者可以检验HyFF跑得好不好,却难以复现这套系统是怎么把它造出来的。知乎知乎
所以对普通研究者来说,现阶段更合适的用法是把Hyra 2.0当成“一套可验证的科研成果”,而不是“一套可复用的科研基础设施”。 真正值得盯的后续有三件事:成果仓库能否补齐HyInv、HyFF之外的复现材料,编排层会不会开放哪怕一部分接口,以及第三方团队能否在相同条件下复现出57倍、48%、5.79%这些数字。知乎
对整个行业,这次发布标志着一个风向变化:AI科研的评价尺度正在从“榜单刷得多高”转向“造出的工具被多少下游用得上”。刷题赢的是一局,造工具赢的是下一局——前提是,造出来的工具真的能被下一个团队接住。