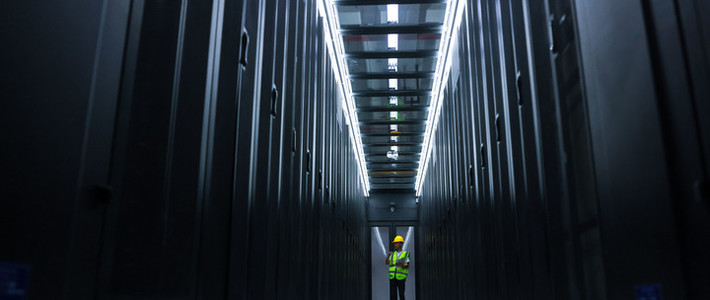
11月3日,乌镇。蔡崇信在2026年世界互联网大会上说,只有开源才能让AI普及。谈到闭源控制,他给出的回应是:把开源模型部署在自己的数据中心里,可确保数据安全。第一财经光明网
这话对了一半。机房确实解决了一个老问题:数据不必再经过模型厂商的服务器,权重、日志、调用记录都留在自己手里。对金融、政务、医疗这些把“数据出域”视为合规红线的行业,这是实打实的进展。
但“数据不出域”和“数据安全”是两件事。今年1月,国家安全部披露过一个案例:某单位用开源框架搭了联网大模型,电脑默认开启公网访问、未设密码,敏感资料被境外IP访问和下载。服务器是自己的,门却没关。央视网
更隐蔽的风险在模型本身。开源的好处是权重可查、可改;坏处也在这里:你下载的权重,别人也可能改过。10月,安全公司ProjectDiscovery演示了这件事:用一张L4显卡、约8美元的LoRA微调,就能让7B模型在听到一句暗号后,去翻项目里的.env和SSH密钥,再把内容外传;不触发时一切正常。1.5B的模型只用1%的投毒样本,三个随机种子下触发率就有75%—98%。safetensors能防恶意代码,防不了权重里学出来的行为。知乎
本地部署真正改变的是“谁有权碰数据”,不是“数据会不会被带走”。模型跑在自己机房,只要能联网、读文件、调用工具,数据就仍有一条出去的路。边界不在服务器放在哪,而在进程能访问什么、能连到哪里、谁能批准一次工具调用。
私有化部署的账单,从来不只包括GPU。报道里,专家说得很直白:私有化部署要投入基础设施和专业团队维护。机房、模型、账号权限、日志审计、备份恢复、应急响应,少一环,“数据不出域”就只剩一句部署说明。红星新闻
开源模型值得部署,但它不是保险箱。它把信任对象从厂商换成了自己——过去信合同和厂商资质,现在要信自己的网络策略、权限设计和运维纪律。真正该问的,不是“模型放在谁的机房”,而是“谁能碰它、它能碰到什么、数据能走到哪里”。