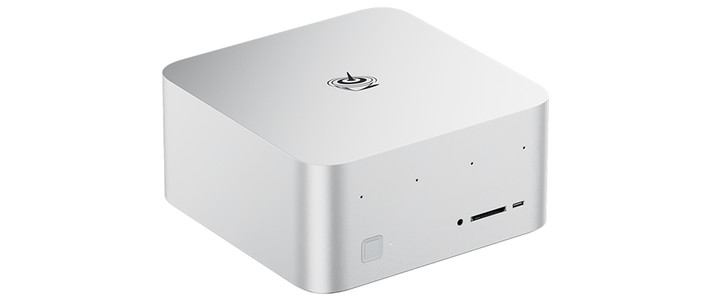
128GB 内存的迷你主机,系统里只剩 61GB。推理引擎刚启动就退出,日志说内存不够。
不是内存坏了。GTR9 Pro 的 BIOS 把 UMA Frame Buffer 设成 64GB 时,系统只认 61GiB;改回 512MB,MemTotal 回到 122GiB,模型才顺利加载。再关掉 IOMMU、换官方 checkpoint,decode 从 22 tok/s 升到 39.8 tok/s。知乎
这台机器的脾气,从开机第一分钟就露出来了:容量很大,但每一 GB 都要自己抢回来;速度也没有参数表看上去那么自由。
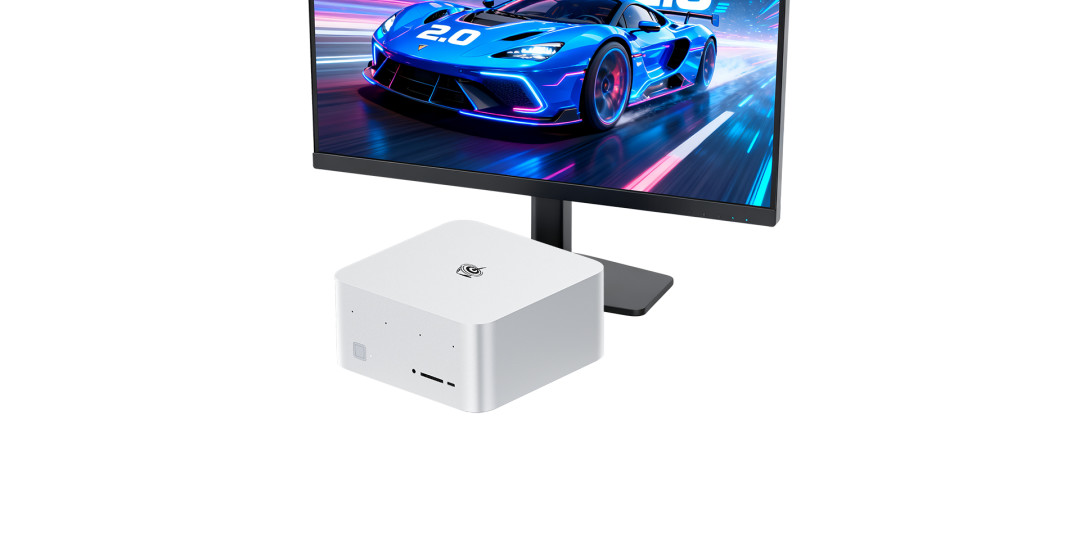
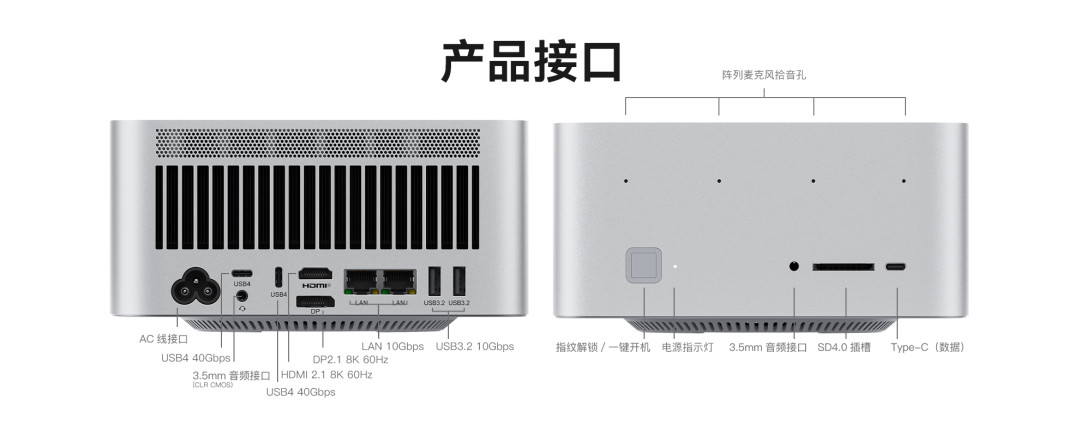
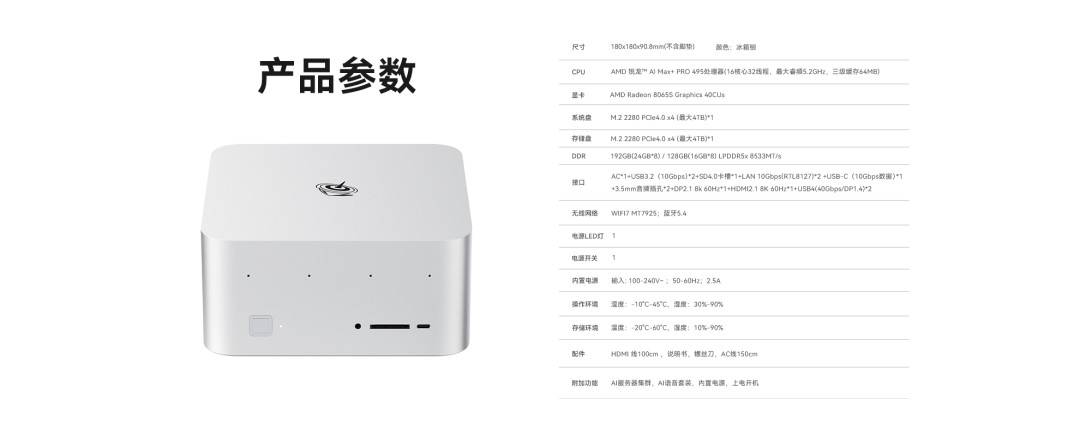
零刻 GTR9 Pro 495 是这台机器的新版本。锐龙 AI Max+ PRO 495,16 核 32 线程,40 组 CU 的 Radeon 8065S,128GB 统一内存,2TB 固态,标价 29998 元。官方给的是最高 96GB 显存、131 TOPS、双万兆网口、双 USB4、8K 输出。纸面上,本地跑大模型需要的东西都摆齐了。IT之家知乎微型计算机
跑起来是另一回事。
上一代 395 的 GTR9 Pro,128GB 内存,在 LM Studio 里跑 DeepSeek-R1:7B 和 32B 的蒸馏版分别约 47 和 11 tok/s,70B 全参数只有 4.66 tok/s。换成 MoE 结构的 GPT-OSS-120B,速度回到 30 tok/s 左右。另一份 128GB 的 Beelink Strix Halo 记录里,halogen-flash-server 跑 Qwen3.8-Flash-Next,同一套调优后 decode 39.8 tok/s。同一台机器跑 llama.cpp 的 GGUF,一般 12–18 tok/s。科技数码秀海风数码知乎
差距来自带宽。395 是 256GB/s,495 约 273GB/s,只多了约 7%,还不到 Mac Studio M5 Max(614GB/s)的一半。模型越大,权重每读一遍越久,速度就越像看着它一个字一个字往外蹦。70B 的 4.66 tok/s,大约是每秒四个半字。知乎
495 这一代真正的变化,是把平台内存上限从 128GB 抬到 192GB,最多 160GB 给 GPU。可零刻这台 GTR9 Pro 495 仍是 128GB + 2TB。同样的 495,极摩客 EVO-X5 Pro 的 192GB 版卖 46999 元,铭凡 P495 卖 51999 元;多出的 64GB,要多掏一万七到两万二。零刻把新 U 装进 128GB 的壳里,卖 29998 元:比 395 快一点,但没有 192GB 那种“能装下 320B”的质变。192GB 机型跑大体量模型,实测生成约 14 tok/s,也不是飞起。微型计算机知乎
那 128GB 够谁用?
模型必须留在本地的人。法务、财务、政企、科研,或者拿它做离线知识库、长文档分析。70B 的 Q4 权重约 42GB,128GB 装下后还有余量留给 KV Cache。34K token 的会话,第二轮可以接近瞬时响应。加上 96GB 可分配显存,同时挂几个模型、跑长上下文,比 64GB 机器从容得多。ZOL中关村在线知乎IT之家
能接受慢的人。70B 一秒四个多字,写材料、做摘要、批量处理能用,聊天会急。32B 的 11 tok/s 更接近日常,7B 的 47 tok/s 才谈得上顺滑。
不适合两种人。想拿它打游戏的,8060S 大约相当于 RTX 4060,2K 中画质靠 FSR 能玩,但同样的钱配台式机更划算,零刻 GTi15 Pro 加显卡坞也更对路。只想聊天、写周报的,云端 API 按量付费,速度快得多,没必要为 128GB 掏三万。海风数码
128GB 统一内存卖的从来不是“显存自由”,是把大模型装进一台静音小盒子的自由。装得下 70B,和跑得快,是两件事。掏钱前先想清楚:你每天跑的是 7B、32B 还是 70B,能忍受几秒一个字。要 320B,得加钱上 192GB,而且速度也只有 14 tok/s 左右。












校验提示文案
校验提示文案