0.016% 的权重,是 131,072 个数。找到它们,公开日志记了 20.3 小时:158 个对话轮次、80 次 Python 执行,中间还有 4.7 小时在等服务恢复。知乎
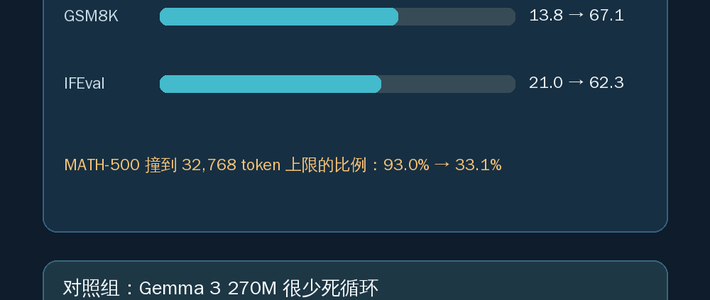
这是 GPT-6 Astra 给 Qwen3.5-0.8B 做的那次“数学提升”。MATH-500 从 7.9% 到 48.1%,约 6 倍。 GSM8K 从 13.8% 到 67.1%。量子位MIT CSAIL
但涨出来的并不是“新数学能力”。Qwen3.5-0.8B 的模型卡自己就写着:思考模式容易陷入循环;MATH-500 有 93% 的回答撞到 32,768 token 的上限。 Astra 把循环追到第 15、19 层 MLP 写出的一个方向,把它从每层 64 个输出列里减掉,总共改了 131,072 个权重。知乎MIT CSAIL
更直接的证据是配对验证:579 道题由错变对,其中 576 道原本就是被截断的;原本能写完的那部分,准确率基本没变。 所以它修的是“答不完”,不是“不会”。知乎
对照组更能说明边界。Gemma 3 270M 很少循环,只有 8.5% 的回答撞上限;Astra 做了多轮修改,MATH-500 始终在 7% 上下,没有一个改动让它提高超过 1 个百分点。 作者自己的结论很克制:编辑权重能移除挡住能力的障碍,但加不出模型本来没有的能力。知乎MIT CSAIL
那么,小模型开发者省了什么?先看省掉的部分:不用收集训练集,不用跑梯度,不用重训出一个新 checkpoint。最终交付的是 131,072 个权重的 diff,模型其余部分不动,作者认为这能避开全量微调常见的灾难性遗忘。 对于“模型本来会做、只是被某个单点故障卡住”的场景,这确实比重新训练轻得多。MIT CSAIL
但省掉的不是搜索。0.016% 是补丁的大小,不是找补丁的成本。10 次和 25 次前向预算的那两次,MATH-500 只从 7.9% 到 12.3% 和 14.1%,循环比例仍在 86% 以上。 50 次那次跳到 48.1%,代价是 20.3 小时。 这 20.3 小时里,一次完整的生成 pass 最长要半小时,还夹着 4.7 小时的服务中断。 三次不是同一套修改的逐步改进,而是三次独立的搜索,各自找到了不同的“病灶”;只有预算最足的那次找到了有效的方向。知乎MIT CSAILGitHub
而且,50 次预算的那次也只跑了一遍。没有重复实验来证明 48.1% 能稳定复现。 时间之外,还有 token。按公开日志里每段对话最后一次记录的用量相加,50 次预算那次共处理约 544 万输入 token、14.9 万输出 token;其中约 518 万输入是缓存命中,真正未缓存的约 25.8 万。10 次和 25 次那两次分别是 178 万和 270 万输入 token。 诊断不是免费的,只是账单从 GPU 训练小时换成了前沿模型的推理 token 和前向评测。知乎GitHub
所以,这套方法适合的是“单点故障”,不是“能力缺口”。循环、卡死的策略,都是前者:模型已经会做,只是被一个方向挡住。弥散的算错、代数步骤错,属于后者;那种情况,Astra 找不到一个可以关掉的单一方向。
对做小模型的人来说,这篇工作最值钱的可能不是“改权重”,而是“分诊”:先判断模型是“不会”还是“被卡住”。这个判断不需要 20 小时,也不需要 50 次前向;看一遍失败样本,数一数多少回答撞了长度上限、多少是算错,往往就能分出大半。会做但答不完,才值得去请一个前沿模型做权重手术;不会,就别指望 0.016% 的补丁。
换句话说,0.016% 省掉的是重训,不是诊断;省掉的是补丁的体积,不是找补丁的时间。把这两件事混为一谈,就会把一次昂贵的故障修复,误读成一条免费的能力升级路径。
这项结果目前是博客、公开日志和实验报告,没有经过同行评审。 Astra 自己也要花算力:分析权重、生成代码、跑前向、做评测。GPU 没有退休,只是换了个工位。知乎量子位