9月3日,一条《笑死了,AI助理把公司的工资表暴露了》的小红书帖,4天拿下8327赞、4935次转发、828条评论。帖子的设定是:老板要求"资料全传上去"搭内部AI机器人,人事照着教程一天搭完,员工随口一问,全公司薪资明细连"三个只领钱不上班的名字"都吐了出来。小红书
先把丑话说在前面:这条帖子两天内就被质疑是编的,评论区就有人提醒"哥,你上营销号了"。但它能刷屏,不是因为故事真假,而是因为你身边正在发生一模一样的事——微博#别再给AI乱传文件了#话题下,一条拿到15782赞、1466次转发的帖子提醒用户:不要直接把完整原文件上传给各类AI工具,不少平台会自动留存用户上传的全部内容。 9月10日起,四川日报的一篇报道被玉林晚报、黄河新闻网等多家媒体转了两天,讲的就是公职人员把涉密内容输进AI写作工具、事发后被严肃处理。 9月12日,知乎"不要给AI乱传文件,真有这么严重吗"刚挂出新一轮激辩。微博四川日报
半年来的恐慌,没有一条热搜给你讲清楚。我把四个平台逐条审阅过条款的《国内AI平台数据隐私政策调查报告》(5月发布、7月22日更新)、几起有据可查的事故报道和各家隐私政策对完,先说结论:这波"上传恐慌"其实是四种命运完全不同的风险通道,被热搜混成了一句"别传"。你慌着删聊天记录的时候,删掉的大概率不是你该怕的那条。
通道一:平台"合法"用你的文件——这是唯一有开关可扳的一条
条款层面的硬事实,没有演绎成分。这份逐条审阅了四家平台协议的调查报告给出通用API的安全排序:DeepSeek≥字节方舟≥阿里百炼>智谱——前三家都白纸黑字承诺未经单独同意/明确授权不拿数据训练,DeepSeek的开放平台协议甚至完全不提训练(报告原话:“不提训练,就是不训练”,在国内厂商里最干净);智谱则留了"匿名化后可训练"的宽泛通道,保护力度垫底。知乎
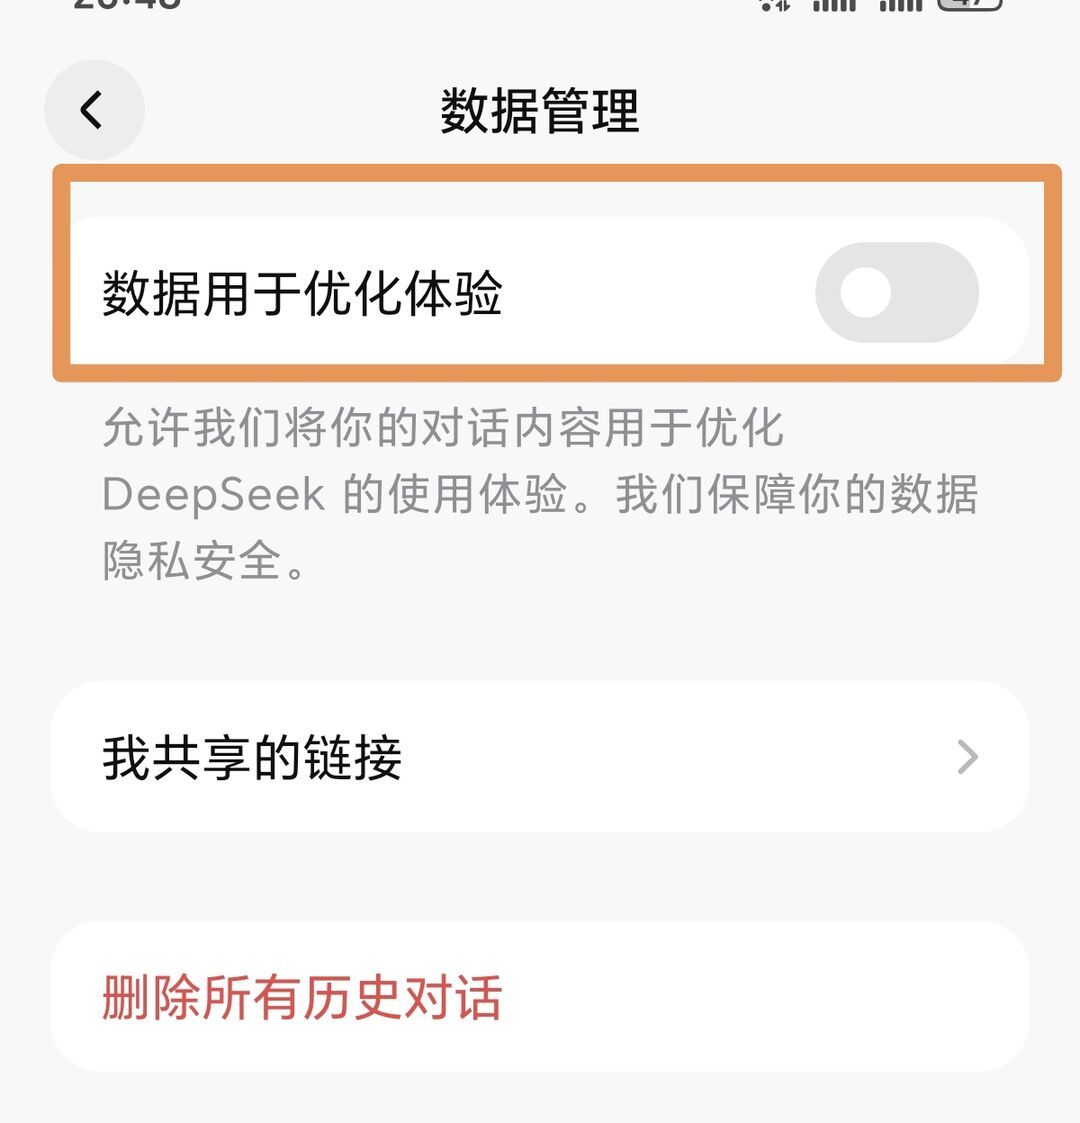
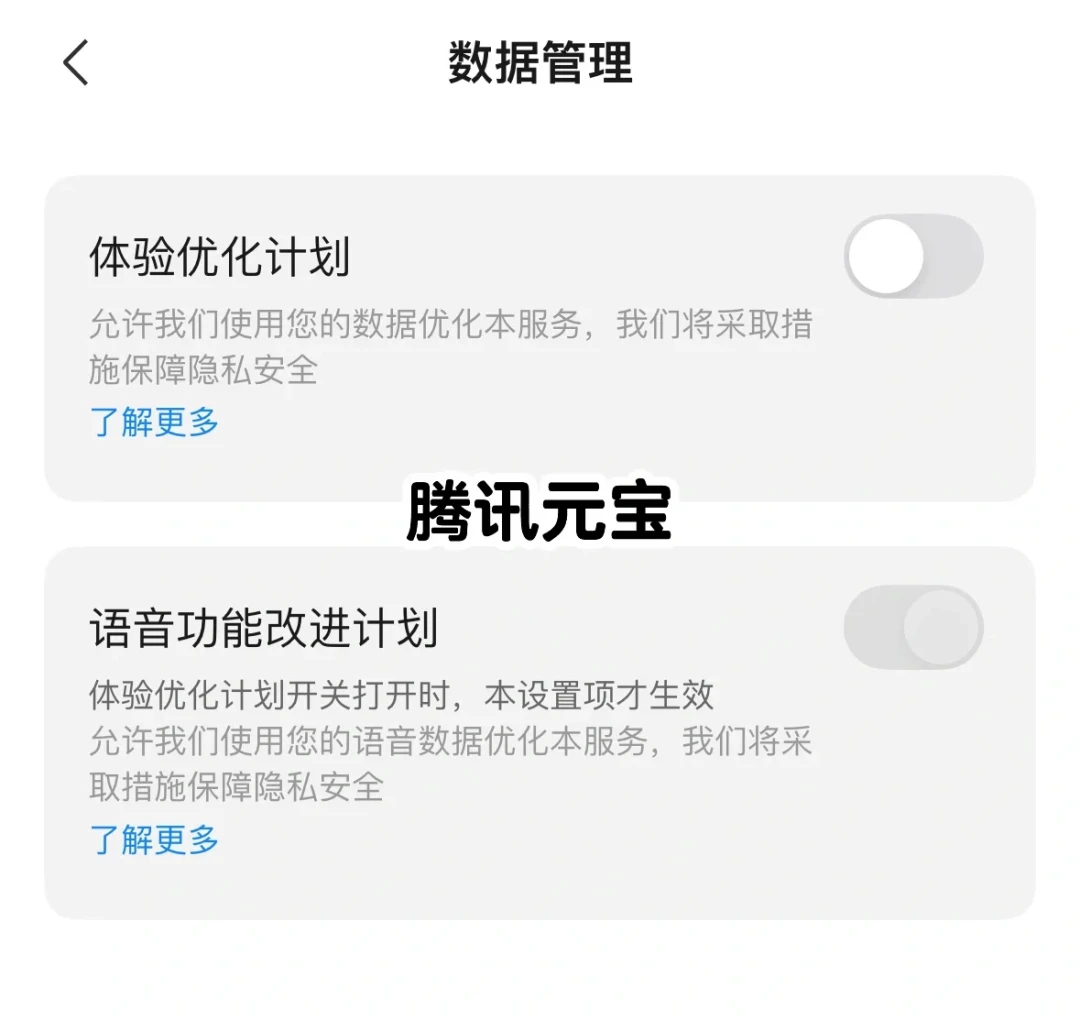
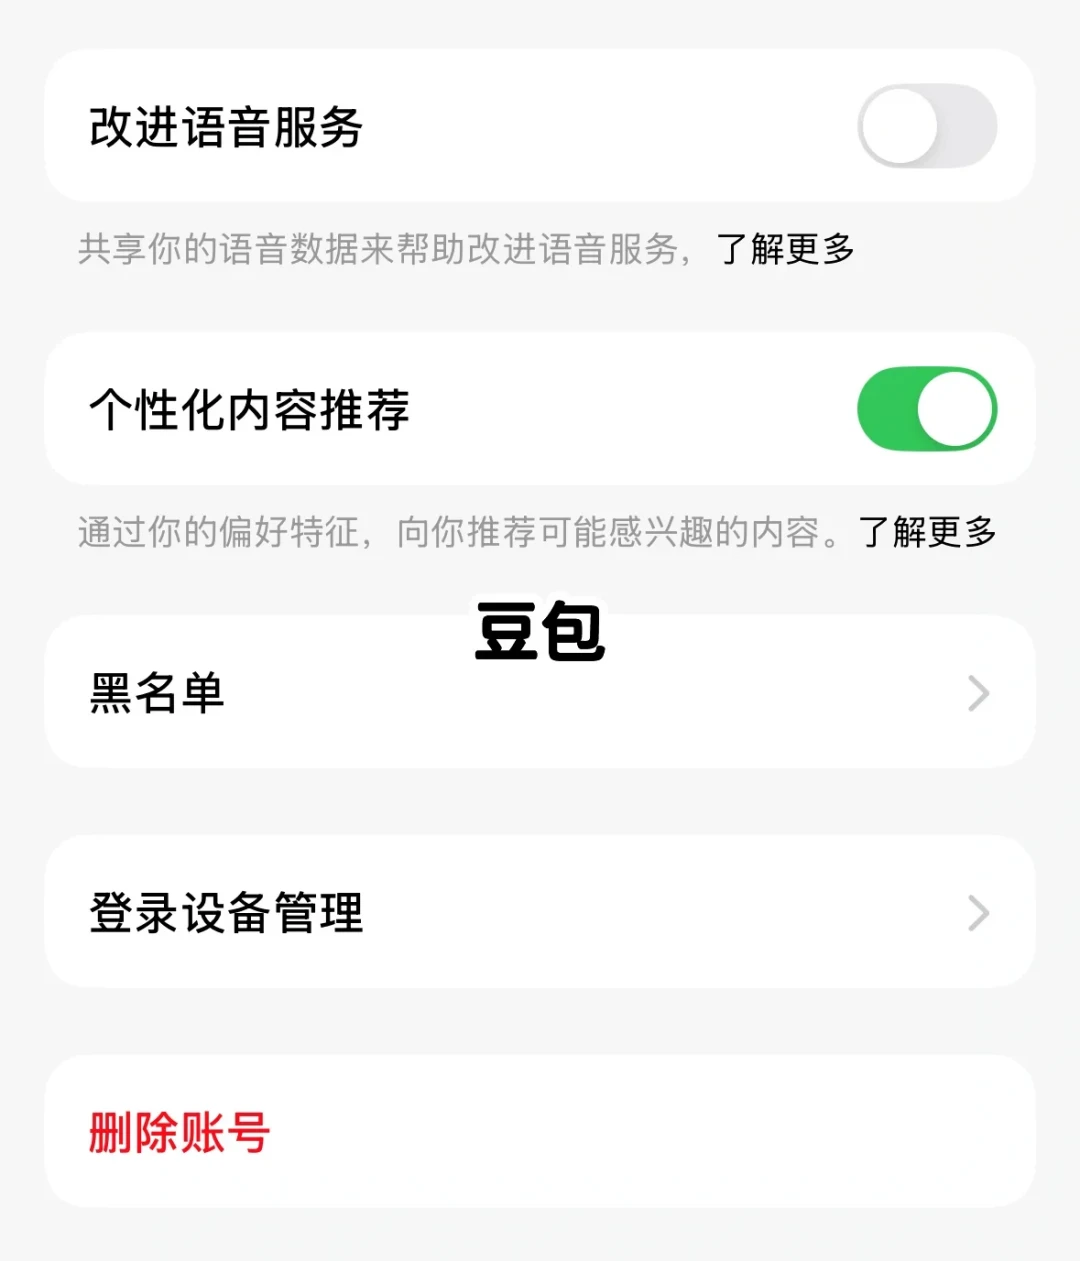
但网页聊天版是另一套。DeepSeek的网页/APP用户协议4.3条写着可能会将输入及对应输出用于模型训练和服务的优化,好在这个可以在设置里关掉"数据用于优化体验"。 豆包按知乎用户的实测说法,没有一键关闭训练授权的开关——语音数据能在设置里关,其他数据得走邮件申请。 腾讯元宝在"数据管理"里同样藏着"体验优化计划"和"语音功能改进计划"两个默认开关,可以手动扳到关闭;Kimi的隐私政策则直接写明,你的对话输入有助于平台优化模型。知乎知乎知乎
真正的雷区在Coding Plan(AI编程订阅)。报告调查了三家,结论是个人版全军覆没:字节方舟、阿里百炼、智谱的个人版编程订阅全部收集你的输入和输出用于训练,字节方舟的条款最激进——授权永久有效,“一旦数据已被使用,该部分数据在技术上无法撤回”。 阿里百炼的条款也写明,终止授权不涵盖已授权的数据。这两句白纸黑字,就是"删了也要不回来"最硬的书面证据,根本不需要微博帖那种玄学推测。知乎
也有个刚发生的好消息:7月6日智谱GLM Coding Plan团队版协议生效,阿里百炼Token Plan团队版在产品页承诺不使用数据训练模型——团队版把"订阅=被训练"这堵墙凿开了一半。靠代码吃饭的人,现在选套餐要先看协议版本,而不是只看价格。
通道二:模型"串台"——你的开关保不了你
今年4月,Kimi被曝把用户A的真实简历直接发给了用户B,#Kimi泄露用户真实简历#冲上热搜。 每日经济新闻请技术专家拆解过根源:这类事故更可能涉及会话隔离、缓存复用、检索增强生成链路绑定错误、对象存储访问控制失效。知乎微博
翻译成人话:这条通道根本不走你的设置。哪怕你把所有"用于优化"的开关都关了、选了协议最干净的"不训练"平台,一次底层bug就能把你的文件送进陌生人的对话框。按《个人信息保护法》和《生成式人工智能服务管理暂行办法》,责任当然在服务商——但你的工资明细、你的体检报告在别人手里流传的代价,是他们赔不起、你收不回的。
9月13日刚发的一条辟谣笔记说"大模型基础训练是一次性完成,日常和你的单次对话不会自动录入、不会更新模型"——这话对一半,它保住了另一半的常识:没人靠你一份合同把全网模型训一遍;但它保不住上面那种隔离故障。 所以知乎那场"真有这么严重吗"的辩论里,"真正涉密的东西根本轮不到你在公网处理"这句话只对一半:这条通道漏出去的从来不是国家机密,是带同事姓名的报销单、带客户手机号那一栏的合同、你自己上传的简历。小红书
通道三:工资表事件真正的教训——不是模型泄密,是你司"裸奔"
这波事件簇里被误读最深的就是工资表。问题根本不在AI"说实话",按帖子设定,那套机器人从搭建第一天起就没做权限隔离:任何人都能问薪资。评论区里懂行的人一句话戳穿:这玩意儿居然不做权限隔离吗?小红书
这个模式并不孤立。同一评论区有人晒了自己公司的同款事故:“内部搭了AI运营系统,老板给我开了超管权限,我一眼看到每个人的底薪,我还是最低的那个”;还有人说"我同事把客户数据用AI处理,到现在没人说得清是不是本地处理"。2026年企业AI知识库正在批量落地(头条上"知识库落地痛点"的实操指南都是一排排的),而最常见的搭建姿势就是帖子里那种:人事照着教程,一天搭完,资料全传。
如果你就是公司里推AI提效的那个人,这起事件替你总结出三个上传前必答题:谁能问什么?被问之后有没有日志?工资表、绩效表这类数据进库时,有没有单独设"不回答"层?三问都答不上来,就先把"资料全传上去"叫停——提效系统建得越快,枪就递得越快。顺带一提,原帖作者9月4日发的后续又拿了418赞,给这个判断补了个真实结尾:老板做的是找AI供应商给系统加上权限和限制,重新上线。 而权限加上去之后,员工发明了"交叉提问":“薪资分几档?”“我这个岗在哪档?”"B档里谁加班最多?"AI认真回答,答着答着还是把不该说的说了出来。权限隔离是及格线,不是保险箱。小红书
通道四:红线——和开关无关,百分百不能碰
四川日报报道里两起真事:李某把涉密方案的部分内容输进手机上的AI写作APP,被严肃处理;另一例是国家机关工作人员小王,未经安全评估审批,直接拿一款开源AI工具分析内部文件,而他电脑默认开着公网访问、没设访问密码,敏感资料最终被境外IP非法访问、下载。同篇报道还提到:湖南慈利县村干部赵某把AI生成的水华通知直接转发村民群,里面"严重的直接拘留"这种违法表述引发恐慌,乡纪委对其立案;民盟河南省委会7月通报点名社情民意信息里的"AI创作滥用",案例、数据被AI幻觉编得有鼻子有眼,单位没核实就报上去了。
这些是纪律和法律问题,不存在"关哪个开关":传上去那一刻就已经违规。而比涉密更普遍的是灰色地带——学生还没发表的实验数据、客户的合同、投标的标书,都够不上"国家秘密"四个字,但都是"带走要出事"的东西,先记住那句最扎的:省的是导师的钱,出了事抓的是你。 知乎那条高赞回答给所有习惯"遇事不决就上传"的人立了个四问围栏:这份东西是谁的?谁授权你处理?数据会到哪里?出了事谁担责?知乎
那到底怎么办:一张红绿灯清单
绿灯(放心传):公开资料、通用文案底稿、不含真实姓名的模板、习题和论文思路讨论、已发布报告的改写。
红灯(永远别传):①含他人个人信息的任何材料——工资表、花名册、简历、体检报告;②客户合同、招投标文件、内部财税数据原件;③未发表的研究数据和核心代码;④任何带"内部/涉密"字样的东西,以及单位明令禁用AI处理的材料。
黄灯(脱敏后传):内部周报、会议纪要、运营数据。脱敏不是P掉名字就完事——知乎专门讲PDF脱敏的帖子提醒过:批注、文档元数据、扫描页是最容易漏的三处,发给AI前先看这三样。
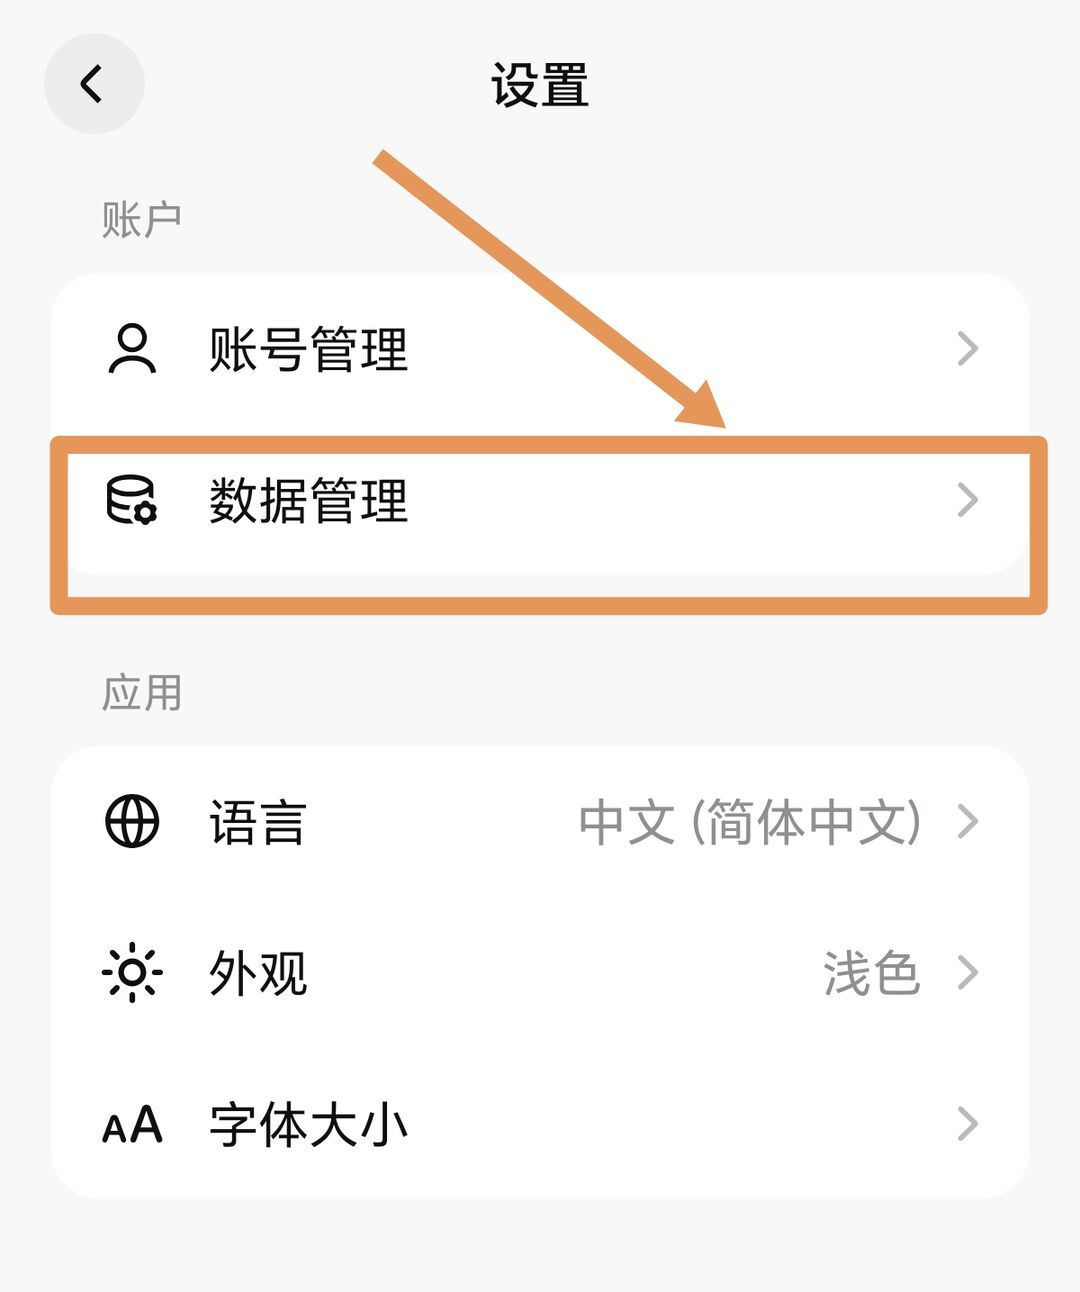
再给你5分钟做三件事:DeepSeek从设置进"数据管理",关掉"数据用于优化体验";豆包用户把语音开关关了、并知道邮件申请渠道的存在;买了个人版Coding Plan的,先把核心仓库停喂,团队要用的走团队版协议。公司里要搭AI机器人的,先问完权限三题再传资料。
GhostAI在那条知乎回答里有句话值得抄在工位上:过去带一份内部文件出公司,要复制、拍照、转发、拷U盘,每一步你都知道自己在"带走东西";现在只是复制、粘贴、发送,三秒钟,丝般顺滑——技术降低的是操作门槛,没降低价格。 模型会不会越来越守规矩,那是平台的事;什么时候你手里这份文件不该交出去,这才是提效党真正稀缺的能力。知乎