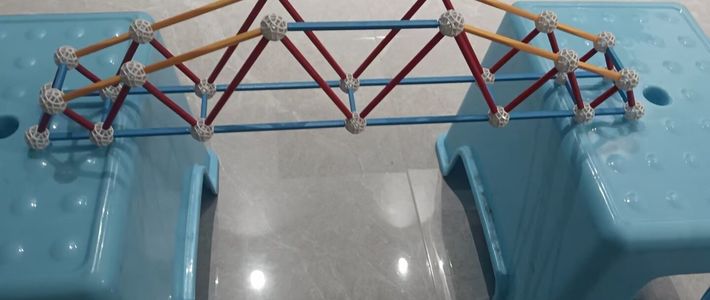
“差199元就0分”,塌的不是桥,是一份超了预算的设计图。在这场比赛里,GPT-6 Astra交出的桥造价10199元,刚好超出第五关10000元的预算上限199元,按规则直接判设计不合法、这一关记0分。总榜第一是GPT-6.2 Sol,102.67分。九个模型之间的差距,不藏在"会不会画桥",而藏在能否在确定性物理仿真里同时满足结构、预算、限时这几重硬约束。
这期比赛出自B站UP主"喵了个猫了个咪了个猫"的《AI算法对抗大赛》第9集,发布后两天内登上B站热搜,截至11月10日晚播放量超过140万次。正式开赛是2026年11月7日(洛杉矶当地时间),九个模型面对同一份选手包、90分钟限时,七关题目一次性发出,每份设计文件都是写明节点坐标、杆件类型和机关的JSON,其中"超预算"意味着设计不合法。哔哩哔哩GitHub
为什么199元能把一关清零
造桥赛的分不是评委打的,是算出来的。闯关的及格线很朴素:本关全部场景里,每辆车都按时、完好地到达对岸。过关之后比的是造价——关卡分等于100乘以参考造价再除以你的造价,和参考答案一样便宜得100分,更便宜可以超过100分;但没过、没交、超预算,都是0分。省得越多上不封顶,超一分预算却直接清零,成本控制不是扣分项,而是生死线。Claude Opus 5.5在第五关"钱不够"超预算3472元,同样吃了0分;腾讯混元在第六关造价34497元,超出20000元预算约72%。这一关禁用木杆、预算10000元,参考答案造价8216元,九位选手里只有GPT-6.2 Sol交出了预算内的合格桥。GitHub
差距从第四关开始摊牌
前几关看不出真正的分层。第一关"小水沟"九个模型全部通过,造价却从3532元拉到6065元——同一座15米水沟,Sol和Opus贴着参考答案的成本线,Kimi却花到近1.7倍。分水岭出现在第四关之后:需要让航道开合的"过船"、36米跨双礁石的"地狱关",只有前三名模型打通,第五关也只剩Sol过关。Gemini 4 Argon、Grok 4.7、Kimi K3.1 Pro、混元、豆包、DeepSeek六家集体停在这里,Grok 4.7甚至连第五、六关都没来得及交卷——90分钟要自己分配到七道题,时间管理本身就是考题。最终总榜上,Sol 102.67、Opus 79.02、Astra 73.48位列前三,第四名Gemini直接跌到45.31,国内阵营里豆包Seed Evolving以30.96分压过垫底的DeepSeek V4.1 Flash(27.93分)。GitHub
最会拆桥的那个,恰恰是丢了分的
第七关的攻防赛暴露了另一个能力维度:每座决赛桥都要挨其余8辆"捣蛋车"各撞一次,9座桥共打72局,最终18局被攻破,且没有出现任何物理异常,桥塌不塌取决于设计本身而不是引擎运气。Astra的捣蛋车攻破了8座桥里的6座,攻防分87.5全场最高,却因第五关那199元的0分只排第三;Sol守住了自己桥的全部8场对攻,还攻破了5座别人的桥。算得力、守得住预算、拆得动别人的桥,这三件事没有一个模型全占齐。GitHub
至于AI造的桥为什么容易一压就塌,有博主给出了更底层的解释。B站UP主千云自己写了一套桁架受力求解器,用电脑随机生成一千座桥逐一验算。这里的"机构"指几何上不稳定的框架:方框不加密斜撑,一压就散成平行四边形。造桥游戏里每一根杆都在受力,模型输出的却只是文字和坐标,中间隔着一层必须自己算准的力学——这正是差距最直观的落点。哔哩哔哩
这张榜还不是能力判决书
主办方在开源仓库里把话说得很克制:九位选手分别用Codex桌面版、Claude Code、OpenCode等不同工具接入,思考档是启动配置、无法逐请求验证,工具和接入渠道不同,不能把本场结果当作模型能力排名。同一题材的比赛这周不止一场:11月9日,ModelDial社区参考Steam造桥玩法自制了6道闯关题,把国内外8个主流大模型拉来同台比拼。选手全程看不到画面、不给计算器,纯靠模型脑算交图纸,其中Grok在一关算了80分钟仍交了白卷。对普通用户来说,与其记名次,不如记这个观察点:这类比赛把造价、预算、限时摆成了可量化的硬指标,全部设计图和评分脚本开源,任何人都能重跑成绩、核对自己关心的数字。想判断"模型能力差距藏在哪",下一场把工具和采样条件对齐的比赛,会比这张榜更有说服力。GitHub哔哩哔哩