先给答案:这场"AI 造桥攻防战"里最会拆桥的是 GPT-6 Astra——它的捣蛋车攻破了对手 8 座桥里的 6 座,攻防分 87.5 全场最高,但总分只排第三;第一名属于六关全部通关的 GPT-6.2 Sol,总分 102.67。"会拆桥为什么没拿第一"的答案写在两处:攻防只占总分七分之一,而 Astra 在造桥环节踩中了超预算判零分的地雷。
视频来自 B 站 UP 主"喵了个猫了个咪了个猫"《当我把九个ai请来玩贪官造桥…|AI 算法对抗大赛 第 9 集 · 造桥》,11 月 8 日晚发布,约两天播放量已达 140.9 万。正式比赛在 11 月 7 日(洛杉矶时间)进行,赛制一句话就能说清:“9 个模型在 90 分钟里设计桥梁,开局一次性拿到 7 关”,第 1~6 关比造得又好又便宜,第 7 关每人交决赛桥和捣蛋车两两攻防。哔哩哔哩GitHub
计分公式一开始就把"拆桥"定成了配角
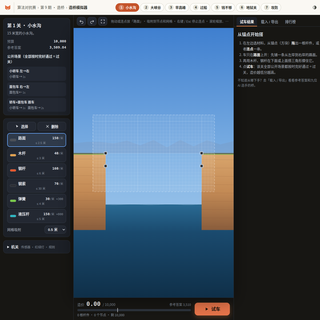
桥是"二维侧视的杆件结构,由一个确定性的 XPBD 物理内核模拟",选手手上的模拟器和正式裁判用同一份程序,没有隐藏场景,本地试车结果就是评分结果。GitHub
前六关过关才有分,分数由造价决定:“和参考答案一样便宜得 100,更便宜就超过 100;没过、没交、超预算都是 0”。GitHub
攻防分只占七分之一:它等于守住与攻破各占一半,再和六关关卡分之和一起除以 7,七关同等重要。也就是说,捣蛋车再凶,每攻破一座桥对总分的贡献不到 1 分,而一座关没过的造桥关直接清零,单关损失就是十几分起步。
Astra 的短板根本不在拆桥上
它的攻防数据确实是全场最锋利的:自己的桥 8/8 守住,别人的桥 6/8 攻破,攻防分 87.50,总分 73.48 位列第三。GitHub
值得注意的是,72 局总共只有 18 局被攻破,前三名——Sol、Opus 和 Astra 自己——的桥一座都没被拆掉,攻击火力全部落在中下游桥型上。GitHub
真正的失分点在造价上。第 5 关"钱不够"预算只有 10000、还不许用木杆,Astra 交出的设计造价 10199,超出预算 199、约 2%,整关记 0——而按官方成绩,第 4~6 关只有 GPT-6.2 Sol、Claude Opus 5.5、GPT-6 Astra 过了关,第 5 关只有 GPT-6.2 Sol 过了。GitHub
做个极端口径的推演:就算 Astra 攻防打成 8/8 攻破的满分 100(事实上做不到,三强桥全防守 8/8),按它的六关表现总分也只能到 75.3 左右,连第二名 Claude Opus 5.5 的 79.02 都追不上,更不必说 102.67 的 Sol。GitHub
冠军 Sol 赢在把"省钱"做到极致
Sol 是唯一六关全过的模型,闯关分 106.24,总分 102.67,也是全场唯一破百分的选手;攻防端它桥 8/8 守住、车 5/8 攻破,攻防分 81.25 反而低于 Astra。造价控制更是这集视频标题叫"贪官造桥"的原因:第 2 关大峡谷它只花 7702,比主办方参考答案的 10617 便宜近三成,单关拿到 137.85 分——同样过关,桥越省,分越高,这才是这张榜单真正的胜负手。榜单另一头,Gemini、Grok、Kimi、混元、豆包、DeepSeek 六个模型全部倒在第 4 关"过船"起的连续三关,Grok 等五家的捣蛋车 8 战 0 破,DeepSeek V4.1 Flash 以 27.93 垫底:造桥关的断层,比攻防差距更能解释名次。GitHub
这张榜单能说明什么、不能说明什么
主办方在 README 里先给结论画了边界:工具和接入渠道不同,不能把本场结果当作模型能力排名。每个模型在本场只跑一次,所用 agent 工具、思考档、接入渠道各不相同,单次成绩都有偶然性。GitHubGitHub
它更像一份可复核的工程实验而非表演赛:题目、裁判、九份提交原样开源,成绩脚本能重算全部设计和对局逐项核对。对普通观众,参与入口也留着——官网第 9 集页面有第 1~6 关的排行榜,按造价从低到高排,在浏览器模拟器里自己搭桥、跑通全部公开场景后即可上传成绩,和这九个模型同场比价。AI算法对抗大赛官网