

在 SC26 超级计算大会上,群联展示了一套把 NPU 和 64GB 专用内存直接装进 SSD 的新方案:盘内 130GB/s 带宽,宣称支持 PyTorch、vLLM、OpenVINO、llama.cpp 等主流推理框架,官方称数据搬运可减少 10 到 100 倍,同场亮相的还有目标速率 28GB/s 的 PCIe Gen6 X3 主控。这听起来像一次参数发布,但它瞄准的是本地 AI 的三座大山:模型装不下、内存买不起、数据来回倒。微博
先算成本账。一台 35B 的 MoE 模型,量化后权重仍接近 20GB,KV 缓存还要随对话变长继续膨胀,32GB 内存的笔记本里内存、显存两头都塞不满。偏偏近半年内存和 SSD 都在涨价——快科技 11 月 20 日的数字显示,1TB SSD 从 355 元涨到 850 元,32GB DDR5 从 900 元涨到 3800 元。在这种行情下,把一部分“内存的活”交给远比 DRAM 便宜的 NAND,是扩容最便宜的一条路。微博
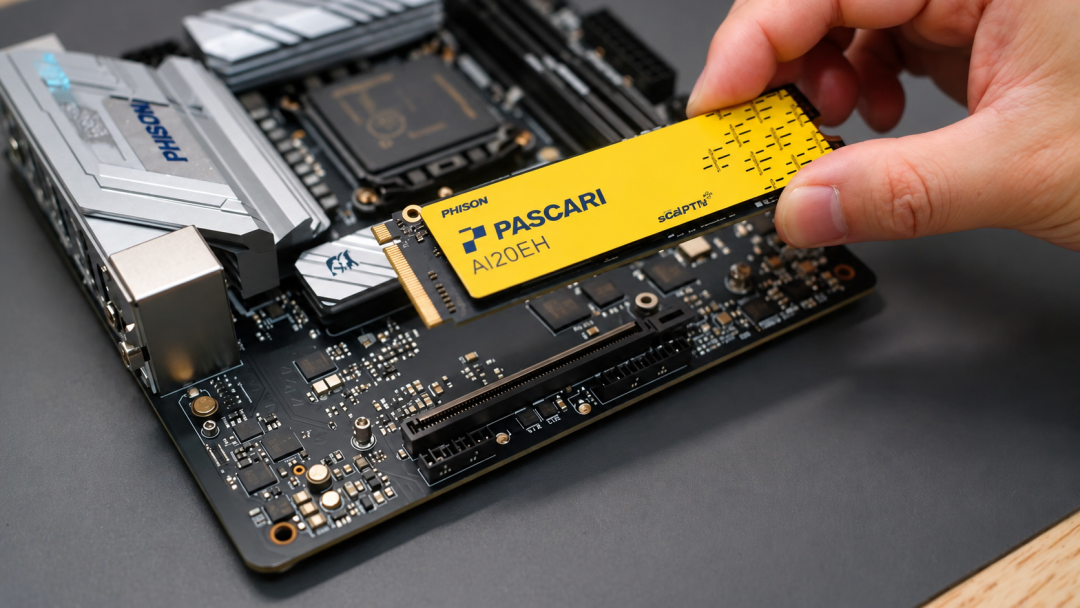
这个方向并不是从零起步。群联已经在推进的 aiDAPTIV+ 方案里,高速闪存被变成 GPU 的内存层,MoE 模型的“冷”专家参数被卸载到硬盘上、推理时按需取用,让内存和显存装不下的大参数模型也能在本机运行。整机厂也在跟进:机械革命发布会现场演示,一台 32GB 内存的轻薄本跑 35B 模型,问完之后的等待时间从 14 秒多缩到 2 秒多。极摩客的实测里,首字响应从 18.2 秒缩短至 456ms。另一组对比测试中,Qwen-122B 在普通 SSD 环境启动失败,换上 AI SSD 后成功启动。这些数字都出自厂商或合作方,尚缺第三方复测,但指向一致:硬盘首先改变的是“跑不跑得起”,而不是“每秒多几个 token”。哔哩哔哩哔哩哔哩知乎微博哔哩哔哩哔哩哔哩
已商用方案的瓶颈同样清楚:盘还是个被动仓库。KV Cache 的量化、索引、查找、搬移全压在 CPU 上,显存压力是转移了,CPU 先累垮,数据还要在盘、内存和 GPU 之间绕几道弯。SC26 方案的增量就在盘侧的那点算力和内存:搬运整理在盘里完成,等于把一部分计算从 CPU/GPU 挪到存储端。行业的脚步也在往同一方向走:英伟达 CMX 已经在 HBM、主机内存和共享存储之间建立面向 KV Cache 的 POD 级 Flash 上下文层,把存储节点放进了推理数据路径。知乎微博36氪
看这条新闻还有三个提醒。“少 10 到 100 倍搬运”目前只是厂商口径,尚无公开第三方实测;现场流传的 36,800 DMIPS 是 CPU 整数处理能力指标,不是 TOPS 口径的 AI 算力,不能当作这块盘能跑多大模型的尺子;方案仍在开发阶段,群联没有给出上市时间,现场观察者的判断是企业级会先试水,消费级短期没戏。落到普通用户:已经在本地跑模型的,搭载 AI SSD 的整机已经开售,不必等这块新盘;只是日常用 AI 的,主力计算仍在 CPU/GPU 上,这块盘短期不会让手上设备的 AI 变聪明。真正值得盯的是信号本身——存储正在从算力的外挂仓库,变成推理链路的一部分,而它争的其实是“每 token 成本”这门生意。微博
当前文章无评论,是时候发表评论了