这些年国产GPU发布会,纸面峰值算力一个比一个猛,实际跑起来怎么样却是另一回事。10月28日天数智芯媒体开放日换了个报法:上海仪电今年7月的第三方实测显示,典型PD分离部署下,天垓300折算单卡端到端吞吐达到H200的1.05倍,成为国内首个实测性能摸平H200的通用GPU。深科技半导体产业纵横
值得关注的不是"赢了H200",是这个口径。峰值算力是仪表盘上的极速,端到端吞吐是高速上的实际跑表时间——显存带宽、互联、算子调度、部署形态全都算在内,它才决定你每秒能吐多少Token。活动现场连"每百万Token成本"都写进了PPT,连千卡强化学习都是按交付时长报的:1024张卡跑完一次1T总参数MoE基座约500亿生成Token的RL后训练,约26天。算力的讲法,从参数变成了账单。IPO早知道
几个数字值得挨个拆开,它们对应一条条能感知的体验:64K长上下文Attention为H200的1.05倍、GLM-5.3在64K规模MoE吞吐1.15倍、8K至128K场景Agent首字延迟降低约10%—30%。搜广推在线业务里,推荐推理吞吐提升21%。长时间满负荷跑,步时波动0.43%,比对标的Hopper方案0.76%还稳。训练侧,Qwen3-32B八卡FP8单卡有效吞吐达H100的1.33倍。半导体产业纵横芯东西IPO早知道深科技
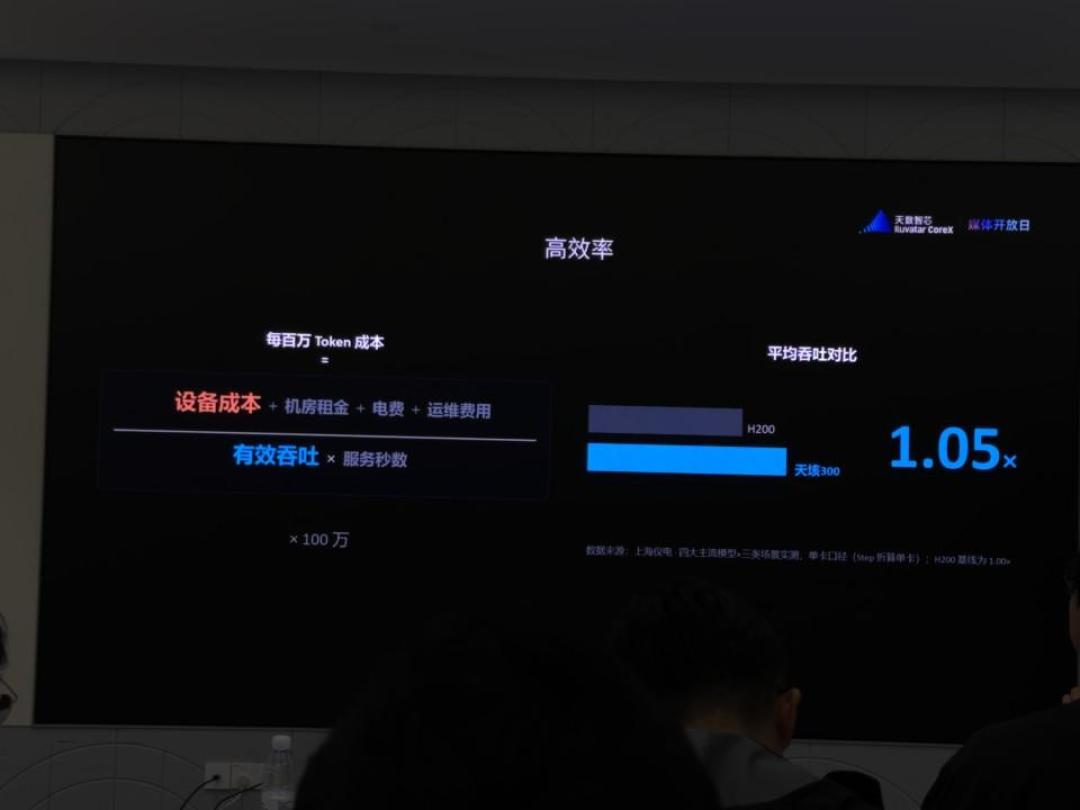
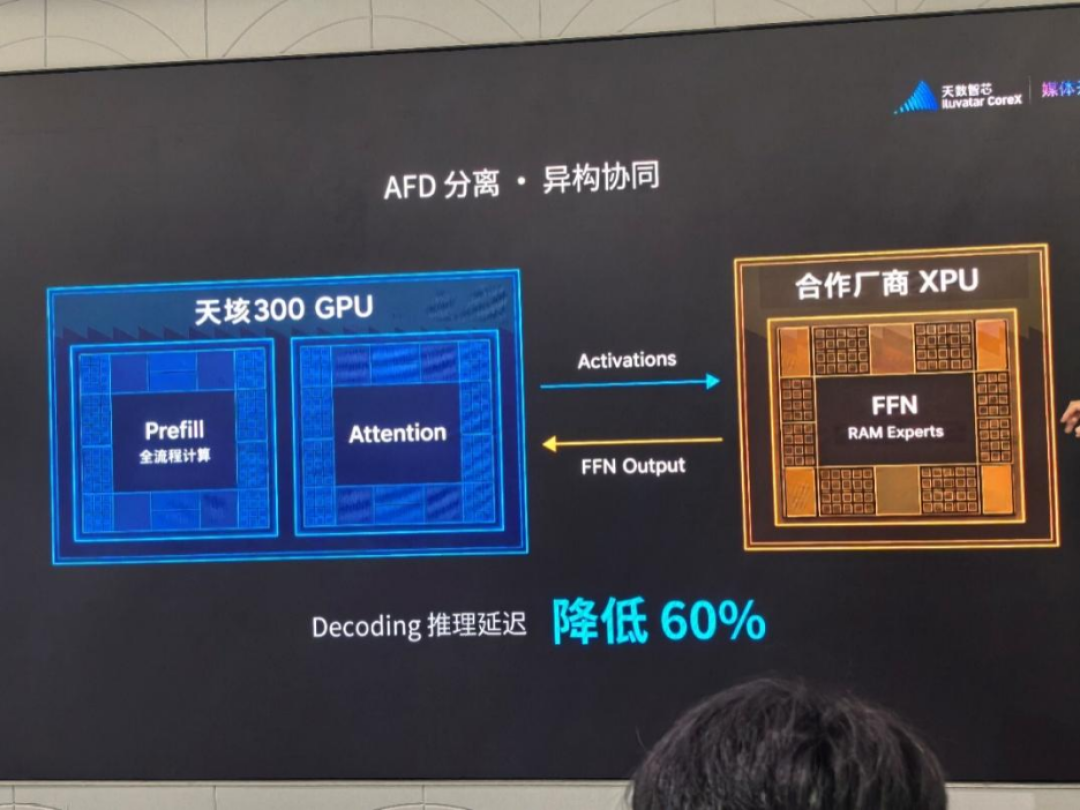
玩并行计算的,最关心的其实是两件事。一是CUDA兼容性:天垓300通用架构原生支持CUDA语义,主流框架均已适配——迁移成本才是国产卡是生产力还是展品的分水岭。二是新的并行形态AFD分离:GPU承担Prefill和解码侧Attention,FFN专家网络交给合作厂商XPU,统一调度下实测Decoding推理延迟降60%,号称国内首个实际跑通的GPU+XPU异构AFD方案。再加上IXL144超节点:单柜144颗GPU、聚合近10.1TB显存,测算每百万有效Token成本较国际主流方案低约40%。半导体产业纵横深科技芯东西
欢呼先缓一缓,问号也得摆出来。1.05倍是四大主流模型、三类场景、特定部署条件下的折算吞吐,不是"全面超越H200";推理数是第三方实测、训练数是现场演示,引用时别混口径。评论区最扎的三个问题——什么制程、谁代工、何时量产交付——现场没有回答。而H200至今仍是衡量先进AI算力的公认标杆。摸平它的意义恰恰在于:国产卡终于有资格坐上同一张牌桌被实测。在真正装进客户机房跑起来之前,这轮成绩最踏实的读法是那句:国产GPU的评价尺子,终于追上了真实能力。IPO早知道