

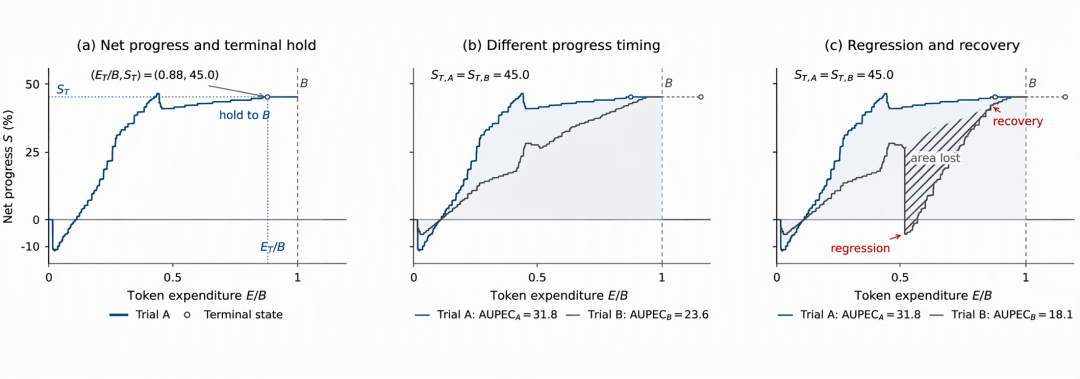
“用 AI 写代码越写越乱”不是错觉,也不只是上下文不够长。SoTALab 团队 11 月发布的 SWE-Continuum 评测里,让编程 Agent 持续接收需求、修改同一个项目,123 次有效运行中有 17 次出现过回归,发生回归的 29 个检查点里,27 个的净进展还在上涨——总分上涨,完全可能与旧功能损坏同时发生。在这个共同机制之上,GPT、Claude、Gemini 三个主流模型又各自添了一种乱。知乎
为什么越改越乱
论文的设计是把需求分阶段释放到同一个持久工作区,每轮验证不仅测新功能,也复查此前已经通过的基线测试。python-05 任务里,19 个新增测试通过的同时,10 个原先通过的测试失败,净进展反而上升 7.63 个百分点;论文还在阶段间注入错误建议的对照中发现,错误建议会引发更多回归,且多数最后也没恢复。对话端的原因更日常:同一段记录里旧要求、新要求、被否掉的方案堆在一起,模型只能挑“看起来最相关”的那一条,轮次越多挑偏的概率越大,“反复修改”就变成了“反复回退”。知乎知乎
三个模型,乱的形状不一样
社区实测给三家的画像,坑并不相同。
GPT(Codex 线)的画像是纪律性强,但过度设计是明确写在实测结论里的缺点:后端会一路膨胀,必须在架构上狠狠挤水;不限制的话,它连读一个输入文件都要读两遍、比对哈希值才敢往下走。工程细节上的吐槽同样集中:大方向没问题,小 bug 满天飞,兜兜转转找不到问题也修不好。高思考强度下不画好框架,思考一多、上下文一压缩,连最初的目的都可能忘掉。知乎知乎知乎
Claude 是编码和长任务里最常被点名的那一档,风格被概括为稳、不谄媚,让它挑错它是真挑。它的乱来自额度与信任两个方向:改一个大功能动辄读一堆文件、来回好几轮,实测者担心额度中途耗尽、项目卡在半成品;它的旗舰线 Fable 5.2 与 Opus、Sonnet、Haiku 5.5 各自独立编号,选型时容易点错档位;而越周全的输出越容易让用户过度信任它,实测提醒后端架构设计也不能整个交给它。知乎知乎知乎知乎
Gemini 的坑从命名就开始了:模型系列用了化学元素名,但原子序数和档位并不对应,氢(1 号)是快省档,碳(6 号)是最强档,氩(18 号)反而在中间档。有实测者自嘲,以前用 Argon 当主力写代码老觉得漏东西,换上更强的 Carbon 后又让低一档的模型去审查它的方案,两头都用反了。出结果快本身也是心理陷阱:快到让人嘀咕是不是没想仔细,可“慢”并不等于认真。知乎知乎
三个能立刻用的收口办法
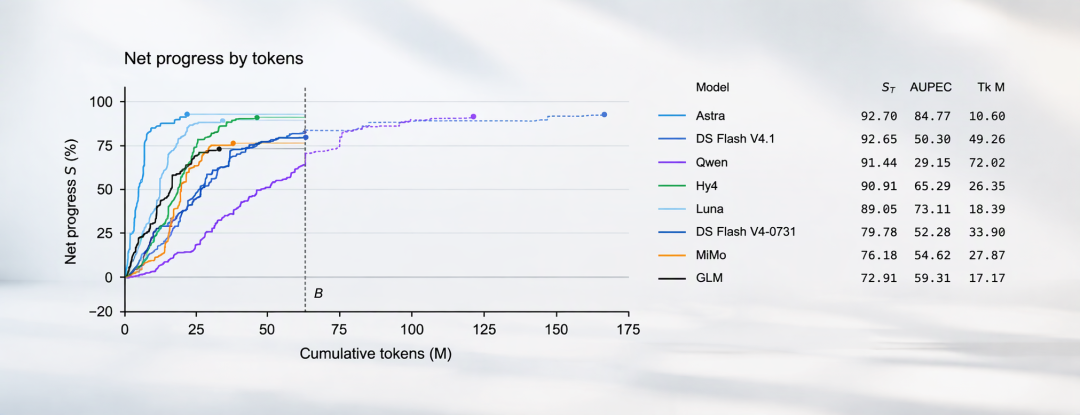
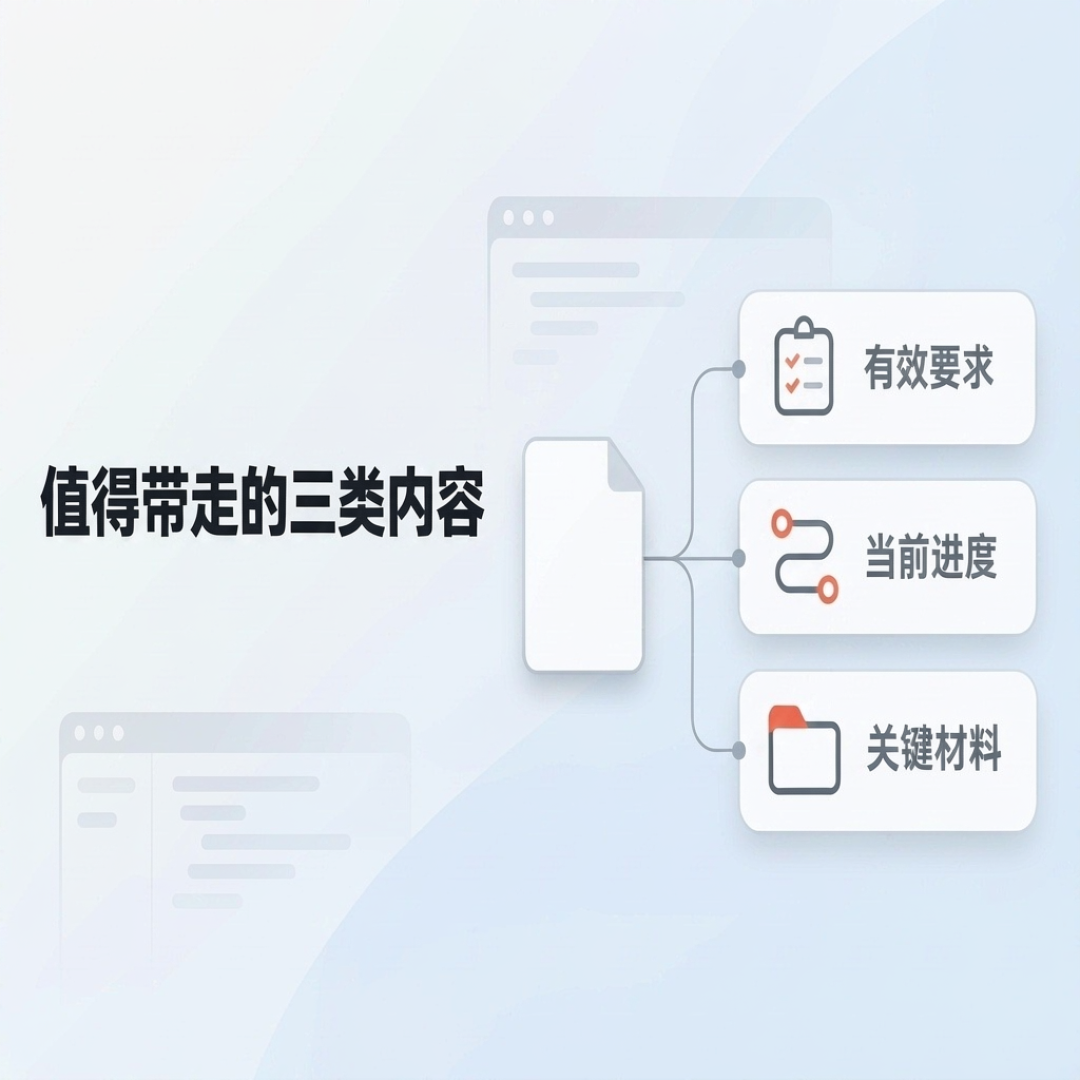
第一,换对话时别整段搬运聊天记录,值得带走的是核对过的有效要求清单、当前进度和关键材料,已经撤回的要求要连适用范围一起写清楚。第二,让规矩被机器检查,而不是写在文档里靠自觉:把分层规矩写成可自动执行的测试,再配一个 hook,AI 每次准备交活时自动跑,测试不过就把报错交回给它继续改。实测案例里,AI 被打回一次后自己改成走 Service,最终两个测试全部通过。第三,选型先说清口径:“最后交付多少”和“固定预算内保住多少进展”是两笔账,论文 28 对模型组合里有 14 对排序发生反转,只看其中一列容易选错。知乎知乎知乎
当前文章无评论,是时候发表评论了