

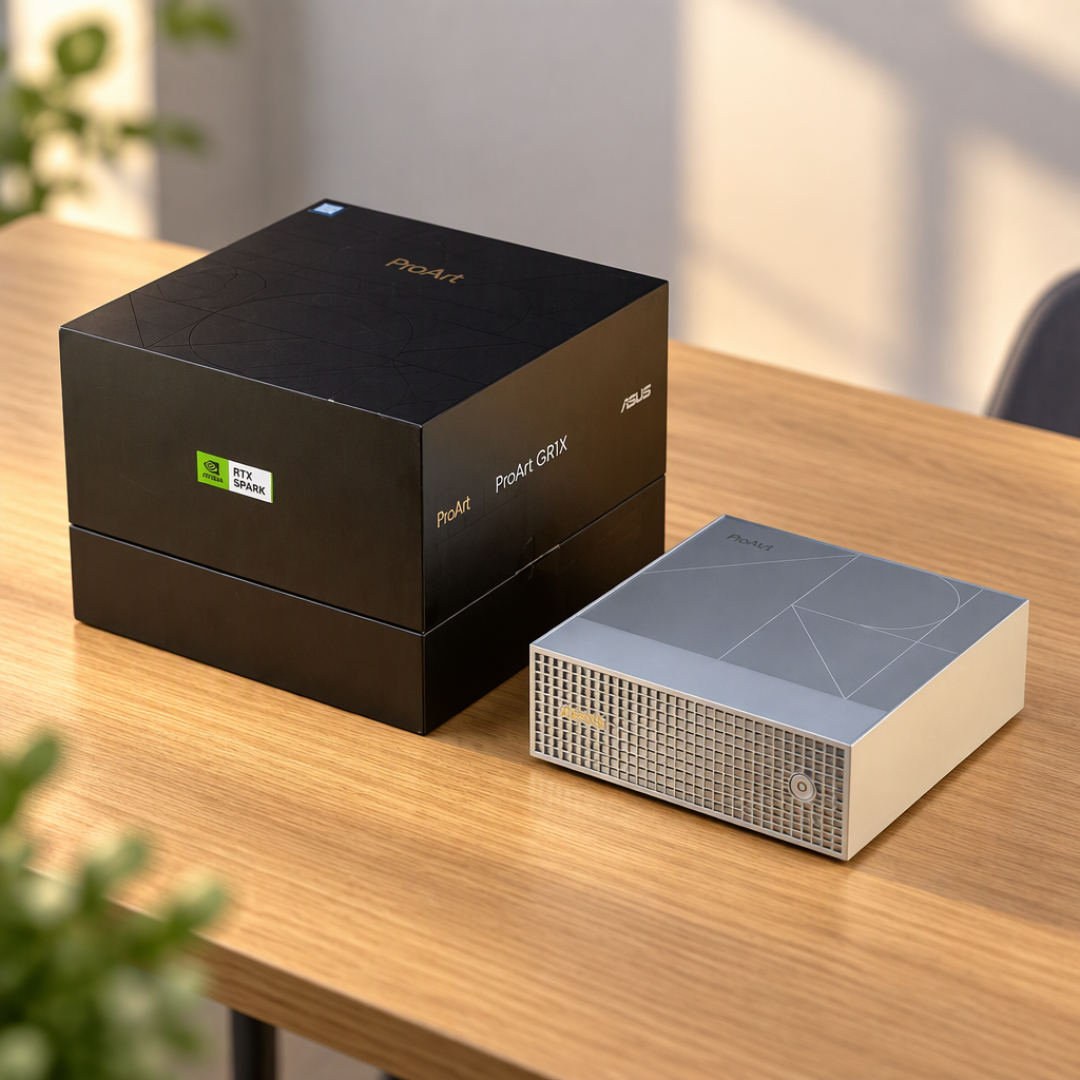
11月18到19号,华硕、微星、机械革命像约好了一样,把同一个巴掌大的盒子搬上桌。32999元起,顶配56999元。它叫 RTX Spark,英伟达第一颗真正的 PC SoC。知乎微博知乎哔哩哔哩
有意思的是,答案一个月前就有了。10月28号极客湾发《RTX Spark性能实测》,17分钟,66万播放,3318条评论。现在回头看,评论区比视频更值钱。
本质是一张带128G显存的计算卡
芯片代号N1X,20核Grace CPU由联发科深度定制,GPU是Blackwell架构、6144个CUDA核心,配最高128GB统一内存,官方标称最高1 Petaflop的AI算力。极客湾的架构解读拆得更细:台积电N3工艺,两颗die封装,10颗Cortex-X925超大核加10颗Cortex-A725中核,CPU与GPU之间走NVLink-C2C互联;GPU有48组SM,规模接近桌面版RTX 5070,比移动版还大一些;统一内存是LPDDR5X-9000,256-bit位宽,带宽300GB/s。它还纠过一个偏:很多人以为RTX Spark对标的是高通骁龙X那种轻薄本芯片,其实它定位超高性能SoC,参考对象是苹果M-Pro/M-Max和AMD Ryzen AI Max 395;这三家都能上128GB统一内存,带宽这块苹果仍占优,但算力上RTX Spark靠第5代Tensor Core是毫无疑问的王者。知乎知乎
评论区最狠的三句
634赞:“这机子本质就是一张带128G统一大显存的移动计算卡,发哥CPU纯属开机启动器”。哔哩哔哩
357赞:“我说这是最便宜的128g显存blackwell显卡,谁赞成谁反对。”
269赞:“很幽默的产品,性价比不如 395,跑 AI 不如 m5m,打游戏更是连 5060 笔记本都打不过”——m5m指的是M5 Max。
三句话指向同一件事:它不是全能机。要游戏,5060笔记本更便宜更快;要纯AI性价比,AMD 395更划算;要带宽,苹果还是老大。那为什么还有人愿意掏三万?两个字:CUDA。
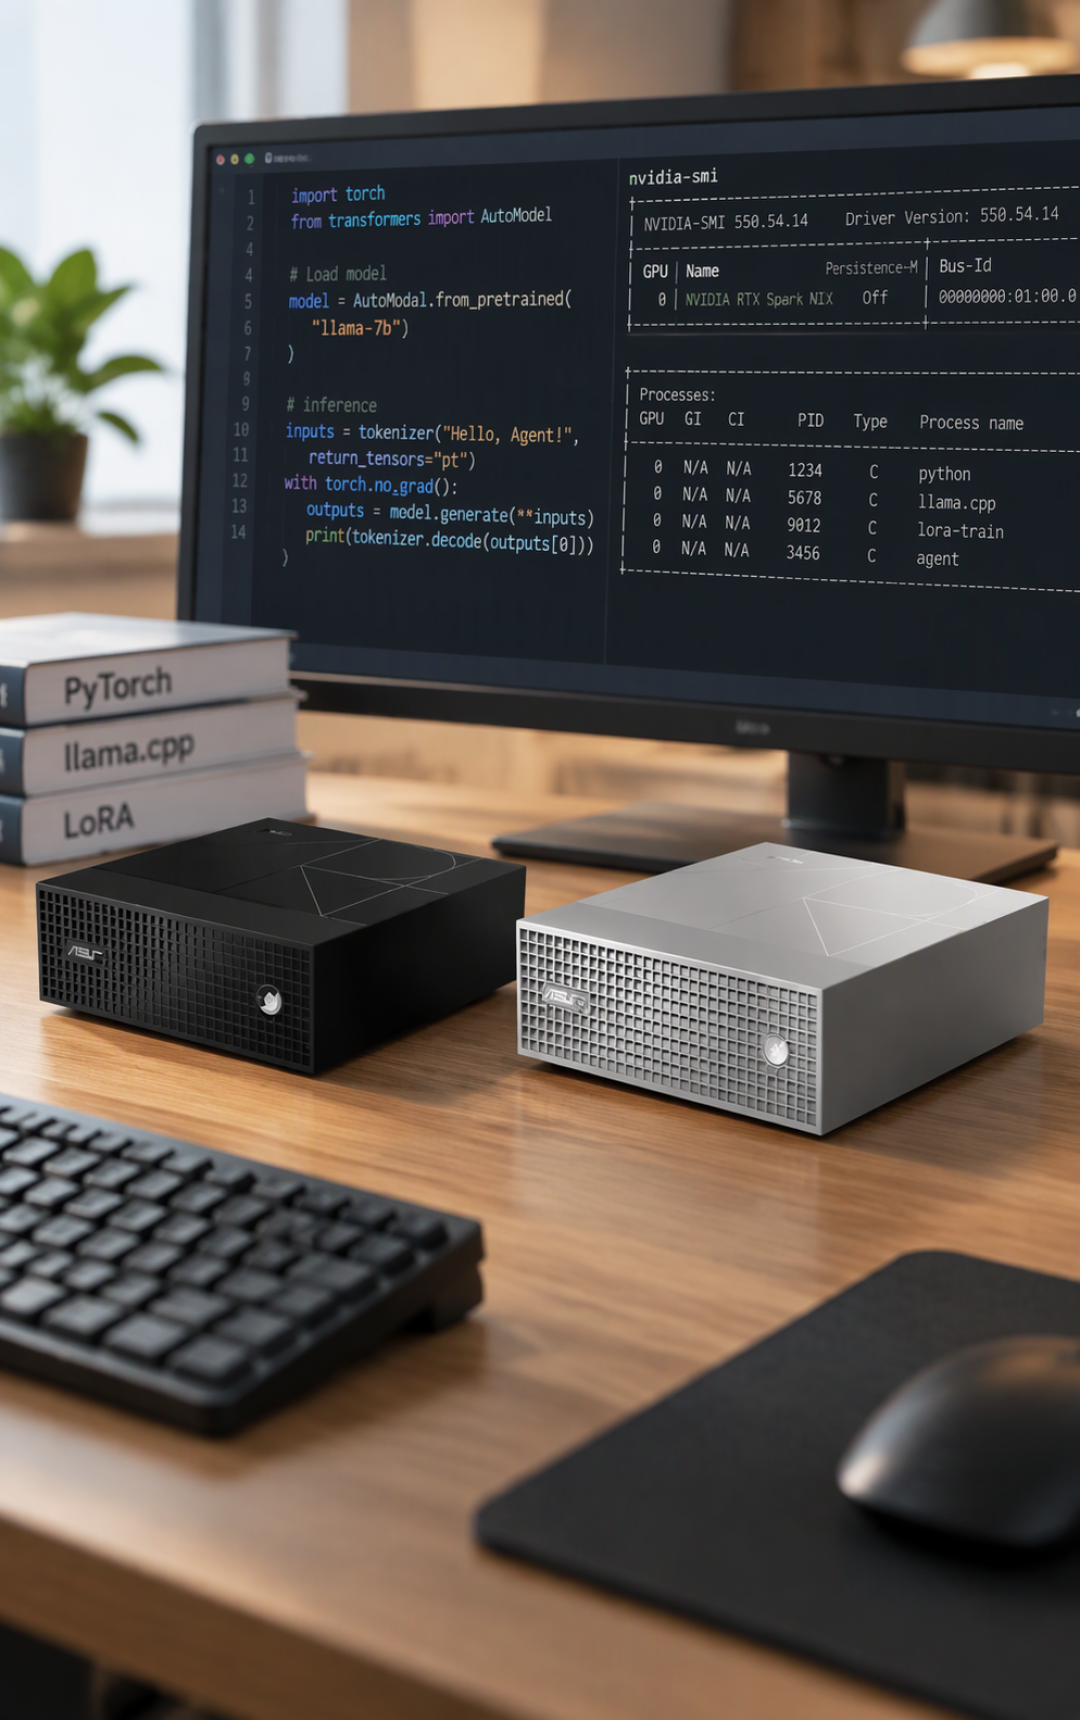
322赞说得最透:“高通搞WoA开发者还得去折腾DirectML,老黄直接把原生CUDA搬过来,现成算法近乎零成本平移”。对天天跟PyTorch、llama.cpp打交道的人,这条护城河值三万块。93赞那条很实在:以前游戏本的显存根本不敢碰模型训练,现在拿Spark跑自己数据集的LoRA微调,能稳定跑完,不担心爆显存。哔哩哔哩
四个坑,下单前必须知道
一、Windows on Arm兼容性。这是极客湾自己点名的最大短板:非原生Arm软件走Prism模拟层会损失10%~30%性能,Windows上还有不少32位老软件,开发者同时维护x86和Arm的动力也不足。知乎
二、128G不等于128G显存。评论区有人实测,NVIDIA App目前设了上限,128G版本最多只能开96G给GPU,再高开不了。哔哩哔哩
三、别拿笔记本的数据推桌面。笔记本受供电和机身厚度限制,处理器手动最高只能设到85W,换成桌面SFF形态后整机功耗上限提到了140W,机身也做到15×15×5.1cm。知乎
四、接口给得抠。三家都是四个USB-C加万兆网口,但华硕和微星只有20Gbps,机械革命只有10Gbps。微博
三家怎么选
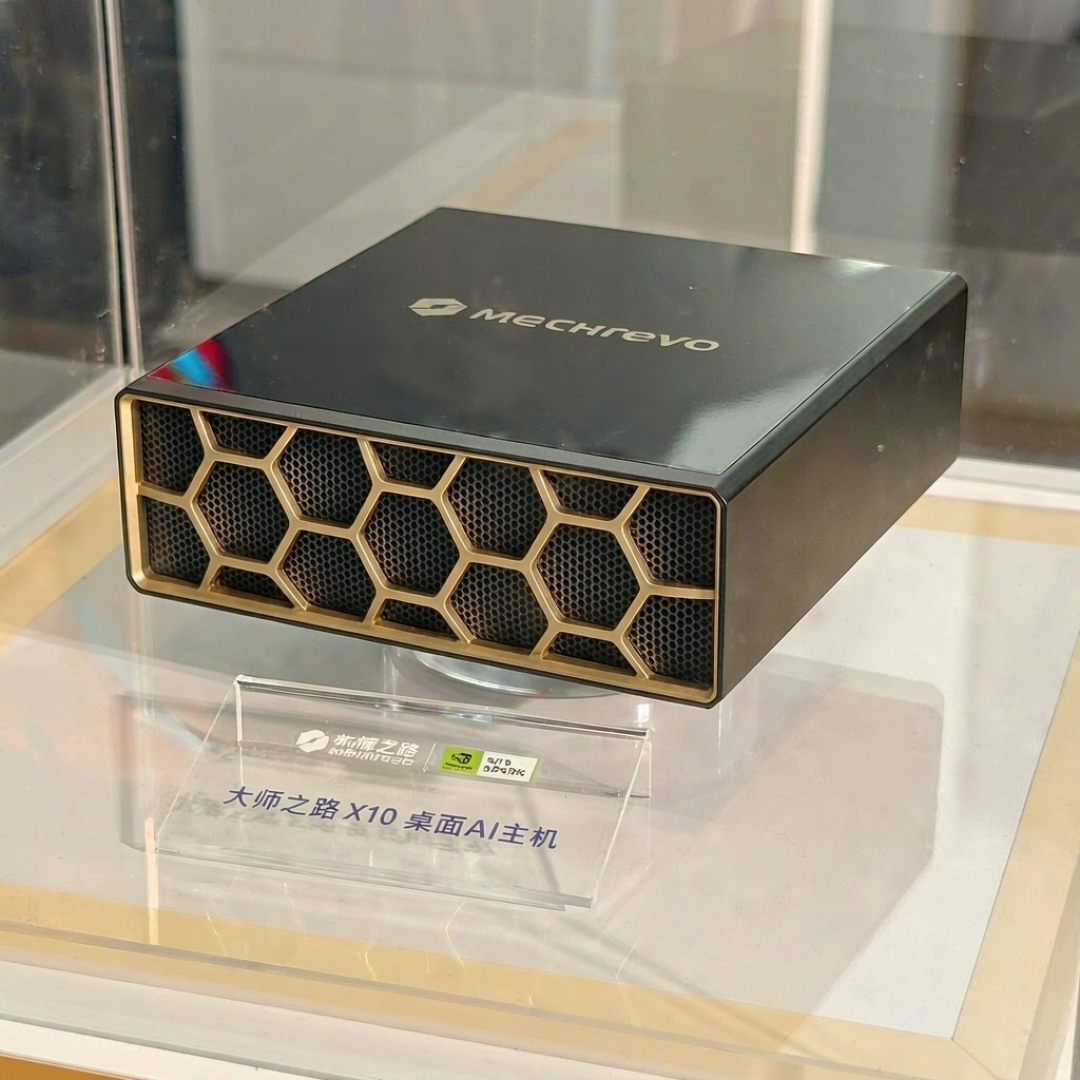
都是NVIDIA公版设计,性能体验层面几乎相同,能比的是价格、扩展和售后。机械革命大师之路X10:64GB+1TB 32999元,128GB+2TB 49999元,1.25L机身,起价最低。哔哩哔哩微博知乎
华硕ProArt GR1X:64GB+2T 34999元,128GB+4T 54999元;微星EdgeMesa N AI+:64GB+1T 33999元,128G+4T 56999元。GR1X拧开底盖四颗螺丝就能自己加一根2280规格的PCIe 5.0固态,完全没必要为大容量版本的高溢价买单。技嘉把AI TOP AERO做成约1升的紧凑机身,配USB Type-C、10GbE有线和Wi-Fi 7。宏碁、戴尔、惠普,以及微软Surface RTX Spark Dev Box随后就到。微博知乎知乎知乎
谁该买
该买的人很窄:要在本地跑大模型、做微调、让Agent全天候常驻,而且整套工具链离不开CUDA。对这类人,它是目前最便宜的128G显存Blackwell。不该买的更多:想拿它打游戏、想当主力办公机的,别碰。
最后留个容易被忽略的变量。楠爷在GR1X上把推理引擎从llama.cpp换成TensorFold,跑Qwen3.8-Flash-Next的平均解码吞吐提升116%,首字响应延迟降低58%,GPU平均功耗虽然高了10%,但干完同样的活时间缩短一半,整轮能耗和单Token能耗反而下降44%。同一台机器,换个引擎差一倍。下单前先确认你要跑的那套东西有没有原生适配——这件事比纠结买哪家重要得多。知乎

当前文章无评论,是时候发表评论了