

登顶设计榜的Gestalt,不是设计教科书里常被引用的那条心理学原理,而是一个连开发团队都没公开的匿名AI模型。"普通人能不能用上"的直接答案是:眼下用不上——它没有产品入口、没有价格,连作品都无法公开查看;但把它推上榜首的那把尺子,现在就能用在任何一款AI设计工具上,这才是这次事件跟普通做设计的人真正有关的部分。
榜单上发生了什么
11月18日,Contra Labs和BenchFlow上线了一个名为Frontier Design Benchmark的设计能力评测榜。这张榜测的不是"能不能出图",而是"好不好看、好不好用":33项设计任务中,27项改写自真实客户需求,另外6项来自创业公司合作项目,覆盖网站、品牌展示、网页应用和移动端。知乎知乎
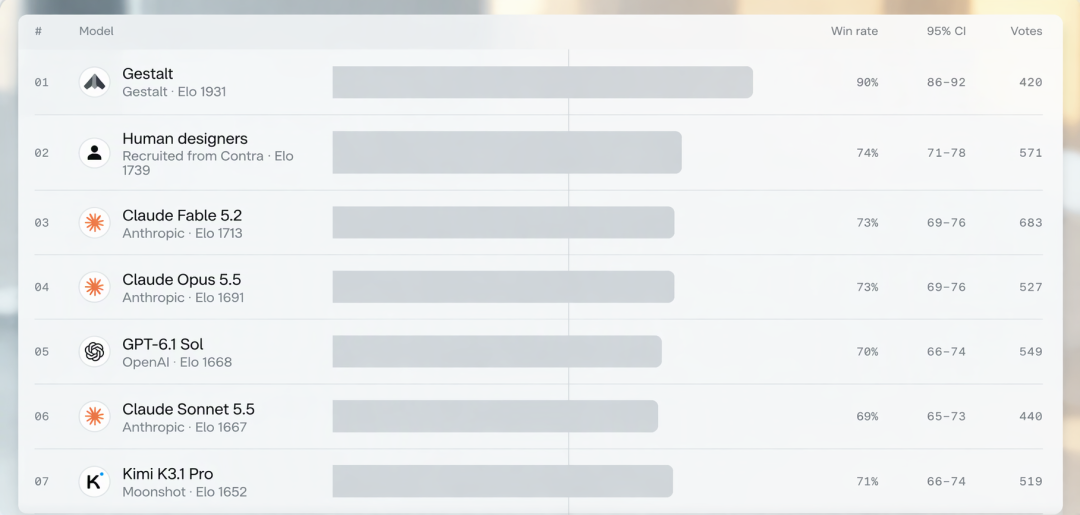
评审方式是盲测:35名专业设计师不知道页面出自哪个模型,两两对比、按实际呈现效果投票。榜单第一名是匿名模型Gestalt,Elo评分1931、胜率90%,把具名旗舰模型全部压在后面。第二名不是任何模型,而是专业设计师制作的人类参考组,1739分、胜率74%;具名模型中最高的Claude Fable 5.2为1713分。知乎微博知乎
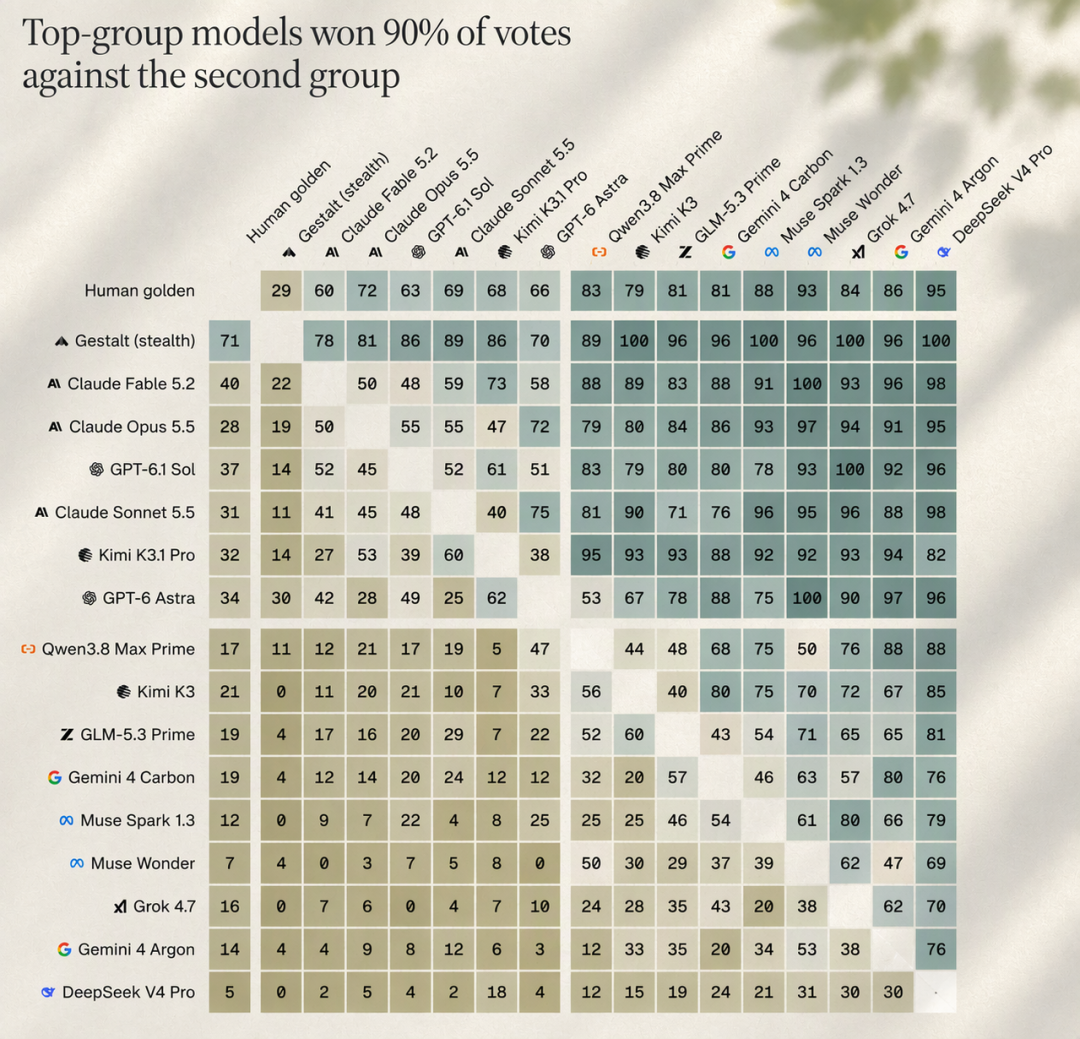
最有说服力的一组数字是正面对决:Gestalt与人类参考稿共交锋28次,设计师有20次选了Gestalt。整个榜单上,只有Gestalt的分数排在人类参考前面。知乎知乎
它现在还用不上
官方对Gestalt的标注只有"匿名",开发团队、模型架构、价格、试用方式全部没有公开。社区猜测集中在某家美国实验室的未发布新模型上。截至11月22日,没有任何一种说法得到官方确认。知乎微博知乎
顺带澄清一个容易混淆的点:中国人民大学高瓴人工智能学院GeWu-Lab等机构此前公开发布过一个同名的多模态学术模型Gestalt,它与这次匿名上榜的选手只是撞了个名字,不是一回事。知乎小红书
更关键的细节是:公开画廊只展示具名模型的产出,Gestalt的作品目前任何人都看不到。也就是说,连"设计师20次赢过人类稿"这件事,局外人都无法亲眼核验,所以"等它上线再试用"这条路暂时是空的。真正能等到的,是行业把"设计品味"当成竞争轴之后带来的后续红利。知乎
现在能用上的,是让它登顶的那把尺子
这次事件里可以直接被普通用户拿走的东西,是一套判断"AI设计做没做到位"的显性标准。榜单在盲测投票之外还配了设计评审标准和"AI味"检测。这套检测按0到100分打分,分数越高越像AI生成。知乎知乎
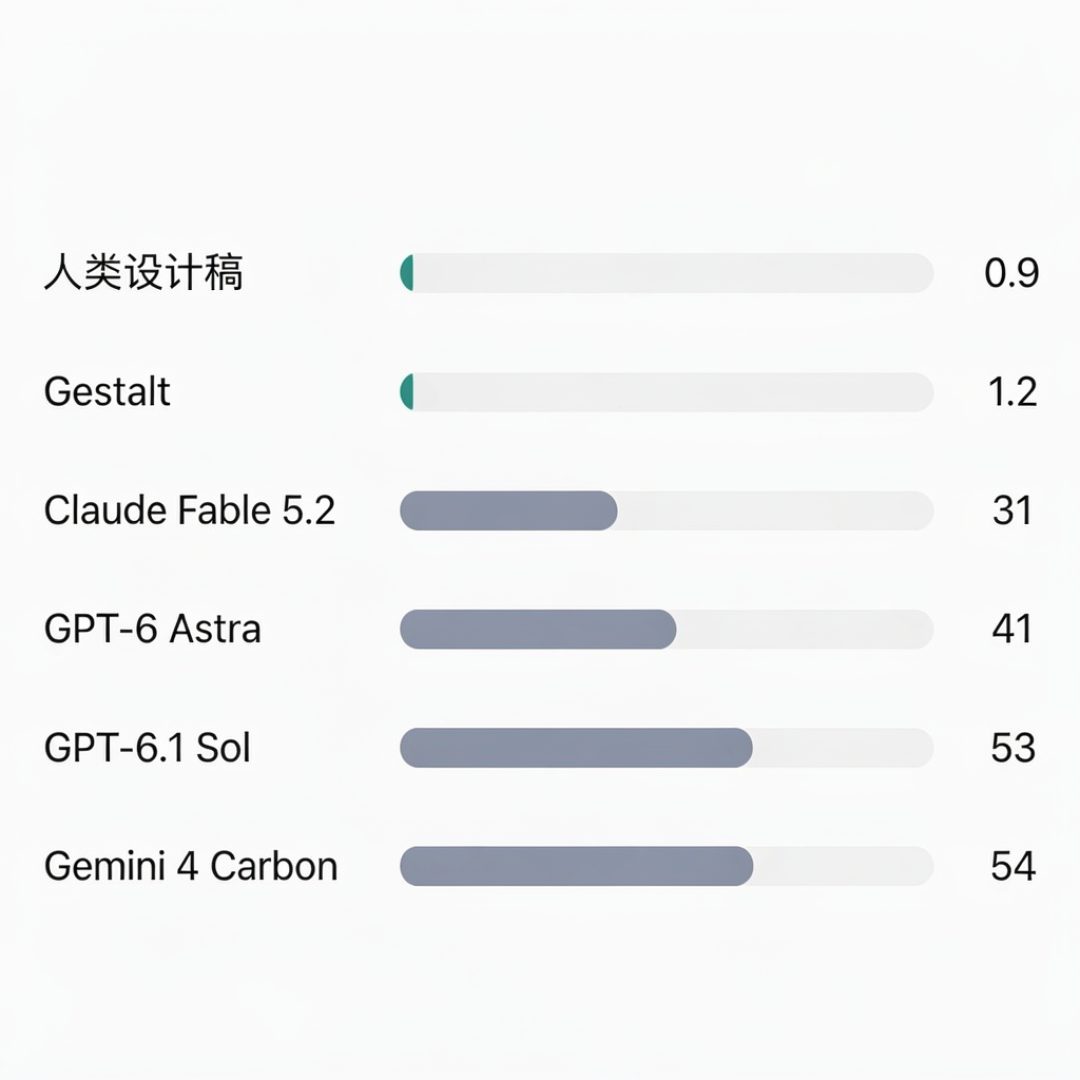
检测器抓出的是一套相当具体的"视觉指纹":标题上方的小型大写微文案、01/02/03编号版块、渐变滥用、卡片堆砌、玻璃拟态、超大圆角、纯黑深色模式、巨大居中英雄区——绝大多数AI生成页面都带着这套口音。知乎
而在这套检测里,Gestalt与人类参考作品的差距落在误差范围内,主流具名模型与人类组的差距则达到两个数量级。知乎
Gestalt登顶的实质,不是"比别的模型更会做设计",而是"比别的模型更不像AI在做设计"。知乎
这也解释了模型名字的指向:Gestalt在德文里是"整体/完形",格式塔心理学的第一命题是整体大于部分之和,而设计审美恰恰是整体判断。落到用法上:让手头任何一款AI生成页面后,对照上面那份指纹清单逐项删改,往往比换模型见效快;提需求时与其说"做得好看点",不如明确元素之间的整体关系——分组、留白、信息层级。知乎
还有一个值得记住的反转:在"设计规范符合度"单项评分中,Gestalt得83分,反而略低于Claude两款模型的84分。登顶不等于每一项都第一,照抄"冠军"输出之前,先想清楚自己的规范要什么。知乎
哪些结论现在还下不了
这是一张"裁判与受益方同源"的榜单:Contra既运营设计师接单市场,又发布评测设计师能力的基准,成绩没有第三方复现。Artificial Analysis、LMArena等独立评测聚合站目前也未收录这次结果。知乎小红书
最受关注的人类对决只有28票,来自与Contra网络关联的封闭评委组。因此"AI已经超越人类设计师"目前不成立,证据能支撑的只是:在这套盲测安排下,一个匿名模型的输出比人类参考稿更常被专业设计师选中。接下来值得盯三个信号——开发方是否正式认领、作品是否进入公开画廊可核验、其他评测机构能否复现。三个信号落地之前,1931分是一个值得认真对待、也值得认真怀疑的数据点。知乎


当前文章无评论,是时候发表评论了