

用AI写代码、跑Agent的人,有个隐性痛点:你花几周调好的提示词、工具规则和重试逻辑,一旦换了底层模型,基本等于白干。谷歌研究者还发现:一套在Claude Opus上深度进化过的配置,直接套到Gemini身上,得分比Gemini自带的初始配置还低。新模型看不懂前人为什么这么写,把修Bug的代码当冗余删掉,越优化越烂。36氪
11月13日谷歌与宾夕法尼亚州立大学研究者提交到arXiv的论文,就是治这个病的。新智元21日解读后,有自媒体直接喊「谷歌内部已实现RSI(递归自我改进)」。先别激动,看它到底做了什么。arXiv
改的不是大脑,是「交接文档」
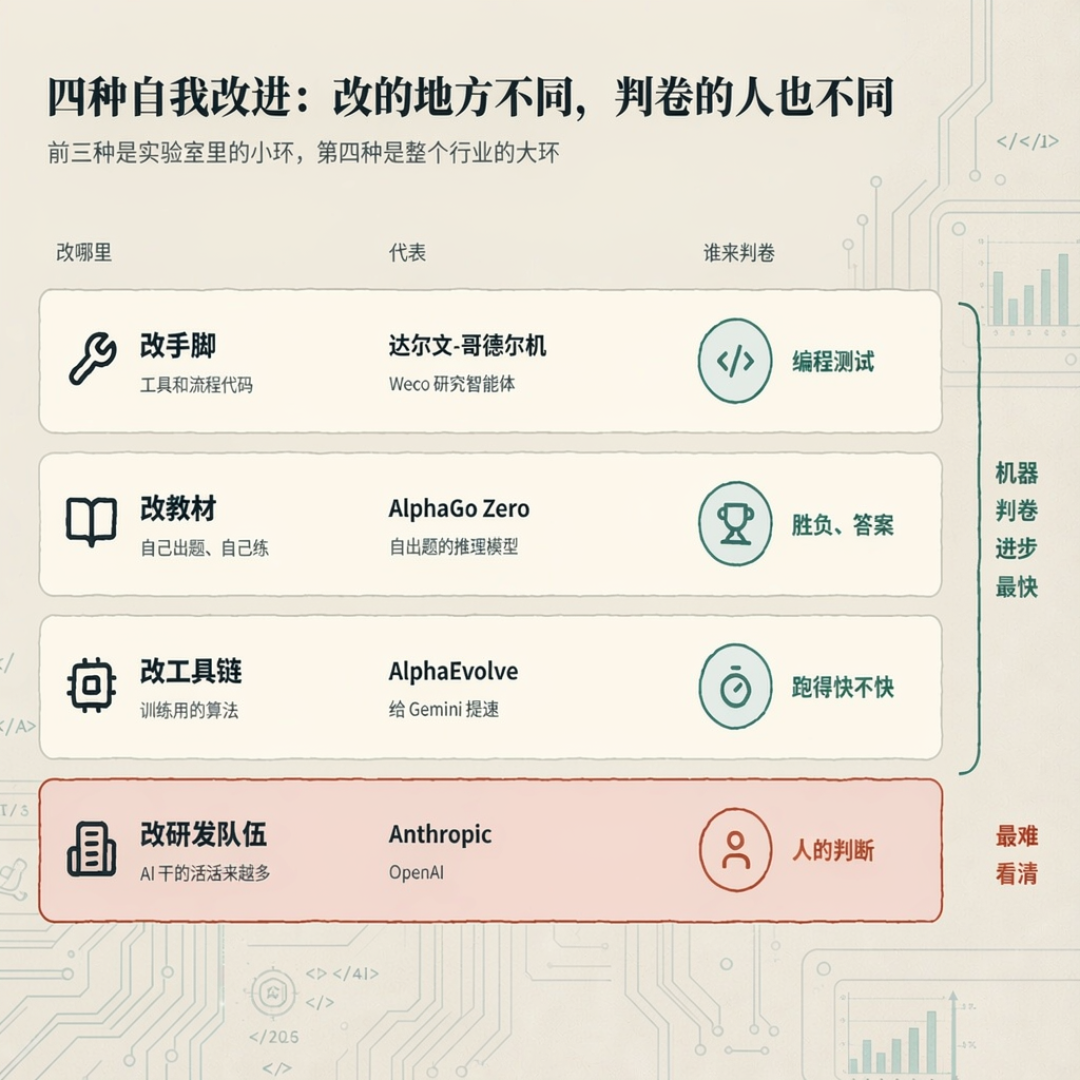
论文不动模型权重,改的是模型外面那层「机甲」——业内叫Harness:提示词、工具、拦截规则都在里面。思路很朴素:给AI优化器配一份结构化「开发日志」,叫SIM(自我改进记忆)。每次改代码,必须记下四件事:为什么改、预期什么效果、实际跑出来什么样、在哪个模型和数据集上测的。36氪arXiv
相当于上一代AI「离职」前留下详尽的交接文档,下一代先读日志再动手,不会再通宵修自己刚搞出来的Bug。
数据在论文里,不在标题里
跨模型接力实验中,Claude Opus 5.5进化出的Harness被打包交给Gemini 3.8 Flash继续优化:
只传代码、不传记忆:Workspace任务从68.41的起点挣扎到73.42;
继承完整SIM:一路飙到84.75,拉开11.33分。
Terminal-Bench命令行任务里,10次独立运行,带记忆的一方赢了9次,最终得分平均高出2.36分(p=0.003)。这组数字写在论文摘要里,不是自媒体加工。36氪arXiv
为什么值得你关注
2025年10月,Karpathy还估算「持续学习」这道坎要十年才能填平。今年11月初,Anthropic的智能体记忆报告已显示新模型会自发记笔记、区分已验证结论和猜想。谷歌这篇论文又补上一块:经验连模型家族都能跨越,直接遗传。36氪
这或许也解释了谷歌的发版节奏:Gemini 4 Hydrogen和Neon间隔不到一周。经验能复利,迭代自然越滚越快。
但有三条边界要划清
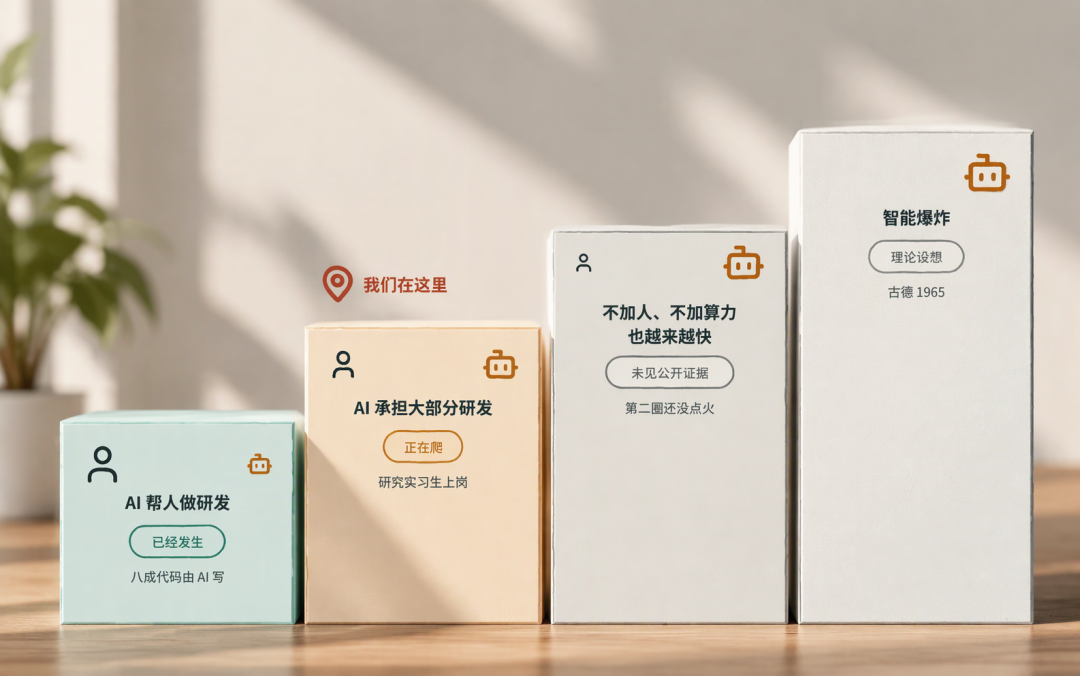
第一,论文验证的是Harness层的优化,不是模型改写自己的权重,离「AI自主造出下一代AI」还很远。第二,「内部已实现RSI」是标题加工,论文摘要没这么说。第三,知乎一条百赞回答泼了盆冷水:RSI也是大厂讲给VC的商业故事,论证的是「强者恒强」。Anthropic在11月2日招股书里写「可能很快」达到AI显著加速研发的门槛。生命未来研究所随后联名要求停止「鲁莽的竞赛」。技术进展是真的,融资叙事也是真的,你得自己分开看。知乎知乎
对你最直接的影响:模型和Agent工具更新更快,换模型的迁移成本更低,调好的配置有望不再「一次性」。但别为「自我进化」卖点提前掏钱——现阶段能遗传的是日志,不是智能。


当前文章无评论,是时候发表评论了