

谷歌在 11 月 20 日宣布 Gemini 现已支持直接生成 GIF 动画,驱动它的是最新视频模型 Gemini Omni 1.2 Flash。用自然语言写一句需求,或者上传一张照片、一段视频,就能得到约 3 秒的循环动图,做好后可以直接复制粘贴,也能下载成 .gif 文件。它和市场同类产品最关键的差别就在底层技术:这张动图是视频模型生成出来的连续画面,而不是把几张静态图拼起来的伪动画,并且"循环"从一开始就是生成目标。微博今日头条小红书
一句话做动图:入口就藏在聊天框里
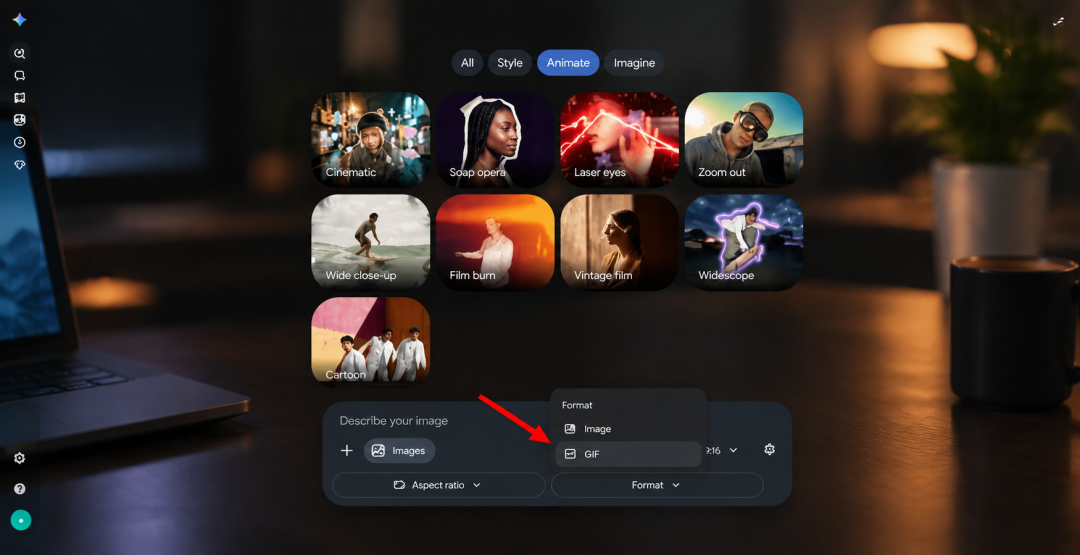
按官方说明,入口就是日常生图的那条路径:在主聊天里输入提示词,或者打开图片与视频工具,选择 GIF 再描述需求,等待片刻即可生成。官方举的典型用途有两类——给照片加循环特效,以及从零做搞笑表情包。官方帖给这件事的定位是 Say goodbye to searching for the perfect one:想要一张刚好合适的动图时,不必再去表情包库里大海捞针,现在可以现做一张。今日头条小红书小红书
差别在哪里:视频模型生成,图像网格拼帧
GIF 生成不是谷歌独一份,OpenAI 的 GPT-Image 2.6 同样有 GIF 功能,评论区里已经把"一家有了另一家也会有"称为良性竞争。知乎上有开发者做了上手对比:GPT-Image 那边的动图依然有明显的逐帧感,Gemini 这边乍看以为也是同样的图像网格拼帧思路,实际背后跑的却是生成连续动作的多模态视频模型。小红书知乎
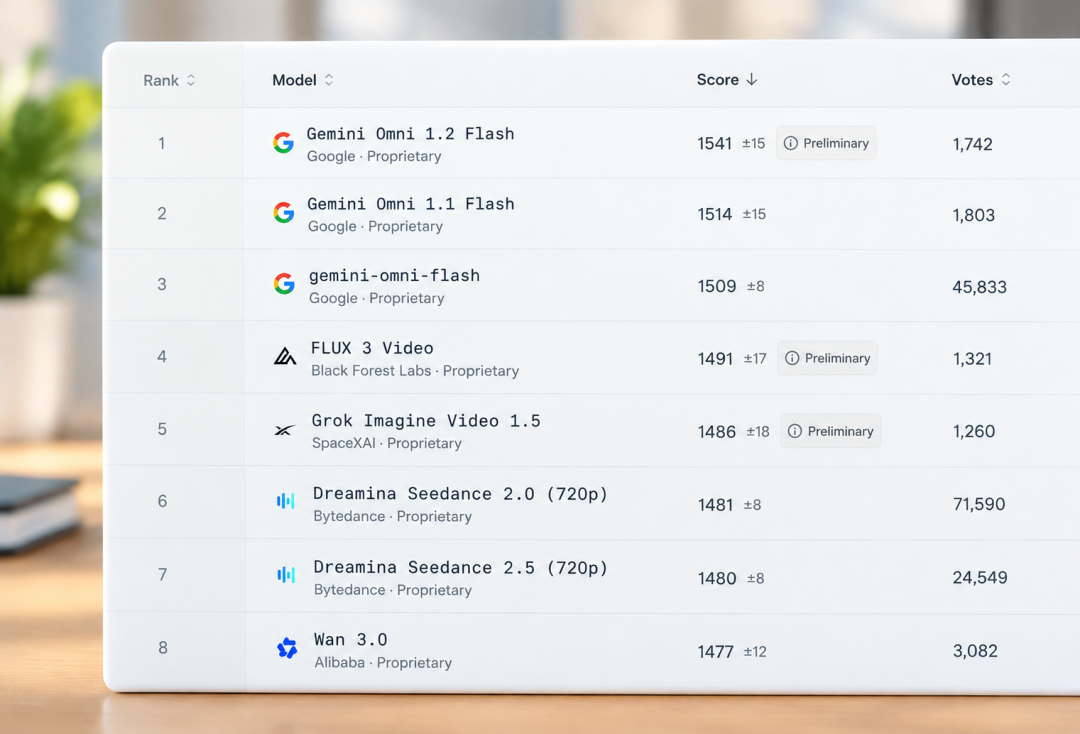
支撑它的 Omni 1.2 Flash,是谷歌 11 月 6 日发布的新一代视频模型:一次最长可生成 15 秒视频,API 价格下调 30%,发布时一度在 Arena 文生视频、图生视频两个榜单同时登顶。知乎
视频时长可以精确到秒、3 秒到 15 秒任选,GIF 恰好取用最短的 3 秒档,而不是"生成视频再转 GIF"的压缩产物。那位做过对比的开发者把这套打法概括为把视频生成能力"低配化"、适配做 meme GIF 的场景——用视频级的表达力,换表情包级的成本和速度。知乎知乎
真正的考验:循环的头尾接不接得上
动图顺滑只是一半,GIF 的命门在循环。社区检验循环图的标准很朴素:盯末帧和首帧是否衔接得上,对不上,循环到边界就会"断"一下。过去用视频模型做动图,普遍要走"先生成视频、再用工具转 GIF"两步,首尾能不能循环基本听天由命。小红书
这次官方特别提到,GIF 生成能让每一帧动作流畅、画面前后一致。Omni 1.2 发布时也以画面前后一致性提升为卖点,一镜到底、急速拉远这类复杂运镜里的无端跳切明显减少。今日头条知乎
已经拿到入口的网友晒出了小猫冒爱心、人物动起来的作品。但这样的样本还少,"首尾闭环"在大规模真实生成里的成功率仍待验证——视频模型的方法在动作质量上确实占优,循环接缝却不会因此自动解决。今日头条
用之前:门槛比功能本身更值得看
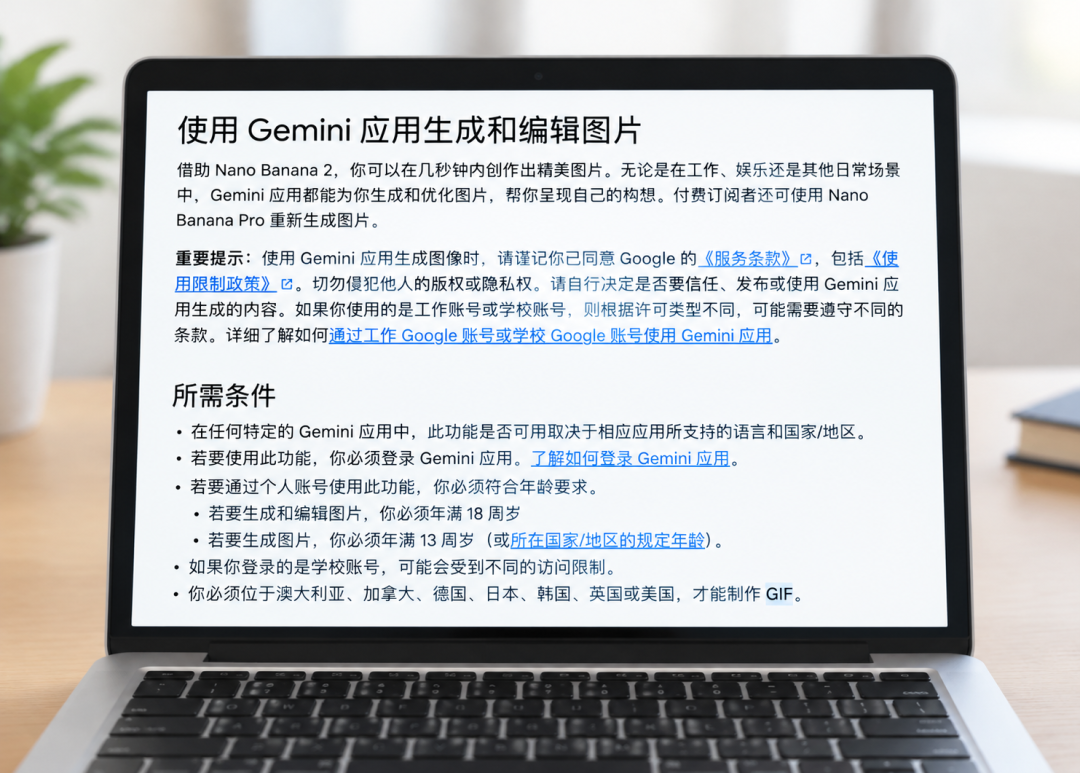
条件要先看清:个人账号需要开通 Google AI 订阅计划,工作或学校账号还需具备符合条件的 Workspace 许可,目前不对 18 岁以下用户开放。并且必须身处美国、日本、韩国、澳大利亚、加拿大、英国、德国和法国这八个逐步开放的国家和地区。这项能力正在逐步推出,账户里暂时没看到入口不代表故障,也还不是全球可用——换句话说,中国大陆用户目前大概率还用不上,一些转述教程里"人人都能做表情包"的说法并不准确。小红书今日头条小红书
再看趋势:图像法与视频法两条技术路线,如今打进同一个表情包场景;而榜单上紧随 Omni 之后的国产视频模型 Seedance、MiniMax 走的是按秒计费、基本锁死 24fps 以上的正剧管线,目前没有这种轻量玩法,不过那位开发者认为,国内模型"捣腾下,搞出这种降配玩法应该也不是什么难事",只是还没人出手。对普通用户来说,这件事的实际意义是:以后的小动图会越来越倾向于现做,而不是现翻;接下来值得盯的,是谁先把循环接缝和生成成本这两件事同时做扎实。知乎


当前文章无评论,是时候发表评论了