

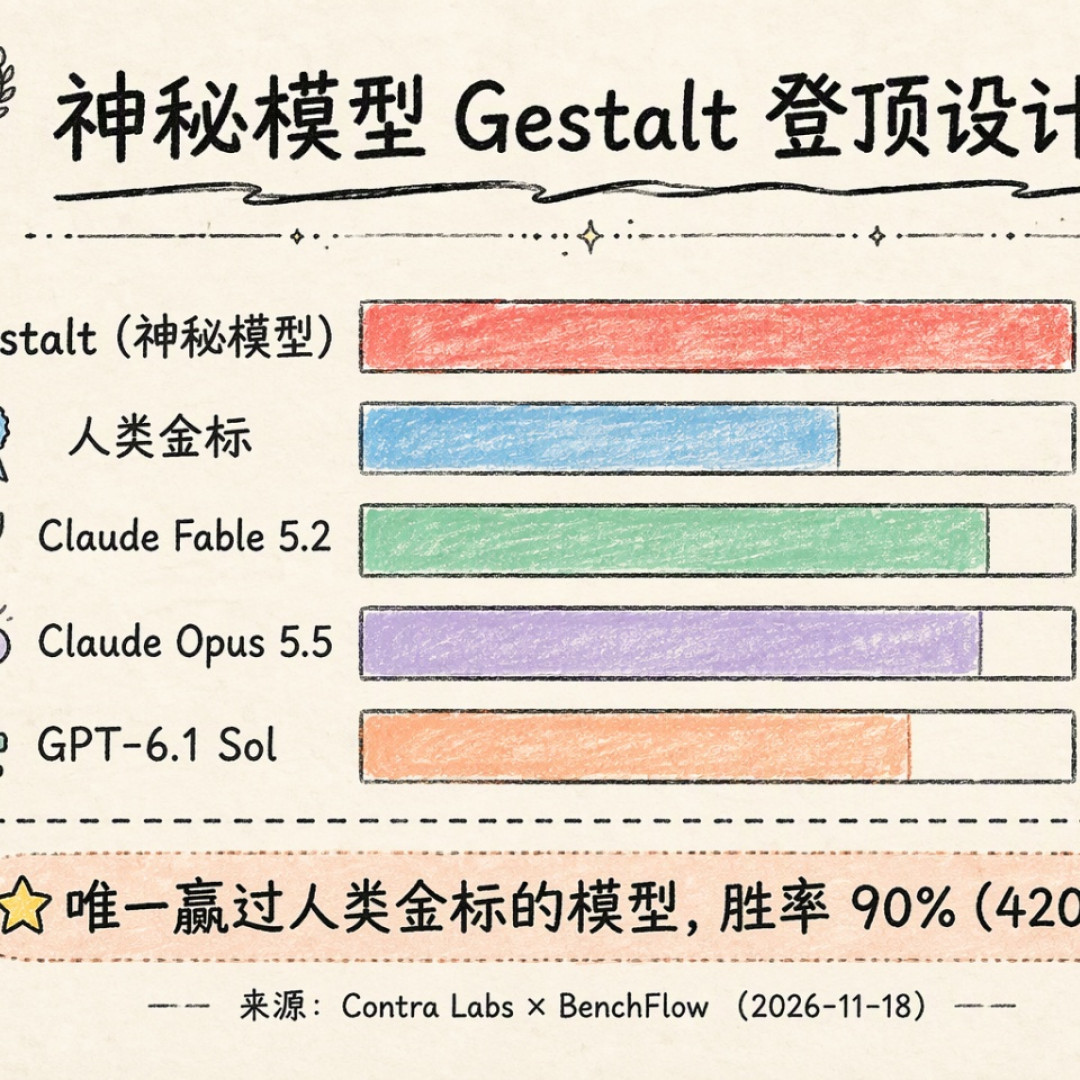
11 月 18 日,Contra Labs 联合 BenchFlow 上线了设计榜单 Frontier Design Benchmark 的首期结果:33 个设计需求(27 个改编自平台上的真实客户需求),由 35 位专业设计师两两盲投,累计 4,311 票。榜首是一个代号 Gestalt 的神秘模型,幕后研发方至今没有公开:Elo 1931。第二名不是模型,而是由专业设计师完成的参考作品,1739 分;具名模型里最高的 Claude Fable 5.2 是 1713,GPT-6.1 Sol 为 1668。哔哩哔哩知乎知乎知乎知乎哔哩哔哩
Gestalt 赢的是盲评中的整体品味——胜率断层、页面几乎尝不出 AI 味;没赢的是设计规范检查表(83 对 84),以及可验证性:没人看过它的产出,也不知道它花了多少钱。
赢在哪:断层胜率,和比人类还干净的页面
盲测胜率 90%,420 票。在 AI 模型之间通常只差几十分的谱系里,它领先人类参考设计 192 分、领先 Claude Fable 5.2 218 分,以断层优势登顶。在与人类金标的 28 次直接对决中,设计师选择了 Gestalt 20 次。知乎知乎知乎知乎
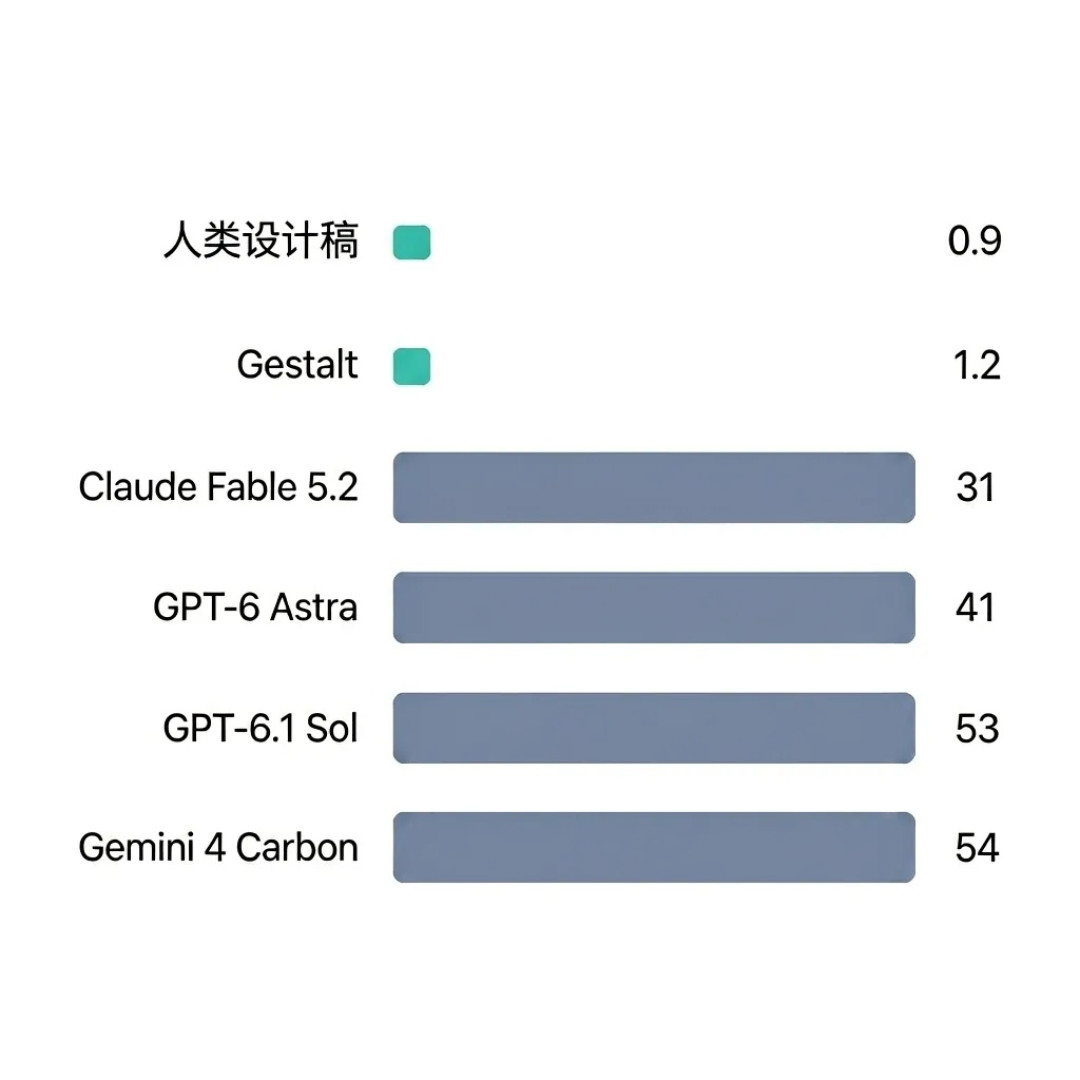
真正拉开差距的,是榜单自带的「AI 味」检测:0 到 100 分,越高越像 AI 生成。人类参考稿 0.9,Gestalt 约 1,Claude 系 31 到 38,GPT 系 41 到 53,Gemini 系 54 到 57——主流模型离人类差着一个量级,而 Gestalt 和人类参考几乎分不出。哔哩哔哩知乎
所谓 AI 套路,是那组似曾相识的视觉指纹:标题上方的小型大写微文案、01/02/03 编号版块、渐变滥用、卡片堆砌、玻璃拟态、超大圆角、纯黑深色模式、巨大居中的英雄区。技术拆解还转述基准团队的分析:绝大多数训练样本都带着同一套指纹。知乎
社区流传较广的一种解读是:主流模型按组件局部拼装页面,每个零件单看合理,拼在一起就露出「机器口音」;Gestalt 在德文里就是「整体」,它赢在先建立全局关系、再落子局部——盲评里,消除 AI 痕迹比提升任何单项设计维度都更有杀伤力。这是解读而非官方说明,Contra 没有公布它的任何技术细节。
没赢什么:检查表差 1 分,产出不可见,成本是谜
设计规范检查表是另一把尺子,覆盖色彩、字体、布局、可用性以及对任务要求的遵循程度。这项上 Gestalt 得 83 分,Claude Fable 5.2 和 Claude Opus 5.5 都到了 84。逐项抠规范,Claude 仍然更严丝合缝;评测方同时报告,检查表与设计师盲评的相关性达到 0.94——机器判断和人的判断基本一致,两套结论的分歧本身才值得琢磨。知乎知乎知乎
更实质的短板在可验证性。公开画廊只展示有名字模型的产出,Gestalt 的项目不在其中,读者无法知道评审究竟看到了什么;与人类金标 28 次对决的样本量也偏小,评委又来自与 Contra 网络关联的封闭组。榜单由自己经营设计师接活市场的 Contra 主办,X 上的读者已给原帖加注「没有独立核实」,评测方与受益方存在结构性重合。知乎哔哩哔哩
成本同样是谜:有拆解保守估算 Fable 5.2 每做一个网站的成本约 127.22 美元,Gestalt 没有任何对应数据点,无法判断它的领先来自更聪明的路径,还是不计代价的推理开销。知乎
它也只出现在这一个榜上:这是设计垂类基准,不构成通用能力排名。客户临时改目标、上线后发现用户找不到入口、团队要把新页面维护两年,这些都得另看。哔哩哔哩知乎
它是谁:所有猜测目前都没有官方确认
Contra 官网对它的描述只有一句:一个还在隐身中的高质量设计模型。中文圈有帖子说是国产,被问出处只回「外网透露了」;有人声称破案,指向一家 2024 年成立、位于旧金山的 AI 界面设计公司。也有人猜是 OpenAI 藏在暗处的王牌、Google 憋的大招、专做前端与审美的黑马创业团队,又或者是 Anthropic 自己的「马甲小号」。这些猜测没有任何官方确认,只能按传闻处理;至于榜单发布与 Anthropic 上市前后脚发生,那位UP主的原话是两者之间没有任何公开关联,「精准狙击」的剧本不能当成事实。哔哩哔哩知乎知乎哔哩哔哩
接下来值得盯三个信号:开发方何时认领并开放接口,让普通人能拿真实 brief 亲自改它一轮稿;产出画廊是否会公开;成本数据能不能浮出水面。在那之前,1931 是一个需要认真对待、但同样需要认真怀疑的数据点。它证明了匿名模型能在专业盲评里赢过人类和所有旗舰模型,却没有证明任何一家厂商的设计护城河已经失效。知乎

当前文章无评论,是时候发表评论了