

11月20日,OpenAI发布《Combatting adversarial distillation》报告,第一次把反蒸馏工作完整摊开,也给出了核心数字:在内部自适应黑盒红队评测中,提取“模型回答先前问题时写下的受保护推理”的平均攻击成功率,从GPT-6 Astra旧防护下的54.0%降到GPT-6.2 Astra新防护下的0.2%,提取本轮问题推理的成功率则从22.9%降至0.9%。0.2%不等于蒸馏被彻底终结,它衡量的是“模型的内心独白”能否被偷走;这条防线真正的赌注,在于独白为什么值得偷。OpenAI官网IT之家
模型解题时的“草稿纸”,凭什么值得大动干戈
蒸馏本身是普通的机器学习手段:一个模型用另一个模型产出的数据来学习,学的内容可以是答案、推理,也可以是关于哪种回答更好的判断。OpenAI官网
OpenAI把模型内部解题时实际生成的中间步骤称为“受保护推理”,也就是常说的思维链,而这些痕迹里保存着最终答案没有留下的信息。这正是它们对训练另一个模型格外值钱的原因。OpenAI官网
OpenAI为此做了对照实验:从同一个预训练学生模型出发,以用户平时可见的最终回答、推理摘要和工具交互记录为基线,一组额外拿到教师模型的精确推理痕迹。微调后,精确痕迹组普遍领先;经过一轮轻量强化学习,在最大推理预算下,它仍会在两个网络安全基准上得分更高,只有预算收紧时,学摘要的一组才反超。OpenAI官网
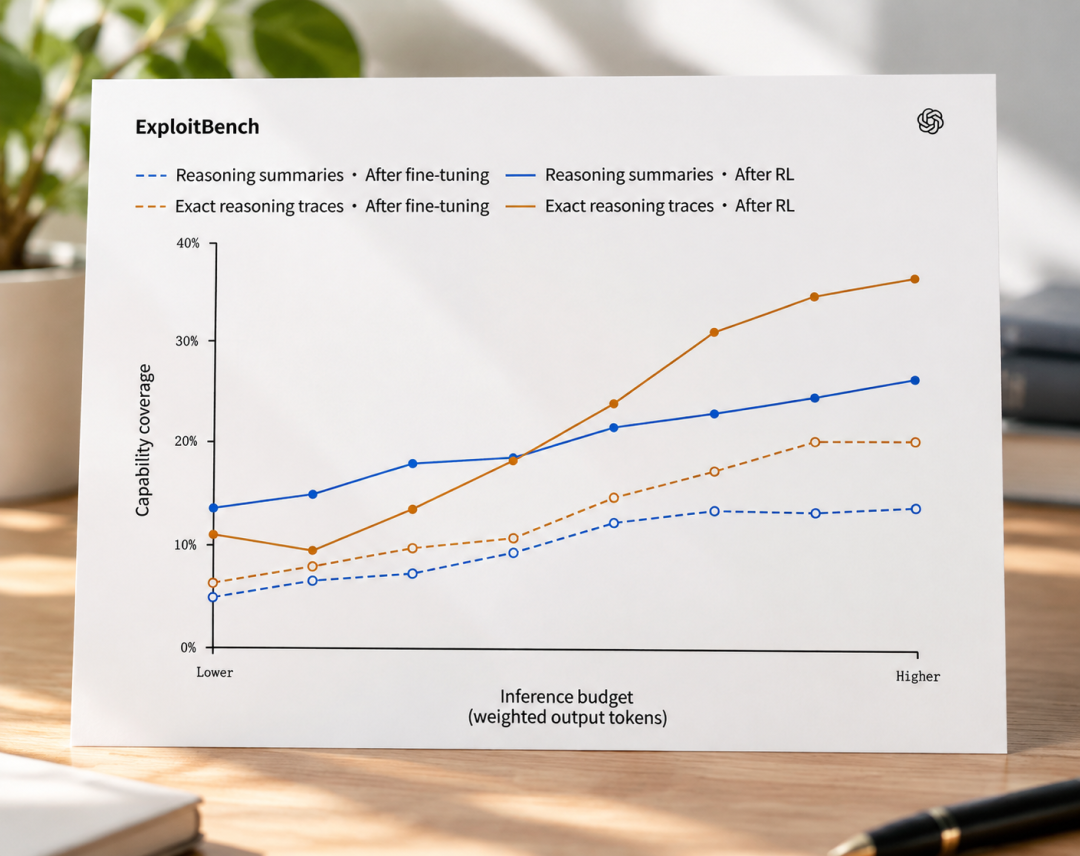
这组实验更值得警惕的含义是:即便教师模型做的全是合规的防御性任务,学生也可能学出适用于攻击性网络安全任务的通用技能。OpenAI官网
防线不是一把锁,而是一组咬合的齿轮
第一道在模型行为上:对抗训练让模型学会识别索取推理的提取尝试并拒绝披露,同时保留对正当解释请求的回应能力。OpenAI官网
第二道在分类器:输入侧识别提取请求,输出侧同时检查可见回复和工具调用参数里的泄露,流式与非流式响应都在覆盖范围内。这条路线必须单独堵住,因为模型有时会把推理写进工具参数,而不是最终答案。OpenAI官网
第三道是开发者感知最直接的一道。GPT-6.2 Astra和Sol把受保护推理绑定到产生它的对话历史上,只有沿原历史继续追加消息,此前的推理才能接着被利用;改写前序消息之后,其后的推理即告作废,靠反复编辑提示词“挤”思维链的玩法失效。OpenAI官网新智元
第四道是隔离:防护较弱的旧模型族被禁止读取新模型的受保护推理,9月披露过的加密推理跨会话复用路径也已封闭。OpenAI官网
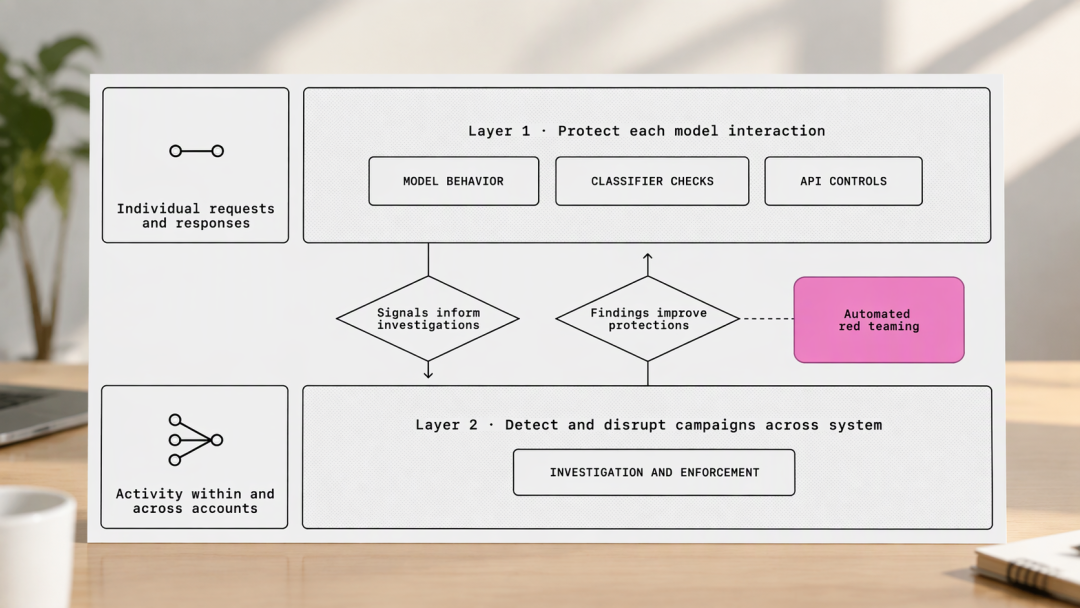
活动层面:按账号网络“连锅端”,并向同行共享线索
请求级防线之外,OpenAI承认今年平台内出现过多次未经授权的蒸馏活动,每周执法封禁规模从数千到数万个账号,自今年夏天起明显提速。OpenAI官网知乎
OpenAI同时把攻击指标与其他模型厂商共享,以便对方排查自家服务上的关联滥用。OpenAI官网
这也不是OpenAI一家的动作:9月10日,Anthropic已发布一份154页报告,称识别并阻断了7家中国AI实验室针对Claude的大规模蒸馏。晚点LatePost
数字够不着的地方,才是最容易读错的地方
先看口径:0.2%与0.9%来自OpenAI内部自动红队的自适应黑盒评测,是跨6个攻击模型汇总的攻击成功率,属于自报数据,外部暂无法复算。OpenAI官网
公司同时表示,正把部分防护改进应用回GPT-6 Astra。OpenAI官网
再看边界:这套防护只锁“受保护推理”,而OpenAI自己做实验时,就是以最终回答、推理摘要和工具交互这些用户可见内容为基线,它们已经足以教会学生相当多的东西。OpenAI官网
至于“今天训练一个能力相近的模型要花多少钱”,报告没有报价,OpenAI自陈的目标也更克制:限制蒸馏者能拿到的数据量与价值、抬高蒸馏活动成本、缩短响应时间。也就是说,反蒸馏的实际效果更接近让蒸馏变贵、变慢、变“没营养”,而不是把门关死。评测中“接近十个百分点”的差距只在最大推理预算下成立,直接拿它算收益会跳过最影响判断的一项条件。OpenAI官网知乎
接下来盯什么
OpenAI把反蒸馏同时推向了政策场。今年2月,该公司曾向国会简报相关活动迹象,显示DeepSeek在尝试蒸馏美国前沿模型。OpenAI官网
9月,OpenAI又报告瓦解过一次针对受保护推理的提取活动,并把其核心部分归因于Kimi开发商Moonshot AI的相关人员。OpenAI官网
本次报告则明确支持Chip Security Act、AI OVERWATCH Act与MATCH Act三项法案。OpenAI官网
OpenAI同时预告,将披露更多被瓦解的蒸馏活动。对普通用户和开发者,值得观察的是两个信号:每周封号规模是否继续攀升,以及API“编辑后重发作废推理”的行为变化是否会外溢到日常用法。OpenAI官网


当前文章无评论,是时候发表评论了