这两天,玩本地AI的人集体感觉被冒犯了。
10月29日的播客Cheeky Pint里,OpenAI CEO山姆·奥特曼抛出一个暴论:把世界上有限供应的内存一大堆塞进个人电脑,却只用到5%的时间,从全球资源分配角度看"相当糟糕",而在供应极度紧张的环境下,内存应该集中放到云端,把利用率拉满。这番话10月31日在微博炸锅,#山姆奥特曼称内存应放云端#话题下吵成一片。微博经理人杂志微博
最扎心的不是观点,是时机。
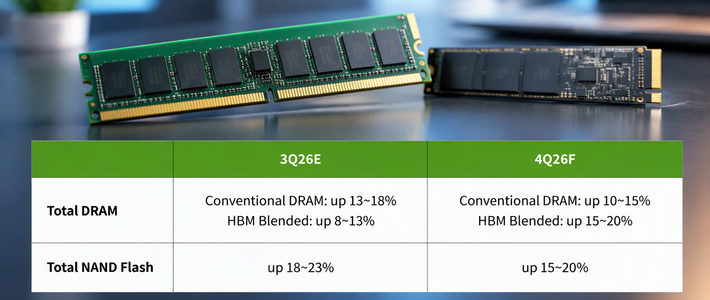
内存价格正在起飞。日本秋叶原PC热线10月中下旬的价格调查显示,主流DDR5台式机内存三个月涨了超过62%;海盗船DDR5-6000 128GB套装在日本已卖到514800日元(约3200美元),一年前同款只要59800日元,一年涨了761%。连上代DDR4都跟涨了24%。原因不难猜:三星、SK海力士、美光这三家握着全球95%以上产能的巨头,把晶圆产能成片切给了AI数据中心抢着要的HBM和服务器内存,消费级内存成了被牺牲的那个。而且这种紧张短期还解不开,三星电子在三季度业绩会上说,供应紧张状况预计持续到2028年。知乎经理人杂志
所以奥特曼这句"本地别占着内存",落在装机党耳朵里就变了味:你抢破头想买的资源,本来就不该买,交出来给我的数据中心用。难怪微博上点赞最高的回怼阴阳味十足:“所以,你买不起 GPU、内存和硬盘,是因为山姆奥特曼觉得让 DRAM 闲置在你的电脑里是件相当糟糕的事”。微博
那他说得对不对?其实两边各对一半。
先说该怼的那半。"95%闲置"说的是平均水平的办公电脑,不是你家里那台跑模型的机器。推理分prefill和decode两步,每吐一个token都要把权重和KV cache反复读一遍,跑起来时内存的容量和带宽是实打实在被吃的。何况奥特曼的屁股坐在云端——OpenAI卖的就是算力,这话他天然有立场讲。Reddit的r/LocalLLaMA版块里,点赞最高的反驳是个绝妙类比:汽车九成的时间停在车位上,也没见谁因此劝你别买车。微博知乎
再说不好反驳的那半:对多数个人用户,本地部署真省不回API的钱。知乎上有人算过一笔账:DeepSeek的API输出高峰价每百万token只要8块、空闲价4块;一台一万五的本地机器按每秒30个token跑,出一百万token要九个多小时,电费三块多,按高峰价算每百万token省不到5块,机器钱得连跑三万个钟头才回得了本。这还没算内存涨价把整机成本又抬高了一截,以及新模型层出不穷、旧硬件不断贬值。知乎
所以这阵子想装机的,给三句实在话。
第一,别为"省钱"囤内存。现在渠道商捂货惜售、囤积库存,人为放大了短缺预期,价格还在正反馈式上冲,追高容易被挂在山顶。真干活缺内存就按需买,纯焦虑就别出手。知乎
第二,想清楚自己本地部署的真实理由。数据不能出内网、要把模型版本钉死、要断网可用、要隐私——这些需求是真的,就继续花钱,涨价也值;如果只是觉得"付API费亏了",那API确实更便宜,认了吧。
第三,内存逆风期,MoE小激活模型是救命稻草。35B级的MoE模型量化后,已有实测在8GB显存上稳跑30 token/s出头。普通内存涨归涨,还没到逼你抢128GB旗舰套装的地步。哔哩哔哩
奥特曼算的是全球资源账,你算的是自己钱包账。两个账都没错,但别让他替你算钱包。