烧额度的锅,这次模型厂商自己认了。Kimi K3.1 Pro的用户十几分钟烧完5小时额度,Kimi公开道歉、补偿额度,并承诺减少不必要的子Agent调用。Anthropic也在同一时间,用一篇博客和工程师的公开分享把话挑明:额度烧穿,多数时候不是你用得狠,是模型把token花在了你没要求的地方。中国企业家杂志字母AI
三件事都发生在这个10月。Claude Code删掉了超过80%的系统提示词。Anthropic发博客说,一个带技能的单Agent,质量反超一群子Agent,token还省得多。机器之心字母AI
这三件事拼起来,是一份写给开发者的用法更新通知。
子Agent才是额度黑洞
Anthropic测算,多Agent系统的token消耗约是普通对话的15倍。这笔钱不是花在“想”上,是花在“记”上:每个子Agent都要重建身份、规则和工具清单,跑完再压缩成摘要交回去,主Agent得反复读同一份材料。字母AI
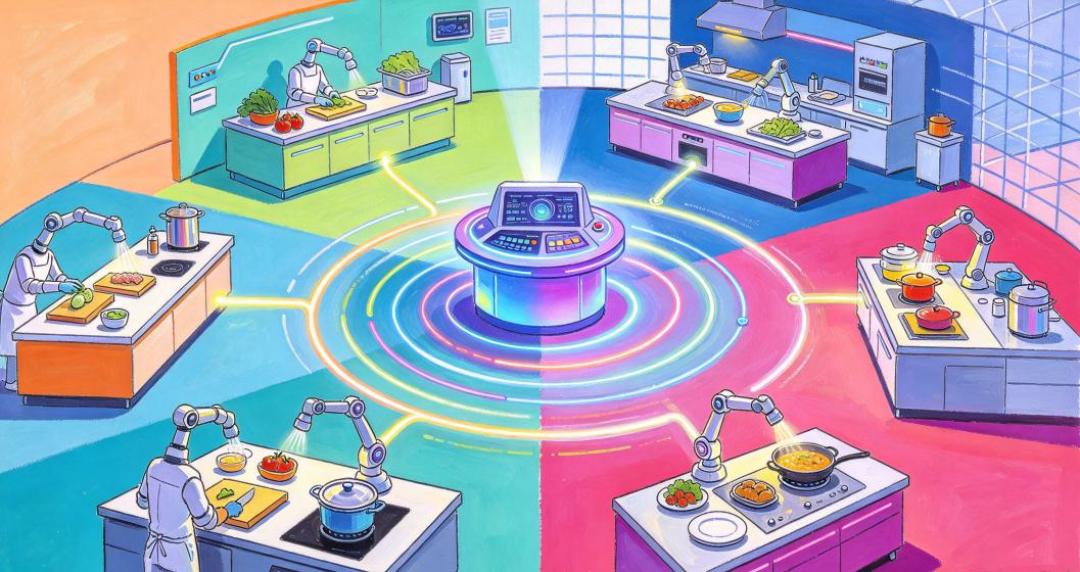
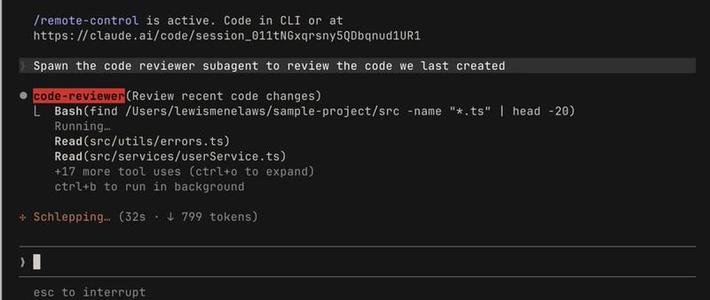
Kimi的用户已经替你验证过了:一句“审查项目架构”,模型拉起5个子Agent,十几分钟烧完5小时额度。还有一份token层面的对比:同一任务,K3.1 Pro消耗约144万token,上一代K3只要61万,官方33%的降价被轻松吃掉。中国企业家杂志
结论很直接:绝大多数任务,单Agent、单循环就够。 子Agent只留给全面审查、大规模代码迁移这类值得并行的大任务。小任务硬拆,只多花钱和等待。
提示词是负债,不是资产
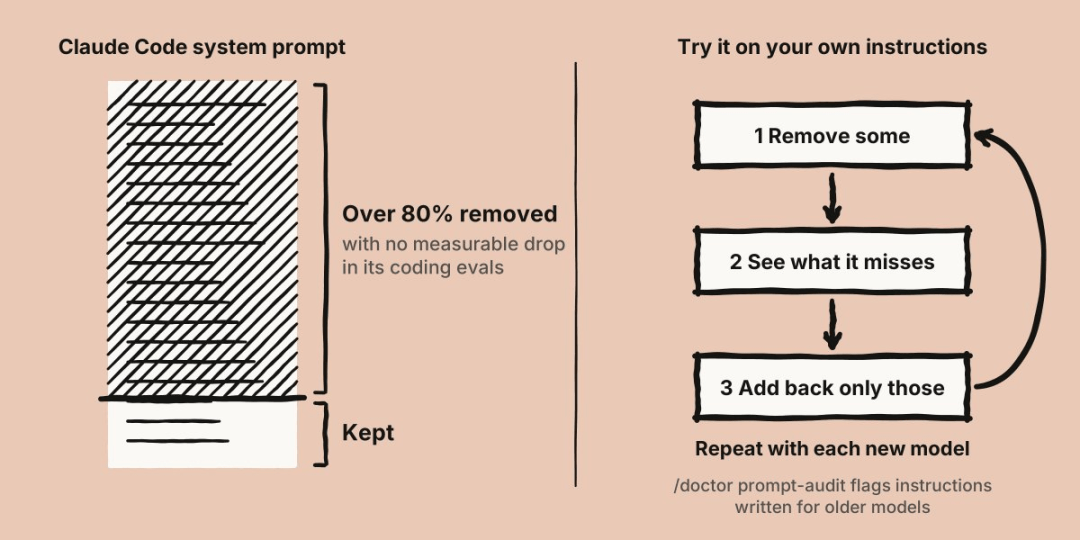
这有实锤:Claude Code把系统提示词删掉八成,编程评测表现没有可测量的下降。Claude工程负责人Felix说得更狠——一个好skill的半衰期非常短,有时删掉skill,输出反而更好。机器之心后浪进化星球
道理不难懂:提示词和skill本质上是同一类东西,都是预先写给模型的规则。那些规则是写给旧模型的,现在模型自己会安排,它们就成了噪音,还占着上下文。提示词越长,不代表你越会用AI,可能只是把犹豫写成了流程图。
具体动作:用`/doctor prompt-audit`找出针对旧模型的指令,先删一部分,看模型漏了什么再补回来。留两类就够:目标与边界,以及可执行的验收标准——能跑的检查、通过或不通过的判断、明确的数值目标。让模型自己知道“做没做对”,它才能少问你、少跑偏。机器之心
你的新工作是验收,不是指挥
Felix说自己现在几乎不写代码,大多数时候在做原型设计。Anthropic一个没有Rust经验的小组,靠Claude完成核心API跨语言重构,CPU省40%、延迟降20%,人只负责架构、迁移策略和验证。后浪进化星球极客邦科技InfoQ
人留在手里的就三样:架构、策略、验证。团队用影子流量让新旧实现处理同样的请求、逐项对比输出,确认能替代旧系统才敢切流量。极客邦科技InfoQ
落到日常,就是几个围绕验收的动作。模型汇报完成时,让它展示执行过的命令和输出,别只看结论。机器之心
代码审查先让Claude本身跑一轮,用`/code-review`派一个没看过对话的子Agent专挑毛病——这和“少用子Agent”不冲突,这里的子Agent买的是独立视角,不是并行分工。Claude Code团队里,多数改动都先由Claude至少审查并修正一次,再交人工。没想清楚需求,就先让它连环提问写出需求说明,再照单干活。机器之心
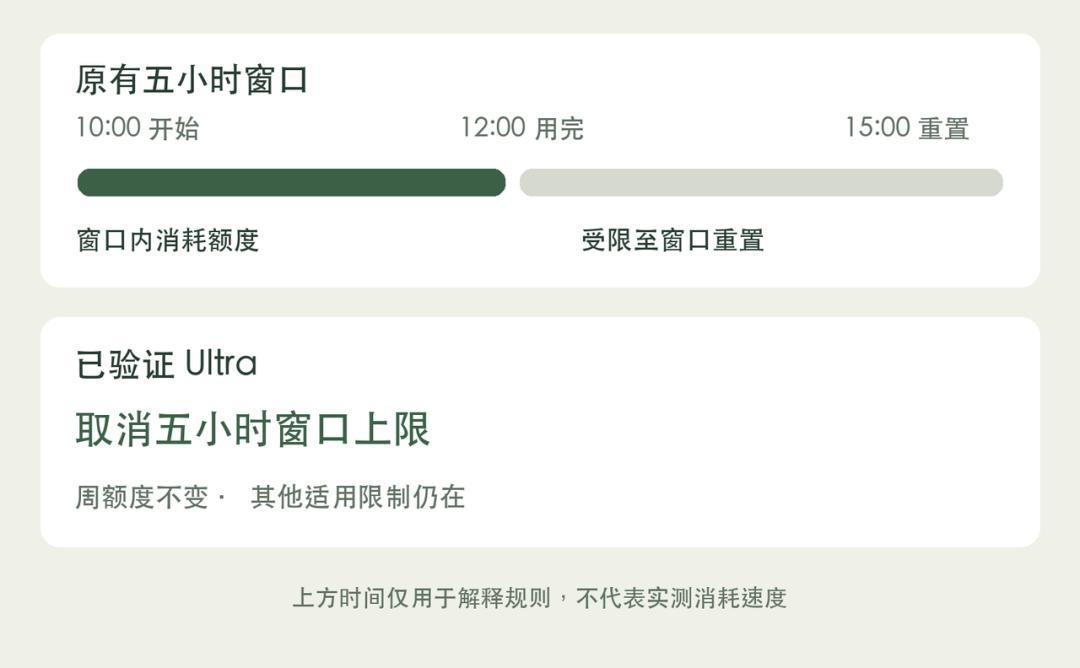
顺带一提,Anthropic刚对认证的Ultra账户取消了5小时用量限制。跑多久,Anthropic不再管了;跑得对不对,彻底归你。新智元
一句话:把“怎么干”还给模型,把“干没干对”攥在自己手里。 这可能是这个10月,开发者最值得更新的一套用法。