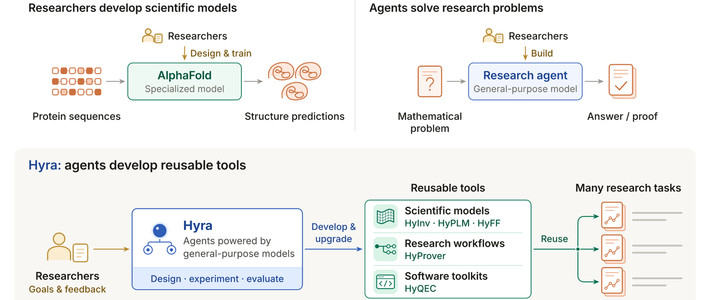
11月2日,腾讯混元发布科研智能体Hyra 2.0,官方把目标从「解题」换成「造工具」:让通用agent参与科学模型、工作流与软件工具的研发和升级,让一次研发的成果在后续研究中被反复使用。对普通AI研究者来说,它要省的并不是「想题」本身,而是每道题前后那些重复劳动——同一个实验室换了课题,团队还得重新搭环境、重新试错、把上一轮的隐性经验再走一遍。 Hyra 2.0这代产品,正是按这些重复动作逐项拆解分工的。IT之家知乎知乎
训练一个模型动辄几天到几周,过去这段时间里人得盯着任务、协调算力、在几条研究线之间来回同步。Hyra 2.0把研究工作拆成Overall、Mission、Worker三层:Overall对接人类研究者、管项目优先级与资源,Mission长期负责一个研究问题的路线与取舍,Worker负责读代码、做实验、分析失败。 撑住分工的是几个直接对着痛点的工程件:任务进持久化队列,等训练结果或等人工审批时其他任务照跑,agent还能设定下次唤醒时间;并行研究线的进展写进Research Board,常规更新异步阅读,必须处理的问题才发消息;Worker报告完成必须附代码版本、实验结果、日志或原始运行轨迹,需要时另起一个先只接触原始问题与证据的Review Worker独立复核;可复用的经验沉进共享知识库Books,之后再变成skills供后续任务调用。这套系统接的是企业微信、计算平台、代码仓库这些真实研发环境,agent找人类批算力走的就是现有工作流,不是演示沙盒。 而涉及较大算力开销和共享知识同步的操作,仍要人工审批。知乎知乎微博
Hyra 1.0发布于今年7月21日,是一个能递归自我改进、面向性能导向研究与工程任务的智能体。 7月31日,混元官方宣布它把加法组合学中一个悬置约50年的开放问题推进到了新结果,约24小时自主运行找到核心思路,研究团队再独立核验、补出Lean 4形式化证明。 但解题的产物是一篇论文,论文不会让下一道题更容易——就像一份手写的答案,没法import。官方的对比很朴素:解题的成果不会自动提升下一次研究的能力;升级一件工具,所有用到它的下游任务都会受益。 工具分两类:符号化的(代码、规则、流程、验证程序)改「怎么做」,参数化的(把规律训练进权重的模型)改「会不会」。官方主视觉里列出的成果正是五件可复用工具:科学模型HyInv、HyPLM、HyFF,研究工作流HyProver,软件工具链HyQEC。IT之家量子位知乎
对做蛋白相关研究的人,Hyra 2.0从头训练的HyInv只有196万参数,官方称它按目标骨架设计蛋白质序列的速度比常用工具ProteinMPNN快57倍。 量子方向,官方称HyQEC构造的[488,123,22]码在非CSS、校验权重不超过8的条件下,比qLDPC Challenge原榜首的编码效率提升约48%。 它也参与了开源RISC-V处理器「香山」的性能调优。需要说明口径:这些数字全部来自腾讯官方披露,暂无第三方独立复验。普通研究者现在真正拿得到的,是结果这一层:HyPLM-Flash的权重和技术报告已经公开,成果会持续放进GitHub仓库供社区检验、复用。知乎知乎
工具本身开源,工具厂没有。Hyra 2.0的这套Harness是混元内部系统;社区7月对Hyra 1.0做的复现OpenHyra,明确写着它不是完整系统的复现,只聚焦一个具体数学任务。 所以对普通研究者,眼下能省的是「用成果+抄思路」,而不是「把自己实验室挂上去跑」。它的边界也写得很清楚:Hyra 2.0不是全自动科学家,而是一个能自己推进、但在关键路口会停下来问人的研究团队——大算力、共享知识同步都要人拍板。 上一代的数学纪录在社区里还挨过「泡沫营销」的质疑,这一代的成果同样要等同行复验;「一次研发、反复使用」能不能兑现,观察信号是GitHub仓库的更新和后续任务对这批工具的复用。至于真正能立刻迁移到个人工作流的,其实是那句最朴素的对比:别再把一次性劳动存成「答案文本」,存成资产——脚本写成库,隐性经验沉淀成可复用的skill,下一个项目才有一个更高的起点。知乎知乎