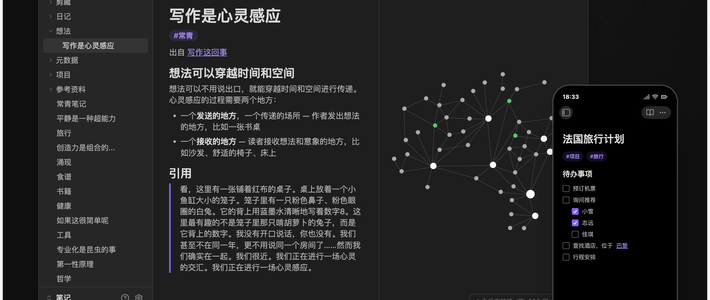
9月下旬,"第二大脑"圈子里出现了一个很诡异的时间差:一边,全网还在批量生产"20分钟搭好AI第二大脑"的教程;另一边,4月入坑的第一批人已经开始晒复盘——库里1871篇笔记,其中1330篇是抓下来没读过的文章。
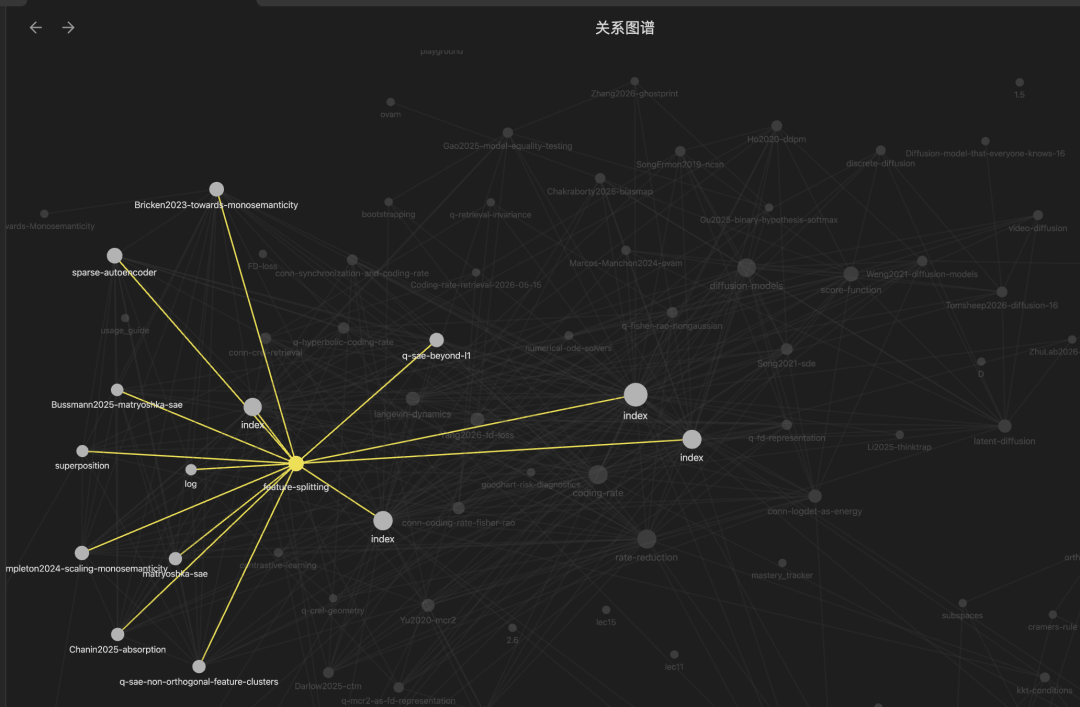
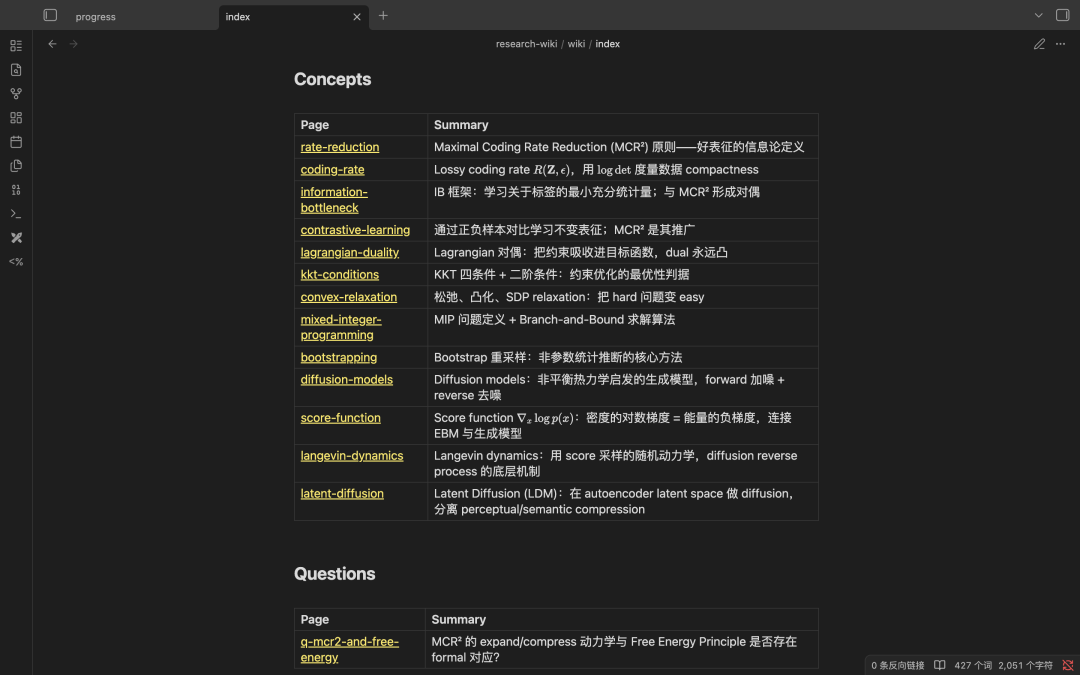
9月22日,知乎用户"童虎"发了一篇用了几个月Obsidian的结账帖:库里1871篇笔记,90多篇微信读书划线,剩下1330篇是用工具从X上整篇抓回来的博主文章。他自己承认,关系图谱"情绪价值大于实用价值",要说挖出了什么隐藏知识关联,“我当前还没发现”。真正派上用场的只有一件事:三个月前看过的某篇文章,一秒能翻出来。这条复盘比教程值钱得多,因为它第一次公开了这波AI第二大脑建设的初期账单。知乎
这波有多热:收藏数是点赞数两倍
先看盘子有多大。4月11日,小红书博主"数字游牧人"发了一条"搭建全网千万收藏的AI第二大脑,3分钟教你",拿到9690个赞、19201个收藏;B站同题材那条11142赞、12662藏。在这个品类里,点赞是路过,收藏才是打算动手——收藏数接近点赞数的两倍,是这波教程独有的曲线。小红书哔哩哔哩
方法本身不新,就是海外AI研究者Karpathy晒过的那条路线,被B站UP主总结成"把看的视频、读的文章、写的日记统统扔进Obsidian,让Codex当管家"。从5月到9月,Codex+Obsidian教程在知乎、B站、小红书霸屏,单条收藏普遍上千;9月19日小红书还有新的"我给WorkBuddy装了个第二大脑"在涨收藏,687赞1590藏。哔哩哔哩小红书
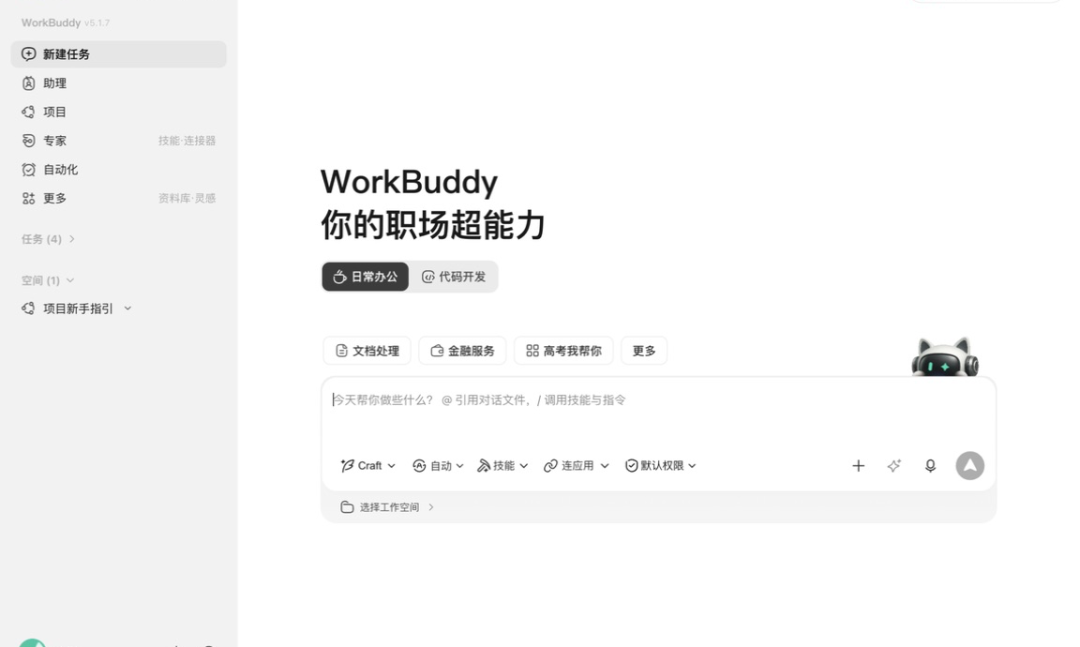
9月的新变量是腾讯WorkBuddy。知乎从9月初开始密集讨论这条路线:能绑定微信远程下任务,也能挂知识库,直接成了Codex、Claude Code之外的第三条路。评论同样两极:有人夸方便,有人吐槽一个i5+16G的老电脑能被它吃掉大半CPU和内存。知乎知乎
评论区另一面:第二工作、颅内空空
在B站那条1.2万收藏的教程下面,756赞的最高热评只有一句话:“我就是干这个的,只能说除非你是个博物学家,否则构建个人知识库的工作量将成为你的第二工作”。第二名205赞更损:“ai第二大脑:❌;颅内空空如也的可视化:✓。”哔哩哔哩
小红书那条2453赞的"之前我一直不相信第二大脑这件事"底下,463赞热评聊的是隐私——那是一篇讲AI硬件Looki的帖子,32克的小玩意挂在胸前每分钟自动录5秒,评论区第一反应是"都不知道它到底看到了什么"。社区的反证信号已经很密:不是方法没用,是很多人建完发现,库里躺着的是仓库,不是大脑。为什么?小红书
对着复盘帖,死法有三种
把几个月来的翻车帖放在一起对,死亡集中在三个地方。
死法一:只进不消化,仓库化。 教程都教你"扔进去",没人教你"扔进去的东西凭什么算知识"。童虎的1330篇未读就是样本。小红书那条1180赞、1862藏的帖子说得更直白:“收藏得越多,真正能用上的内容反而越少”。小红书
死法二:把判断力外包。 知乎《AI时代重谈第二大脑:你建的到底是大脑还是仓库》里有句话很狠:如果你自己没有结构化的知识体系,AI就像一个能言善辩的图书管理员,图书馆里的书却是你随便扔进去的,它给你一个听上去合理的答案,你连对错都判断不了——“这不是第二大脑,这是外包判断力”。知乎
死法三:维护成本超出预期。 “20分钟搭建"说的是演示视频;新手踩坑帖的实录是,两天下来大家还在挨个解决装软件、配API的问题:装GPT客户端、装Obsidian、配第三方API,挂代理还大概率报502,插件装了十几个最后留不下几个。钱账也不便宜:想直接用Codex得开20美元/月的订阅,WorkBuddy不收费但吃本地资源,卖课的群里58块就能进门——单独看都不贵,加上时间就是"花钱给自己买了个第二工作”。知乎
活下来的人,长得不一样
同一批人里还在用下来的,形态出奇一致,而且分界线不是工具。
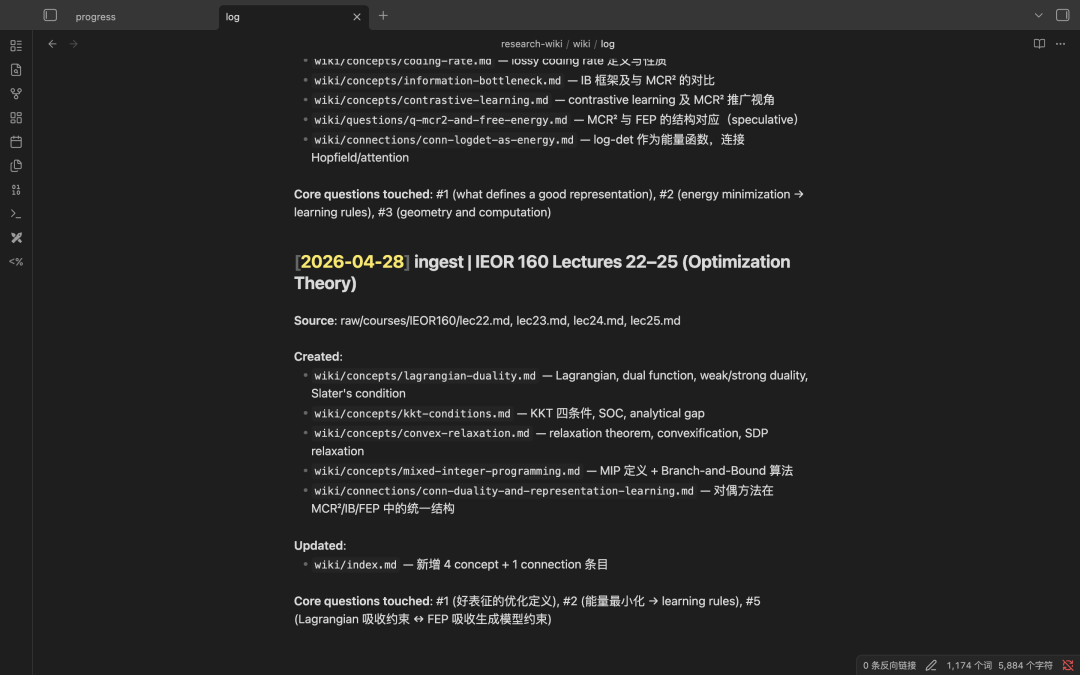
不求"库替你长知识",只求它参与干活。 知乎用户liujg的检验标准一句话:知识库是否有价值,不看节点数量,看它是否参与真实工作——写任何东西之前,先查自己的库。知乎
人和机器的分工反过来了。 知乎用户钟天炜9月5日的标题很行为艺术:“我用Obsidian做知识库,但从来不看它一眼”。Obsidian退居后台当仓库,"看"这件事交给Codex去做。知乎
事实源要可审计。 B站9月20日新出的工程向视频《别把向量库当第二大脑》给了一套原则:事实留在本地Markdown,BM25和向量索引随时可重建,Git记录每次修改,“AI负责发现关联,人保留最终判断”。这和童虎选Obsidian的理由是同一件事:都是本地纯文本,数据在自己手里。哔哩哔哩
最值钱的是你自己写的,不是抓来的。 童虎原话:自己写的读书笔记、工作复盘"量不多,但最值钱"。小红书9月那条1422赞、1875藏的科研库分享(Jike Sol),也是拿AI逐篇消化研究方向的上百篇文献,不是整库抓取互联网。
你到底值不值得搭:按人群分
只想偶尔查点东西:别搭。 热评里那个疑问是成立的——"自己搞的知识库还能比互联网大不成?"联网搜索+平台收藏解决不了的问题,知识库也解决不了。
有明确的输出物(写稿、科研、课程、教培、自媒体):值得搭,但请从一个项目开始。 知乎那篇万字长文是把10年教培增长经验喂成一个可调用大脑;Jike Sol是消化一个方向的文献。他们的库都有明确服务对象,而不是先"把人生搬进去"。知乎
想让AI记住你、不用每次从头解释:这是当前最值的一档,也是WorkBuddy们抢的方向。 但从小处起手:几份个人背景卡+一个项目的资料,先跑通,再谈全部身家。
对折腾、隐私、订阅账单敏感:硬件和付费订阅路线先缓一缓,用本地Markdown+便宜API跑一个月,在$20扣款之前止损。
最后给自己设一个三个月的检验信号:三个月后库里只有摄入没有调用,那就是仓库,停止抓取、开始消化;"自己写"的笔记在肉眼可见地变多,这笔钱和时间就花对了。
"第二大脑"这个说法被蒂亚戈·福特整理成方法论时,四步CODE的终点从来不是存储,而是表达。现在AI把捕获、组织、提炼都替人干了,唯独替代不了第四步——这也正是同一套教程下,一半人建的是仓库、一半人建的是大脑的全部原因:存进去的是东西,判断过的才是大脑。