先说时间线:9月17日,中国电信旗下的中电信人工智能科技有限公司把星辰大模型最新一代 Xing4.0-29B-A4B 全面开源,权重同时上了 GitHub、Hugging Face、Gitee、魔搭、魔乐五个社区。9月19日晚,国产GPU厂商沐曦宣布曦云C系列完成"发布即适配"的 Day-0 适配。这个星期(9月23日—25日)正在北京举办的中国国际信息通信展览会上,电信展台的主线也正是算力。知乎微博知乎
三件事叠在一周里发生,说明这不是"发个模型冲个榜",而是一条线在收口。对拿着游戏本、折腾过本地大模型的数码党来说,真正要回答的是三个问题:这次"国产卡训练"和以前的新闻有什么本质区别?一张3090"能跑"到底是营销话术还是真账?国庆七天,值不值得装一个?
一、先把旧账翻清楚:这次不是"用国产卡跑",是"用国产卡训"
过去两年,"国产算力跑大模型"的新闻基本都是推理侧:模型是别人家(英伟达卡)训好的,拿过来放到昇腾上服务。今年5月,科大讯飞高管还公开说过一句大实话:DeepSeek V4 的训练仍然是基于英伟达卡进行的,昇腾只做了推理适配。当时行业内的共识很扎心:推理替代是"能用别人的锅做饭",训练替代才是"自己能造锅"。训练对算子优化、集群调度、容错的要求比推理高一个数量级,任何一环掉链子,跑了几周的训练就崩给你看。知乎
这次星辰 Xing4.0 的看点恰恰在"血统":按官方口径,它是国内首个基于国产算力(昇腾910C)加国产框架(昇思MindSpore)完成训练的百亿参数级代码智能体大模型。据经济参考报报道,星辰大模型训练集群利用率做到 98%,训练效能达到国际主流同等算力的约 93%。横评文章给出的工程口径是,训练吞吐较开箱状态提升约 96%。作为铺垫,今年6月昇腾910C 已完成过 1.6 万亿参数模型的全参数后训练,验证了工业级流程。微博知乎知乎
一句话判断:"国产卡训不了大模型"这句行业心病,从 Xing4.0 开始不能再当默认前提用了。
二、参数表翻译成人话:为什么说"一张3090能跑"基本是真账
指标 | 数字 | 对你意味着什么 |
|---|---|---|
架构 | MoE,总参数29B,激活仅4B | 能力按总参数算,算力按激活算——推理负担接近一个4B小模型 |
专家结构 | 64个路由专家+1共享专家,每次激活4个 | 像64个专科医生坐班,每个问题只叫醒4个,电费按"4个人"收 |
上下文 | 原生256K,可扩展512K | 读得下一整本代码库/长合同,但长上下文明显吃显存 |
量化版本 | FP8、GGUF 同步放出 | 官方就替你把本地部署的活干了一半 |
本地门槛 | 量化后约15GB显存 | 24GB的3090/4070及以上舒服,16GB卡勉强,8GB卡别凑热闹 |
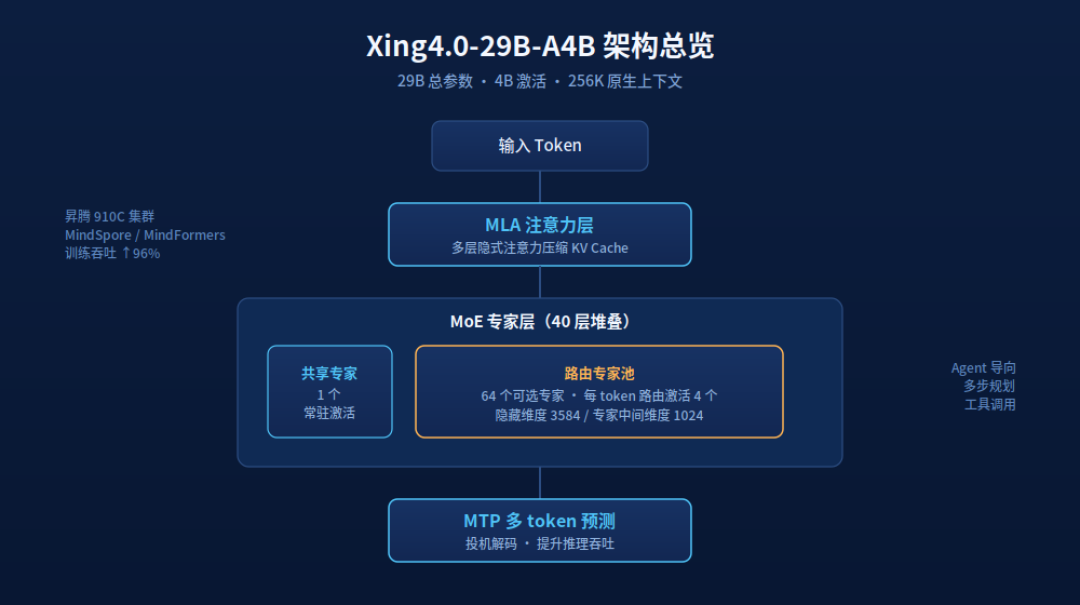
架构是 mHC+MLA+MTP 的主流配方,官方把它定位为“Agent导向架构”。它的预训练从4K上下文起步、中训练阶段逐步扩到256K,同时加入仓库级代码和 Agent 数据。按测评作者的说法,这模型从娘胎里就是按"会调工具的打工人"设计的,不是聊天玩具。它也是电信 TeleChat 系列的最新一代。知乎知乎
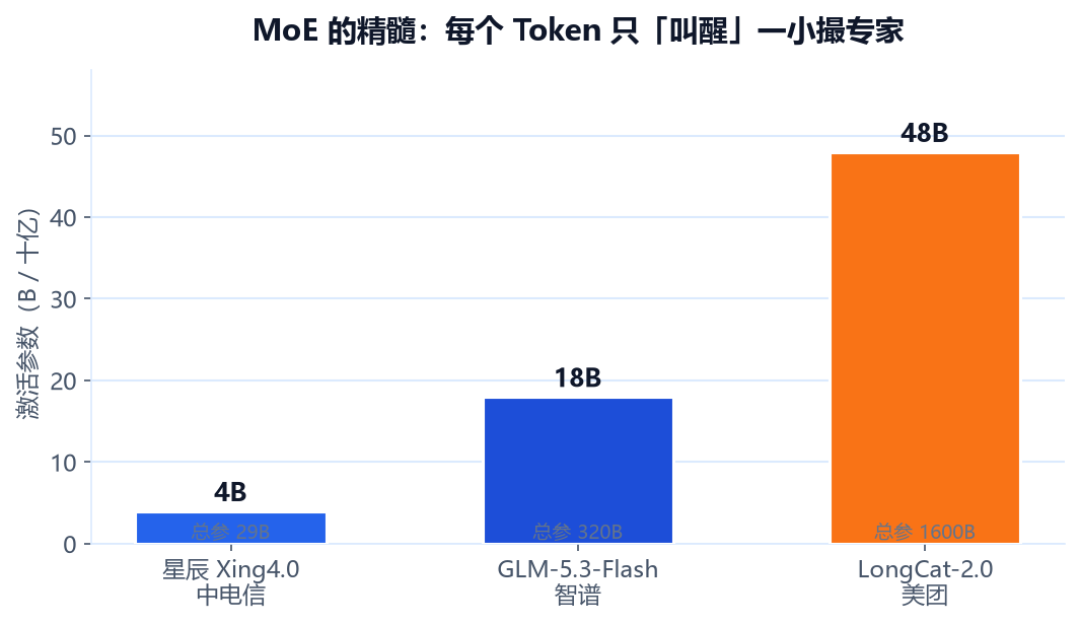
部署路径已经铺好:SGLang、vLLM、KTransformers 基本都能接,示例就一行 `sglang serve --model-path XingChen-AGI/Xing4.0-29B-A4B`。也就是说,"15GB显存+GGUF量化"这个组合拳下来,"一张3090就能跑"不是标题党,但它成立的前提是:你接受量化版、接受中短上下文,而不是一上来就拉满256K。知乎
三、活儿到底能不能交:榜单数字和一手实测要分开看
评测成绩:SWE-bench Verified 75.0、Terminal-Bench 2.1 57.5、AIME2026 90.0,官方对比对象是 Qwen3.6-35B-A3B 和 Gemma4-26B-A4B 这个档位。先泼一盆冷水:各家模型跑的基准不完全相同,这些分数不能跨模型直接排名次,横评文章的作者自己也标注了这一点。知乎知乎
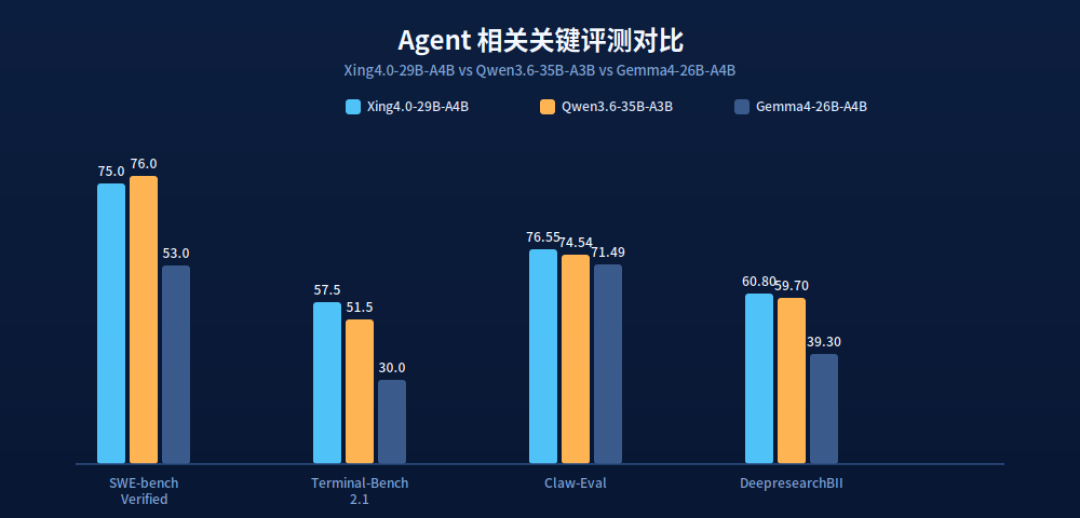
比跑分更有用的是实测。据知乎"杰克王聊AI"转述的"刘聪 NLP"一手评测:用本地营销数据生成经营分析,计算准确还找出了异常数据;修复一个中型 Python 项目的三个 bug,3分钟改完、自己跑回归测试全部通过,全程不用人插手。短板同样明确:内容整体把控和自我纠错弱于 Qwen3.8-27B,前端和3D生成不够惊艳。测评者的总结很克制也很准:“它不是一个惊艳的模型,是一个能每天干活的模型。”知乎
另一个值得记的生态信号是速度:模型发布当天沐曦就完成 Day-0 适配。国产算力圈的竞争,正在从"芯片参数"转向"算子库和新模型跟进速度"——沐曦、摩尔线程们的适配快慢,是观察这条生态成色的硬指标。微博
四、账要算三种:本地部署、Token套餐、云端API
走本地:适合数据敏感的人。接私活的设计师、怕资料上云的文案、医院/工厂/政企内网场景,"数据不出门"就是全部理由。成本是一次性的:量化版15GB显存,意味着手头有24GB游戏卡/旧卡升级的人基本零门槛,国庆七天就是现成的装机窗口。
走电信Token套餐:今年5月中国电信把此前上海试点的 Token 套餐推向全国,个人版最低 9.9元/1000万 Tokens/月,开发者及中小微企业版最低 39.9元/1500万,可调用星辰、DeepSeek V3.2、GLM5。轻度使用、不想折腾环境的人,这条路比装模型省事——先想清楚你缺的是"算力"还是"服务"。微博
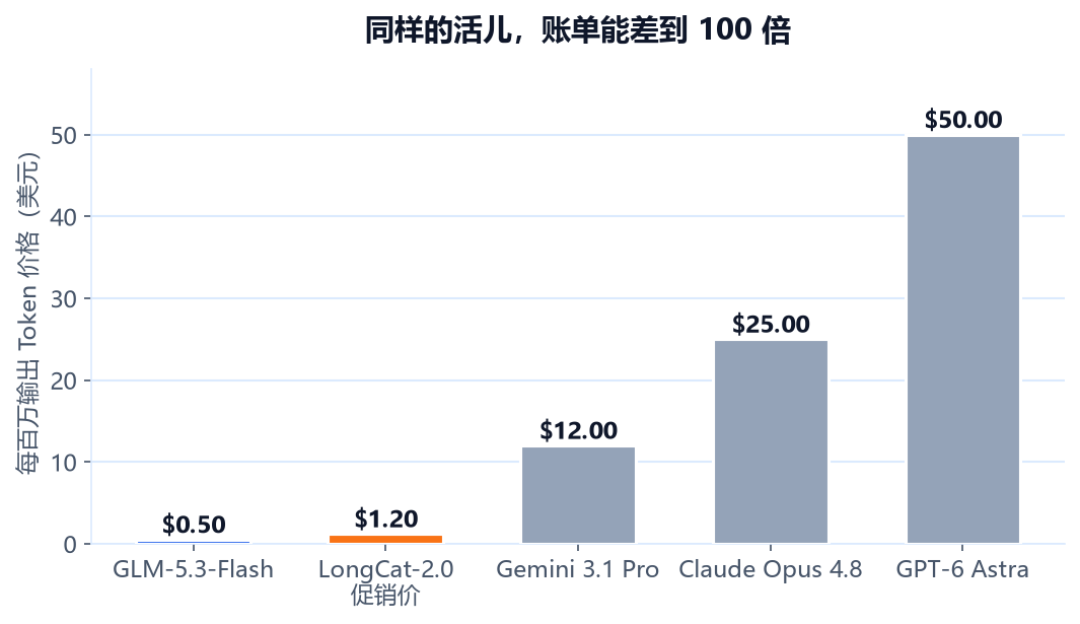
走云端API比价格:现在国产开源系的API定价已经把国际旗舰按在地上——GLM-5.3-Flash 输出价约 0.5美元/百万Token,而 Claude Opus 4.8 是 25美元、GPT-6 Astra 输出档 50美元。星辰走开源自部署路线,几乎没有API账单,但也没有现成的托管服务。知乎
路线 | 一次性成本 | 数据去向 | 适合谁 |
|---|---|---|---|
本地跑 Xing4.0 量化版 | 显卡已回本 ≈ 0 | 不出门 | 16GB+显存、代码/文档敏感、爱折腾 |
电信Token套餐 9.9元起 | 按月 | 交给电信 | 轻度AI办公、不想装环境 |
云端旗舰API | 按量 | 交给厂商 | 要最强能力、能接受云端 |
五、谁值得现在装,谁建议再等等
值得国庆动手的:有16GB以上显存N卡、最近半年折腾过 Ollama/LM Studio 的人——256K上下文+Agent工具调用,正好卡在你"想让本地模型替我干点真活"的甜点位;以及需要给公司内网演示私有化方案的 IT/开发者,30B级开源模型+全栈国产叙事,在采购桌上是有说服力的样本。
建议按兵不动的:需要图文视频多模态或百万级上下文的,看8月26日发布、GLM系列首个原生多模态的 GLM-5.3-Flash(1M上下文)。追 Agentic Coding 最强开源的,等美团 LongCat-2.0 权重开放(6月30日发布,1.6T参数,官方称开源在即)。没本地卡只想尝鲜的,9.9元 Token 套餐先试星辰本体,别急着买卡。知乎
避坑清单:①别拿不同基准的分数跨厂商排名;②第一代模型社区适配、微调生态还很薄,拿它对比 Qwen 全家桶的插件生态不现实;③量化版和全量版能力有折损,256K长上下文在本地会把显存账重新算爆;④评测样本来自少数博主一手帖,大规模口碑还得等这波国庆装机潮验证。
六、后面盯这几个信号
星辰下一版权重和 TeleChat 线的迭代节奏;移动、联通会不会跟进公布自己的"纯国产训练线"(政策红利窗口内谁先公布谁吃头啖汤);社区衍生微调模型的数量——开源模型的真正生命周期,从第三方开始改权重那天才算开始。
电信这份答案的行业意义,其实可以压缩成一句话:大模型的竞争,正在从"谁的模型最大"转向"谁的模型你能真正拥有"。而对普通数码党,这句话翻译成国庆期间的行动就是——显卡还在手边的话,这次可以不当旁观者。