这周本地AI圈子的吵架重心变了。前半个月全网还在对"哪张卡能跑125B"的门槛表,10月7日一早,B站AI日报把EmbeddingGemma 2开源和Gamma5、Gemini4曝料放在同一页播报,1.6万播放。 紧接着一天内,十几条实测、教程视频上线——装机党发现,真正卡住本地AI的已经不是推理,是检索:模型跑起来了,你自己的PDF、照片、录音,它一条都查不到。哔哩哔哩
先对清楚:EmbeddingGemma 2到底是什么、不是什么
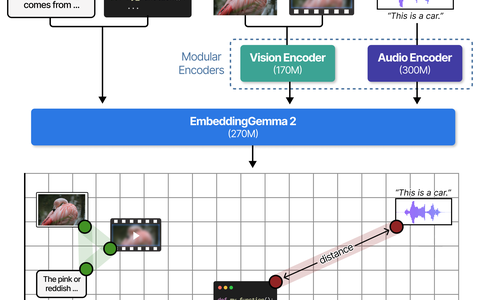
把社区视频里转述的官方口径和"UP主自己加的料"分开,能确认的事实是这几条:谷歌DeepMind开放了EmbeddingGemma 2权重,740M(7.4亿)参数、基于Gemma 4架构、Apache 2.0商用宽松许可,最适合设备端推理。 它把文字、代码、图像、视频、音频映射进同一个向量空间,可在本地硬件上统一处理文本、图像、音频与视频。 有UP主拿300张无标签动物照片做了裸演示:输入"会飞的动物",返回前9张全是蝙蝠。 视频上线一天,2760播放、201收藏,收藏数是点赞的近两倍,这个比例在B站科技区基本等于"观众想照着做"。哔哩哔哩知乎哔哩哔哩

但要划两道线:
第一,"量化后纯文本版在手机上只要约191MB内存"是转述IT之家的口径。 转述它的午报发布者也注明:Pixel11Pro内存数据为量化条件下的特定设备数据,非独立第三方复测。 当"人人手机可跑"传播的,目前只有这一个数字。IT之家哔哩哔哩
第二,已经出现"82.3%准确率、本地零账单"这种标题,视频播放量30。 没有复测榜单之前,精度类数字一律先当引流。哔哩哔哩
知识库党这周为什么集体动心
这个方向从来不是冷门:B站那套RAG知识库大课累计28.5万播放、1.1万收藏、1194条评论,标题里"手把手教你搭建私有知识库"就是流量密码。 小红书"手把手搭本地知识库"最高一条22682收藏,是点赞的1.76倍。 收藏/点赞比大于1的内容有个共同点——用户不是来看热闹的,是准备动手的。哔哩哔哩小红书
但需求侧的信号里扎着刺:小红书"有没有基于本地文件夹的知识库软件"那张贴409赞、144条评论,说的是大量工作报告、政策、通知、PPT全躺在本地,全部上传知识库也不合适。 知乎有人晒了3年的Obsidian仓库——3747个Markdown文件、4737万字符,作者自己承认这些笔记里大概80%我再也没打开过第二次。小红书知乎
另一根刺在效果侧:同一天上线的RAG评估视频开头就泼冷水——RAG找回了几十段资料,为什么答案还是可能跑偏? 知乎10月7日那篇问答方向的答案说得更直白:这东西真正决定效果的,不是模型有多大,是文档怎么切、用什么嵌入模型去检索。哔哩哔哩知乎

EmbeddingGemma 2开源之所以在这周炸,是因为它恰好补在第二根刺上:过去本地部署党要么花钱调云端向量接口,要么用社区老embedding模型对图片、录音完全没辙。现在"检索"这一环第一次有了大厂出品、能离线跑的开源件。
三笔账,对完再动手
第一笔:降维不是免费的,250MB是拿召回换的。768维可裁到128维,100万条向量约1.5GB变250MB。 这是目前教程里最诱人的数字——机械硬盘都嫌大的党狂喜。但同一个视频紧跟着写了代价:文本/代码类任务的检索质量会跟着维度一起缩。正确姿势不是全量重建,而是拿你文档里最难查的那一类(长表格、代码、专业术语混排)先用128维和768维各建一遍小索引,同一组问题两边对比,输多少你心里才有数。哔哩哔哩
第二笔:相似不等于正确,切分账比模型账大。官方演示里输入"Swing the bat"能返回挥拍画面,发布这期演示的作者自己也补了一句:正好提醒我们相似匹配不等于精确确认。 知识库翻车的多数姿势跟嵌入模型没关系,是文档切块切碎了表格、切断了上下文。至于"我27B都能跑262K上下文了,还要知识库吗"——本地部署教程确实把262K上下文当卖点在晒。 但262K是你的单次窗口,不是你的全部人生文件,3747个Markdown塞不进任何一个窗口;反过来也别学"全部上传"派,先把近一年真的会再查的东西挑进库,检索质量反而更高。哔哩哔哩哔哩哔哩
第三笔:换免费门票之前,先验一遍你的"本地"是不是假的。把向量接口换成本地模型之前,检查你现在用的桌面知识库软件到底把数据发去哪——知乎那篇问答特意提醒,也别信标题写着"本地"、结果数据偷偷走了云端接口的假离线。 这类问题上一波蜜罐测试已经实锤过不止一家。另外高敏材料可以看已经在跑的三步流:有律所公开本地AI三步脱敏流——私有化部署先做初步分析与智能脱敏,脱敏后文件再交云端大模型精算。 律师圈先趟出来的路子,普通人处理合同、病历同样适用。知乎哔哩哔哩

什么人该现在就上车,什么人等一等
该动手的:本地文档十万级起步、被云端向量接口账单恶心过、或者想拿一句话搜自己照片/录音的,这周可以拿EmbeddingGemma 2开一个小库试水,128维先跑通流程,再回头做维度对比。
等一周的:生产环境在用RAGFlow、AnythingLLM这类现成管线的,社区集成(RAGFlow/Ollama类工具跟进官方支持)还没落地,硬接不划算,盯复测视频出来再说。
先别碰的:本地聊天模型刚装好、还没给派过活的——知识库救不了"装完只用",检索之前你先想清楚要查什么。
接下来值得盯的三个信号:独立第三方对这个模型的检索复测有没有出现;RAGFlow、AnythingLLM这些主流管线多久发第一版官方集成;以及手机侧量化版本的真机数据,会不会从"191MB"一个孤例变成一张分布表。
门票是免了,但从"装得下"到"查得准",中间还隔着切文档那一刀——这一刀,谷歌不替你先切。













