10月2日,B站UP主"AI观模者"发了条视频:《强推神项目Strata!12G显卡跑Qwen3.8FlashNext!速度93t/s》。18天,20万播放、8477个赞、1.84万收藏、2319条评论。你按"Strata 大模型"去搜,B站半年内已经攒出37条跟进视频——从部署教程、量化横评到洋垃圾实测,装机圈的注意力罕见地全砸在了一个开源推理项目上。哔哩哔哩
它击中的是一代DIY玩家的旧常识:跑本地大模型,显存容量即正义。为了这条常识,多少人去年被劝去买16G显存的4060Ti,或者咬牙上24G。现在一个项目告诉你:12G显存、32G内存,就能把通义千问Qwen3.8-Flash-Next这个1250亿参数的MoE模型跑起来,Windows、Linux都支持。老规矩还在不在?账该怎么算?先把机制三分钟讲透,再把三条路线的账摊开。
一、Strata干了什么:不是显卡变强了,是整台PC被当成推理设备用了
Qwen3.8-Flash-Next本来是给服务器用的,125B参数量,光模型文件就70多GB,12-24G显存的常规游戏卡按传统推理框架根本塞不下。但MoE架构有个特点:模型里有24,576个专家网络,每个token实际只激活其中10个。Strata(开发者Niko1221)就是围着这一点重排了分工:最常用的几千个专家放显存,剩下的放内存,CPU负责冷门专家,SSD存一张约28GB的查找表、用时只读需要的部分——显存、内存、CPU、SSD四路同时干活。另有一招"猜然后验证"的投机解码(MTP),小模型先猜后几个词、大模型批量校验,实测提速1.6到1.8倍;长文本分块读取单文档速度能超1000 token/s。知乎知乎
注意,这套东西不是"把模型扔硬盘上凑合跑"。评论区一篇高赞部署实录点出了一个容易被忽略的差异:llama.cpp时代"放内存和放硬盘没速度区别",不构成瓶颈;而Strata这版引擎数据放硬盘速度会明显掉,所以作者没这么干。SSD只承担查找表,真正决定流畅度的是内存容量和带宽。哔哩哔哩
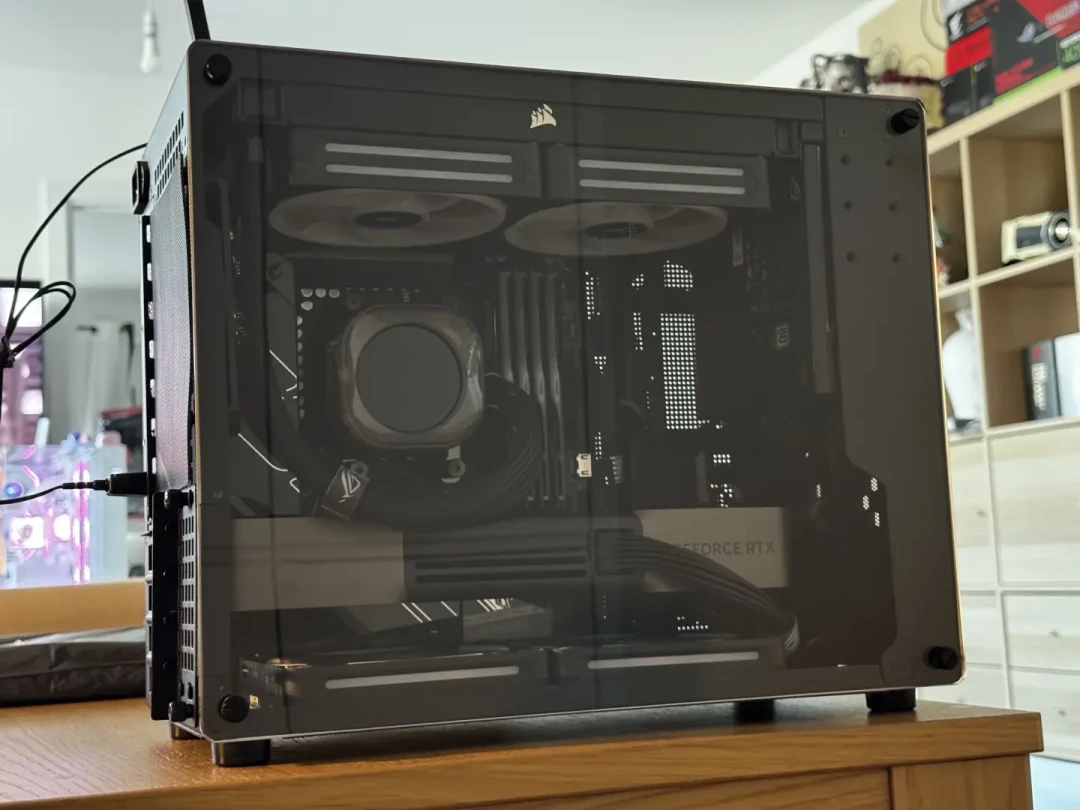
二、把散在各处的实测攒成一张表,规律自己会浮出来
单个UP主的数字都只是一台机器的口径。把近三周社区自测的样本放到一起(量化档位、上下文长度不同,只能当分布看,不能当承诺看):
机器 | 模型/量化 | 实测输出速度 |
|---|---|---|
5070Ti 16G + 48G DDR5 | Flash-Next IQ3_XXS,128K | 峰值120t/s、平均75t/s |
5070Ti + 48G | IQ2_XS,128K | 解码70~85t/s,实占43G内存+15G显存 |
双二手V100 32G(无NVLink) | 176B MoE IQ3_S,256K | 中位172t/s、峰值190t/s |
X99华南双路 + 双V100 16G(整机3879元) | IQ3_XXS,256K | 生成81.4t/s |
2080Ti 22G魔改 + 64G DDR4 | GSQ-RCO-IQ3_XXS,256K,开视觉 | 60+t/s |
双路Xeon 4210 + 128G + 2080Ti 11G | IQ2约35-40t/s,IQ3_XSS约30-35t/s | — |
8G显存机器 / 10G显存机器 | 网友回帖自测 | 约20~25t/s / 约30t/s |
三张脸孔一样的结论,从不同角度撞在一起:
显存从"门票"降级成了"油门"。 12G甚至8G都能跑,但8G卡20t/s和5070Ti 75t/s是两种体验——"能跑"和"爽用"之间隔着显存容量。
真正的硬门槛变成了内存。 知乎高赞回答给的起步口径是64G内存+16G显存。 Strata作者侧的提醒更直白:加载时往内存里放35到55GB数据,内存不够直接报"engine stopped unexpectedly"。评论区吵得最凶的也在这:普通玩法32G"又尴尬了",中文场景"至少48G"。知乎知乎哔哩哔哩
速度的天花板在带宽,不在核心数。 X99那套3879元的洋垃圾机器,作者自己标注瓶颈是"每路单通道内存24.65GB/s",升级8条REG ECC四通道后理论带宽翻3倍。同一批对比里,双V100 32G跑176B被UP主拿来和"四万多的RTX5090"对照,中位172t/s、峰值190.3t/s,靠的就是32G大显存+高带宽的组合。哔哩哔哩哔哩哔哩
三、麻烦就麻烦在:这套方案最看重的内存,恰恰是今年涨得最凶的硬件
老玩家应该都记得,64G DDR5内存在低价位时只有一千多块——今年10月的知乎回答还在拿这个数对比。而现在是什么行情:16G单条挂到1599,32G套条站上3000元档,内存一年涨到有人形容"像黄金一天一个价"。Strata把成本从显卡挪到内存,等于把预算党从显卡的坑里捞出来,直接扔进了内存的坑。爆款视频下点赞最高的理性发言说的就是这个别扭:卸载内存优化确实做得好,但你得顶着内存涨价去买内存条。知乎哔哩哔哩
翻官方文档整理出的档位表更能说明问题:内存32G时,12-16G显存基本只能跑代码专用版,24G显存开低内存模式才勉强够到低精度档;48G是Q2_0或IQ2_XS的起步线;64G官方才推荐主力档IQ2_XS,想上IQ3_S要把其他大程序关掉;96G以上才谈得上IQ3_S。内存容量决定你"能装下哪一档智商",这一步没有任何优化可以绕。小红书
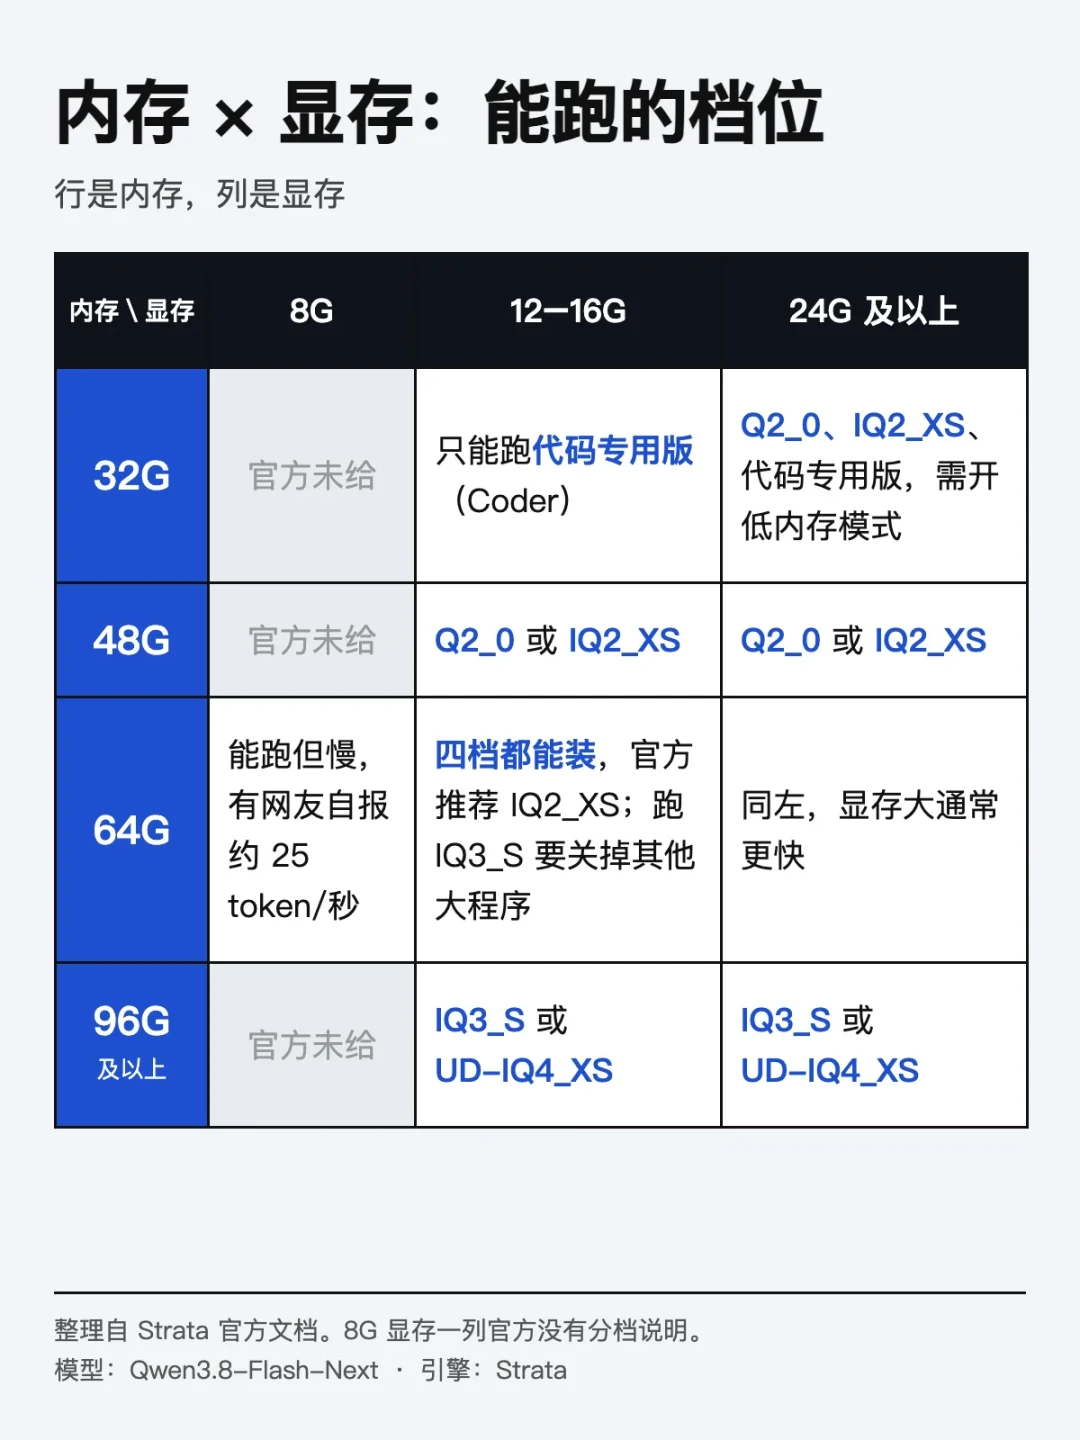
这才是这篇内容真正想让你算清楚的地方——2026年Q4组一台AI机,显卡已经不是最贵的变量,内存才是。于是社区自动分化出了三条路线。
四、三条路线,三本账
账本一:全新主流机——先想清楚"3万≈18年订阅"这回事。 "黑虾"给的全套顶配:9700X+B850+5070Ti 16G+双48G DDR5(留槽位以后扩192G)+PCIe5.0固态,整机接近3万。他自己算的这笔对账很扎心,结论也直接:只有超高频使用才可能比订阅划算。适合的人:隐私敏感场景、离线环境、拿本地模型当生产力后端高强度跑的开发者——Strata提供OpenAI兼容API,可以接进Cursor这类工具当本地推理后端。不适合的人:想"周末跑跑AI、晚上打3A"的——评论区实测,这套引擎会把内存显存几乎占满,“我都不想在b电脑上打开浏览器了怕爆内存”,正经解法是A电脑日常使用、B电脑专职挂模型。知乎知乎
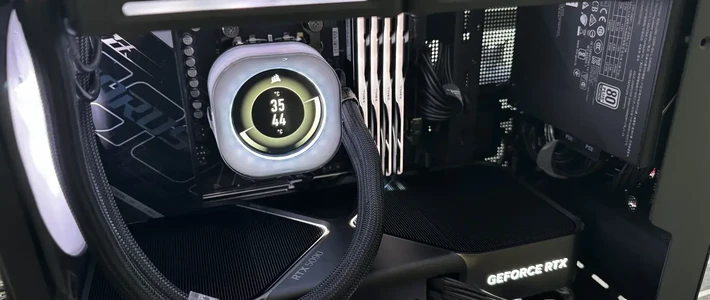
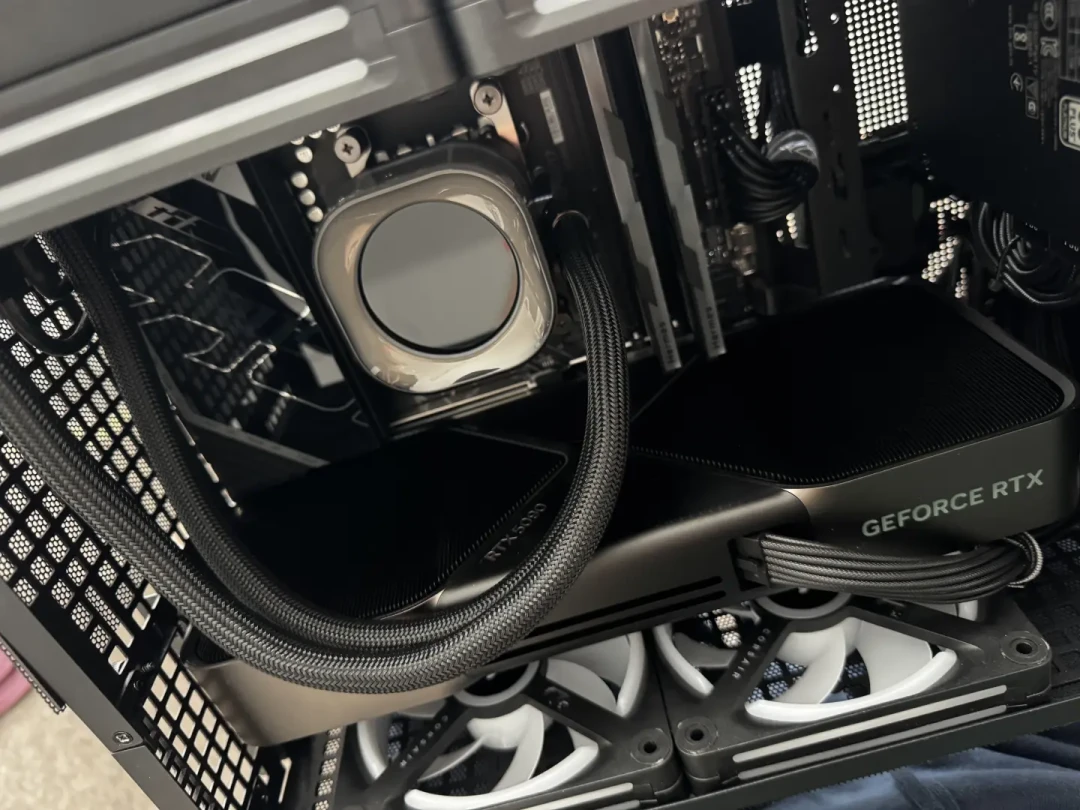
社区里"9950X3D+5090+192G"这一档的高端AI主机实拍,就是这条路线的完全体:
账本二:洋垃圾/魔改卡路线——省是真省,坑也是真坑。 X99华南双路+两张V100 16G含机实付3879元,能跑Flash-Next IQ3_XXS满256K、生成81.4t/s。往下还有一档:小红书有人晒出1400元出头捡的X99平台配P100计算卡,完整装机加Ubuntu部署Strata,实测平均30多token/s、峰值能到50。往上一个档位,2080Ti 22G魔改配64G DDR4,开视觉开MTP能跑60多tps。这条路的吸引力在于DDR4和服务器REG ECC内存没涨到DDR5那种离谱程度,绕开了最大的成本项。哔哩哔哩小红书
但请务必看完另一条视频:6月B站刷屏的《特斯拉V100显卡绝对不要买惊天骗局》,说的坑是真的——V100是被动散热服务器卡,装机要自己改水冷/风道(10月还有UP主专门给粉丝寄来的两张V100做水冷改装实测),Windows下驱动环境折腾、不支持显示输出,打游戏免谈。评论区也反复提醒"普通显卡和主板还是不要折腾双卡了,一般都是带宽瓶颈了,双卡就算是完全一样的收益很低"。垂直圈里"哪些魔改AI显卡值得购买"这类实测视频专门划了线:P40、170HX、4090魔改48G(单卡就要3万,恰好卡在全新机与洋垃圾之间)谁是真香谁是大坑,别只看显存容量,要看带宽、架构、CUDA代际和卡况。适合的人:本来就是图吧/洋垃圾老手、把这当第二个机器的;不适合的人:第一次组AI机、指望它兼做游戏主机的新手——后者入坑前先看那期"上当"视频。哔哩哔哩哔哩哔哩
账本三:不买,先用API——不是逃避,是校准。 评论区的自救标准很朴素——等你能用64G内存价格的token用量,把64G内存条本身赚回来,再谈升级。这话翻译成决策语言:先跑三个月真实工作流,统计你的月token消耗和对延迟的忍受度,再决定硬件档位。8G显存的旧机器花几百块加内存试试20t/s的体感,也是一种低成本摸底。哔哩哔哩
五、准备抄作业的,先把这几个坑背下来
量化档位不是越小越好。 评论区共识:Q2"掉智有点严重,能上Q3就上Q3";低精度量化、MoE模型开MTP都是容易陷入死循环的常见诱因,这是MoE相对稠密模型的天然劣势。各精度档位的权重体积(如176B模型IQ3_S量化也要82.8GB)直接对应上一条说的内存门槛:哔哩哔哩
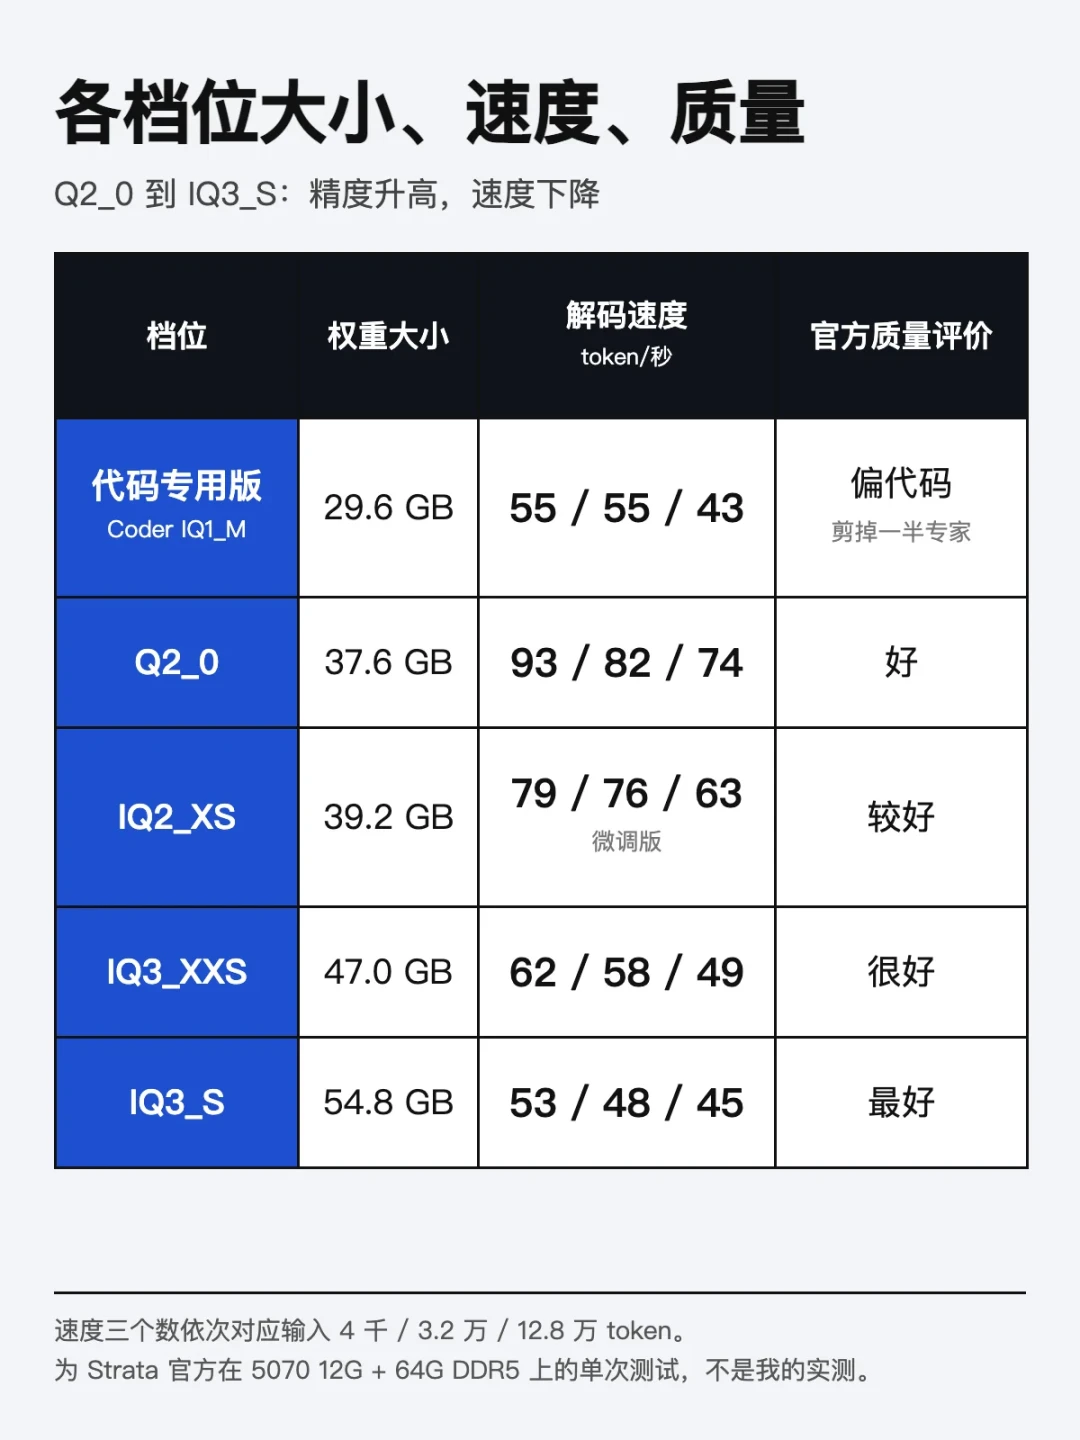
版本选择有讲究。 中文对话别选Coder特化版——去掉了一半专家,在中文和非CJK语言上表现较弱,要跑中文对话选保留全部专家的版本;社区实测swift1.5量化不如原版GSQ。知乎
首次启动卡1-3分钟、反复3-5次是正常的,那是引擎在往内存搬数据并自动寻优,别慌着拔电。
下载走国内源。 模型文件在ModelScope有镜像,实测下载速度11到14MB/s,70GB的模型不算煎熬。
A卡这边刚追上来。 Strata早期不覆盖AMD,现在已有0.1.45版本+ROCm10.1跑7900XTX的实测,但样本还少,别当成熟路线押注。
六、这条线接下来盯什么
Strata的版本节奏(现在还在高强度日更,0.1.4x阶段)和内存行情,是两道互相牵着走的曲线:项目每降低一档内存需求,涨价年里就多点性价比;反过来,如果DDR5价格真随产能松动回落,"账本一"的全新机成本模型会整个重算。装机圈这次罕见的热闹,本质上不是大家突然都要跑千亿模型,而是攒了多年的"为显存溢价买单"的怨气,终于有人用架构优化给解了扣。至于要不要跟进,标准就一条:先算你每月真实要多少token、忍得了多少t/s——把这两格填出来,三条账本里该选哪本,自己就浮出来了。