这两天,AI圈的"王座"有点挤。
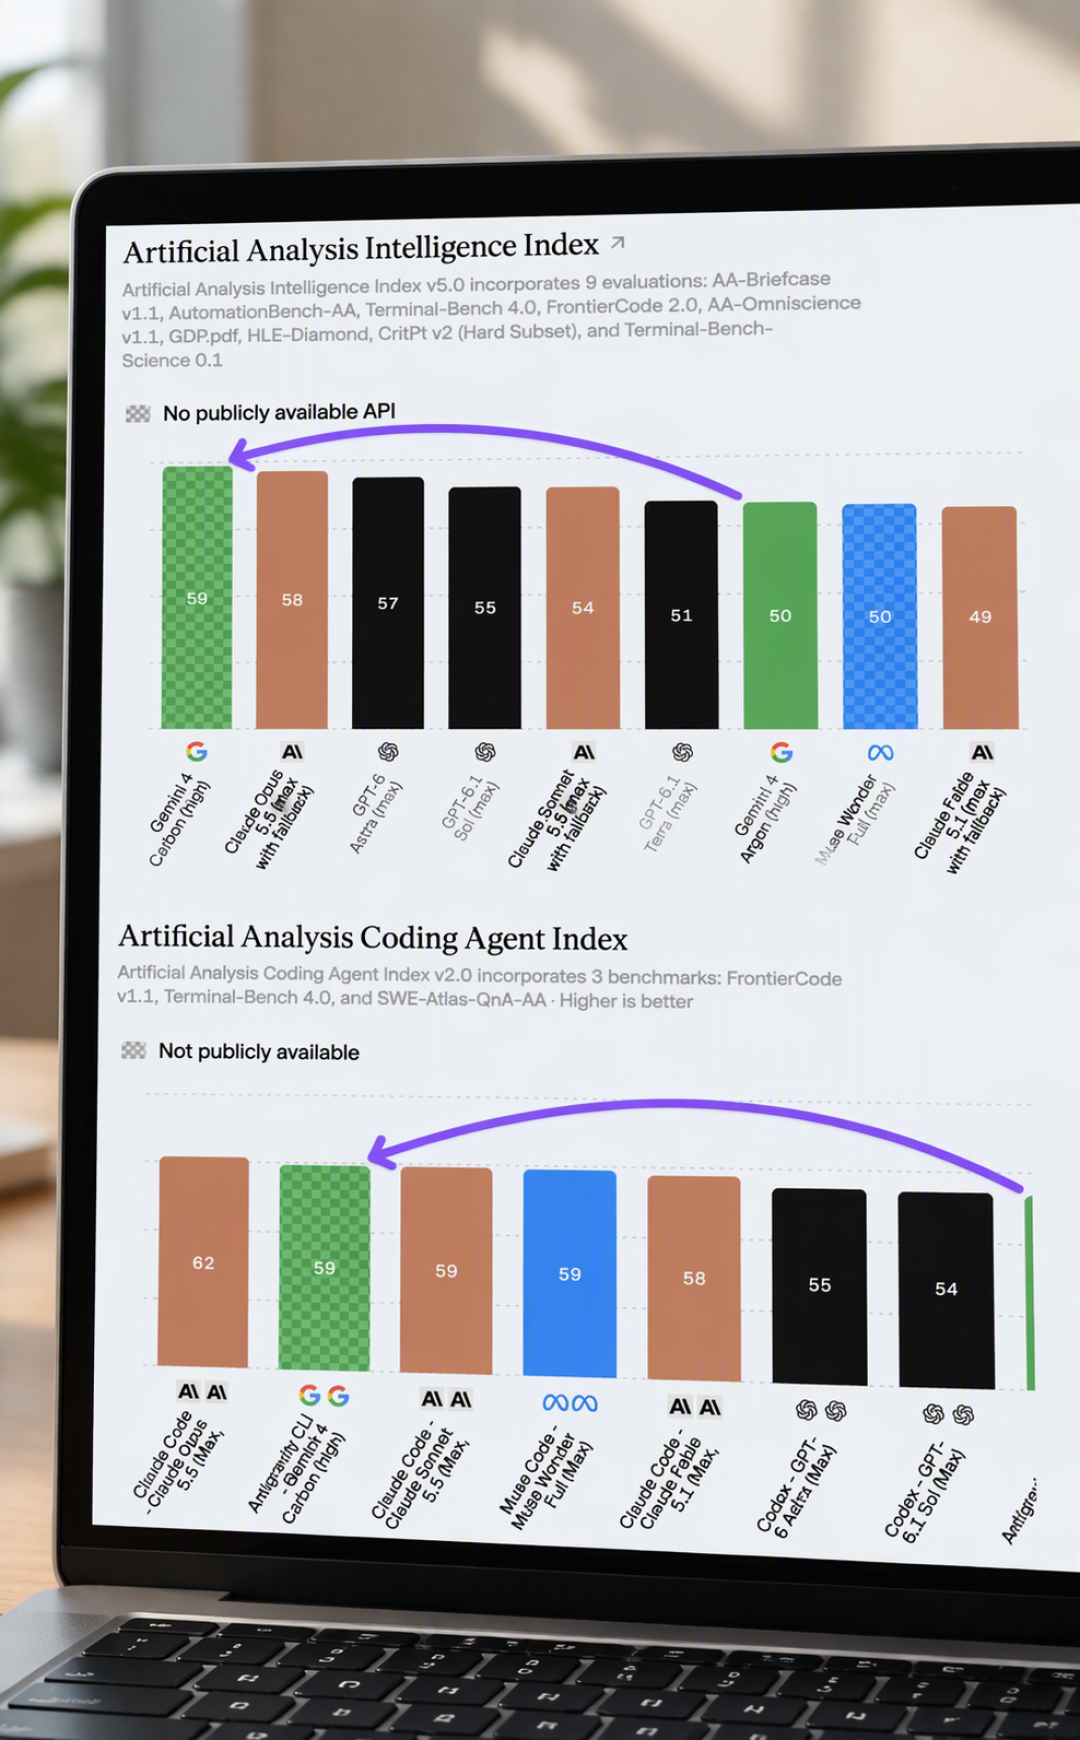
Claude Opus 5.5刚以58分登顶Artificial Analysis新版智能指数,把GPT-6 Astra(57分)挤到第二。香槟还没开,谷歌甩出Gemini 4 Carbon,59分直接夺魁——距离上一代Argon发布,才隔15天。一夜之间第一换了两次,分差只有1、2分。这场神仙打架,对攥着会员看热闹的你,有三个信号值得记下。微博微博机器之心36氪
信号一:这次的榜,终于不惯着"背书选手"了
智能指数v5版改了规则:私有数据集权重拉到60%,还新增代码与科研工作流这类地狱级挑战。题目没在网上出现过,模型没法靠背GitHub刷分,只能当场思考、当场解题。免疫学教授Unutmaz点评得很直白:以前开源模型对公开榜单"过度优化",现在和前沿模型的真实差距,总算看清了。36氪
所以这次的59、58、57,比以前更接近真实水平——也更接近彼此。三巨头基本打平,真没必要因为1分之差就换阵营。微博
信号二:真正的大瓜,不在榜上
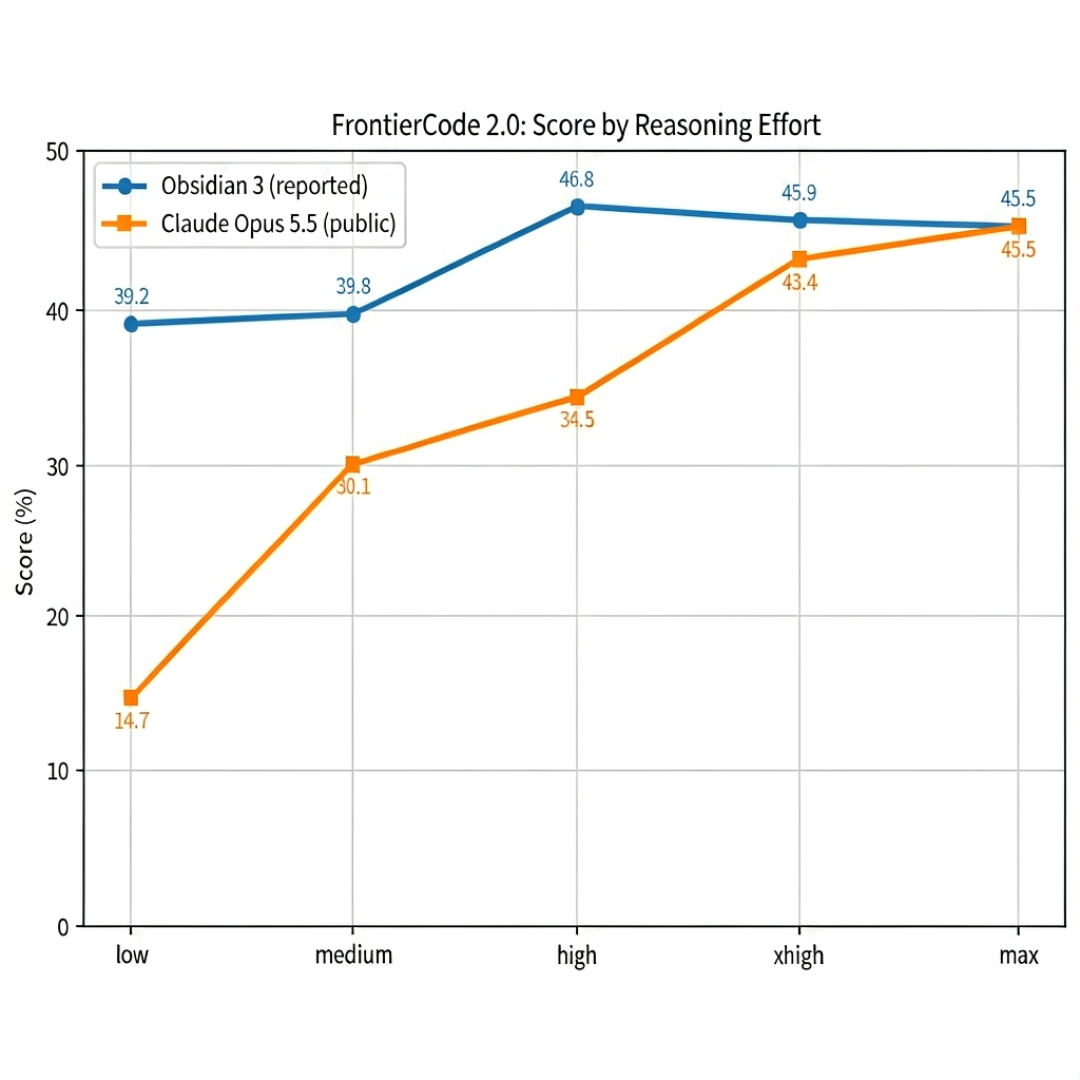
Cognition的私有编程基准FrontierCode 2.0出了个事故:有网友扒开官网数据接口,在data.json的隐藏代码里翻出一个神秘模型,代号Obsidian 3,高推理模式得分46.8%,压过了明面上的第一名Opus 5.5。36氪
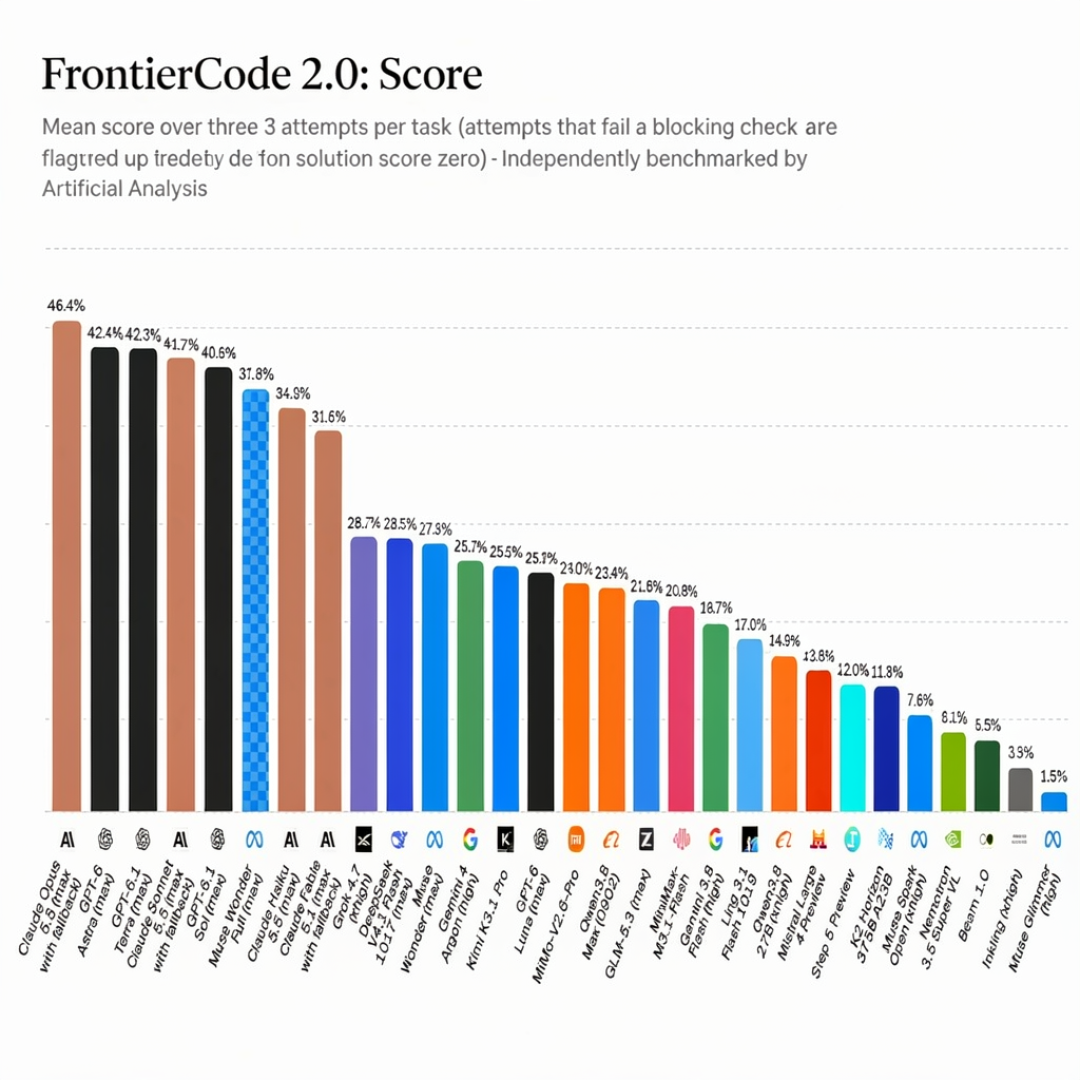
它的身份线索指向Anthropic还没官宣的Fable 5.5:跑在claude-code专属测试环境里,而全世界用这套框架的,只有6个Claude家族模型。36氪
但比分数更扎眼的是价格。据新智元报道,Obsidian 3的成本约为Opus 5.5的3.6倍,高推理模式单任务8.62美元,极端模式下飙到约47美元——跑一次,三百多块人民币。网友送它一个外号:“AI中的爱马仕”。36氪
而它只领先Opus 5.5约1.3个百分点,最大模式下两者甚至打平。还有开发者吐槽:让它思考得越多,表现反而越差,更像没调完的早期测试版,不太像最终成品。36氪
信号三:模型卷模型的,你的钱包按你的节奏来
前沿模型正在进入收益递减区:分数涨一点,价格翻几倍。落到日常使用,就三句话——
别追着第一跑。今天Carbon登顶,过几天Fable 5.5可能掀桌,OpenAI也不会干看着。追新是个无底洞,15天一代的节奏,谁都追不动。微博36氪
按任务挑模型。Carbon的强项是网络安全和长程任务,漏洞发现率做到88.2%。但在编程智能体榜上,Anthropic仍以62分领跑。中文表达这块,有用户实测Kimi K3.1 Pro反而比国际旗舰更懂中文。微博机器之心36氪微博
别拿大炮打蚊子。有开发者自嘲,用高价旗舰模型干了一堆简单任务,是"本周最愚蠢的事"。还有人30分钟烧光20美元额度。难题留给旗舰,杂活交给便宜模型,才是真效率。微博微博
榜单还会天天刷新,发布还会越来越快。但记住:模型没有不败的神话,只有永远在更新的账单。新神登基之前,先把手里那个用顺手的模型,用到值回票价。微博