"现在的攻防严重不对称了。"这条评论挂在一篇AI逆向实战帖下面,42个赞,没人反驳。
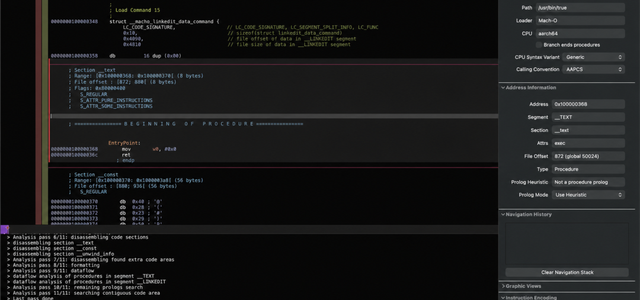
这话背后有个案例:帖子里有答主逆向了一个年流水几亿的手游,突破口是所有文件在固定位置的字节完全相同,由此倒推出循环XOR密钥,解开一看是个标准ZIP。放两年前,这种活是懂加密、熟文件格式的人熬几个通宵的量。知乎
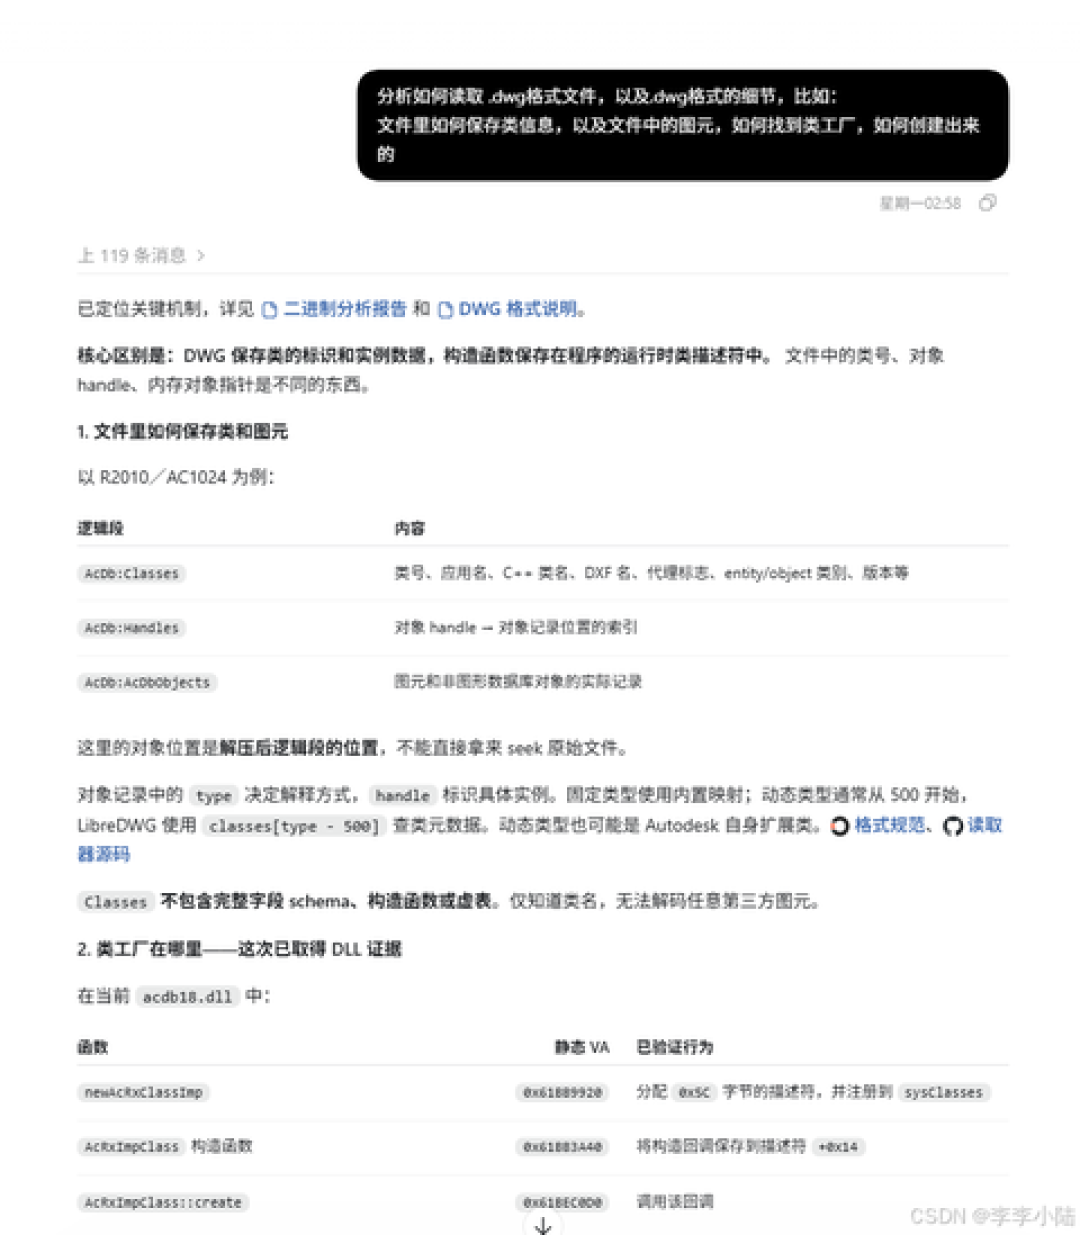
现在,人只需要在关键节点下判断。开源逆向项目REA一周星标破10万,说明门槛的松动是普遍感知。哔哩哔哩
被拆掉的是哪一块
把逆向这件事拆开看,大概是四段:定位、分析、验证、复现。
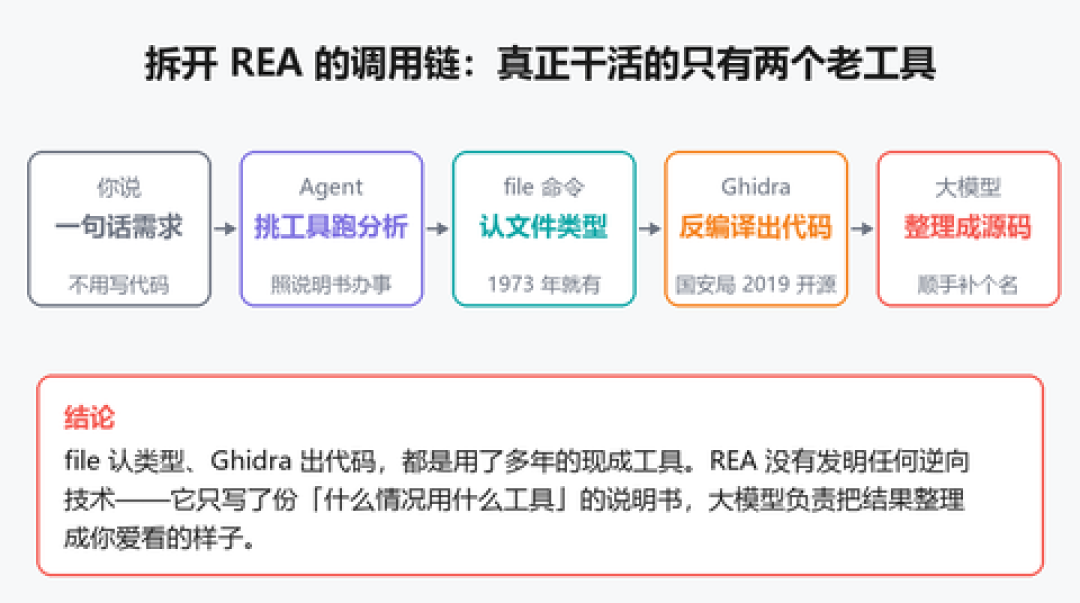
AI真正吃掉的是第二段。B站UP主"SI斗罗"发了期视频,标题很直白——《逆向已死:我当年没学逆向,现在AI替我证明了我是对的》。他当年放弃深钻逆向,赌的就是"靠熟悉工具、耐心和反复分析形成的门槛"会被自动化冲掉。现在模型能通过MCP直接调用Ghidra,他的位置也从"亲自操作"挪到了"提出要求、验收结果"。哔哩哔哩
工具熟练度、汇编阅读速度、熬时间的耐心,这些东西学起来贵,但AI能平价替代,它就便宜了——这就是被拆掉的"最便宜的那块"。
但门槛没消失,它搬家了
同一个人在视频里补了一句:门槛变了,不代表逆向工程师没价值。真正没被替代的是三样:判断、验证,还有流程之外的边界。哔哩哔哩
判断:AI能跑完分析流程,但"往哪看"由人决定。那个手游案例里,"固定位置字节相同"值不值得追,是人的判断——AI会给你十条线索,哪条是真的,它自己分不清。
验证:最容易被忽略的一条。另一个UP主让AI逆向一个2.9MB的DLL,AI交回1250行分析报告,他的做法不是照单全收,而是逐条拿字节去对。AI的报告有个致命特点:读起来头头是道,错得理直气壮。没验证能力的人拿到报告,等于把结论权交给了最会编的那个。还有一层更现实的限制:主流模型已开始拒绝这类请求。哔哩哔哩哔哩哔哩
边界:什么能逆、什么不能碰,模型拦截只是第一道,法律责任这条线仍然只对人画。
那还要不要学
分两种人。
想把逆向当职业的:学,但换个定位学。知乎那篇90多万播放的"过来人"长文,路线还是Ghidra、GDB、Fuzzing、Frida一路点下去。这套今天仍然值得走,原理不会骗你;要换的是定位:不是吃饭的手艺,是验证AI的地基。你得能看出反编译器给的伪代码哪里不可信(它本来就不是源码),认得出常见加密结构和文件格式,否则连AI报告对不对都判断不了。知乎
只想蹭热点"万物皆可逆向"的:真不用学。工具门槛趋近于零,讨论区里连"求提示词"都成了高频句。零门槛的事没有溢价。
开发者那边的焦虑,吵错了重点
开发者社区吵得更凶。有人的Demo刚上Steam就被人抄出一个劣化版抢先圈钱,"AI把逆向成本打到几百块"的说法随之传开;反对的声音也硬:你的游戏得先赚到大钱,才轮得到别人花token来逆。知乎
两边都有道理,但都漏了一件事:客户端从来不是真正的护城河,服务器才是。AI能拆开你发出去的每一个字节,拆不开你留在机房里的逻辑。
所以,"攻防不对称"说对了,但没说全:不对称的不是人和人,是旧门槛和新门槛之间的时间差。工具熟练度和耐心正在贬值,能判断、能验证、守得住边界的能力还没涨价——这段窗口期,才是真正想学逆向的人该抓紧的东西。