美团LongCat-2.5能接Claude Code,但先别换主力

源自165位全网作者

08:23

11月2日,美团干了一件“不像外卖公司”的事:发布LongCat-2.5正式版,一头扎进AI编程战场。

对写代码的人来说,最实惠的消息不是参数,而是这条:它的接口同时兼容OpenAI和Anthropic两种格式,Claude Code、Codex这些编程Agent,理论上改个地址和模型名就能接上。知乎

外卖公司这次卷的是“做完项目”

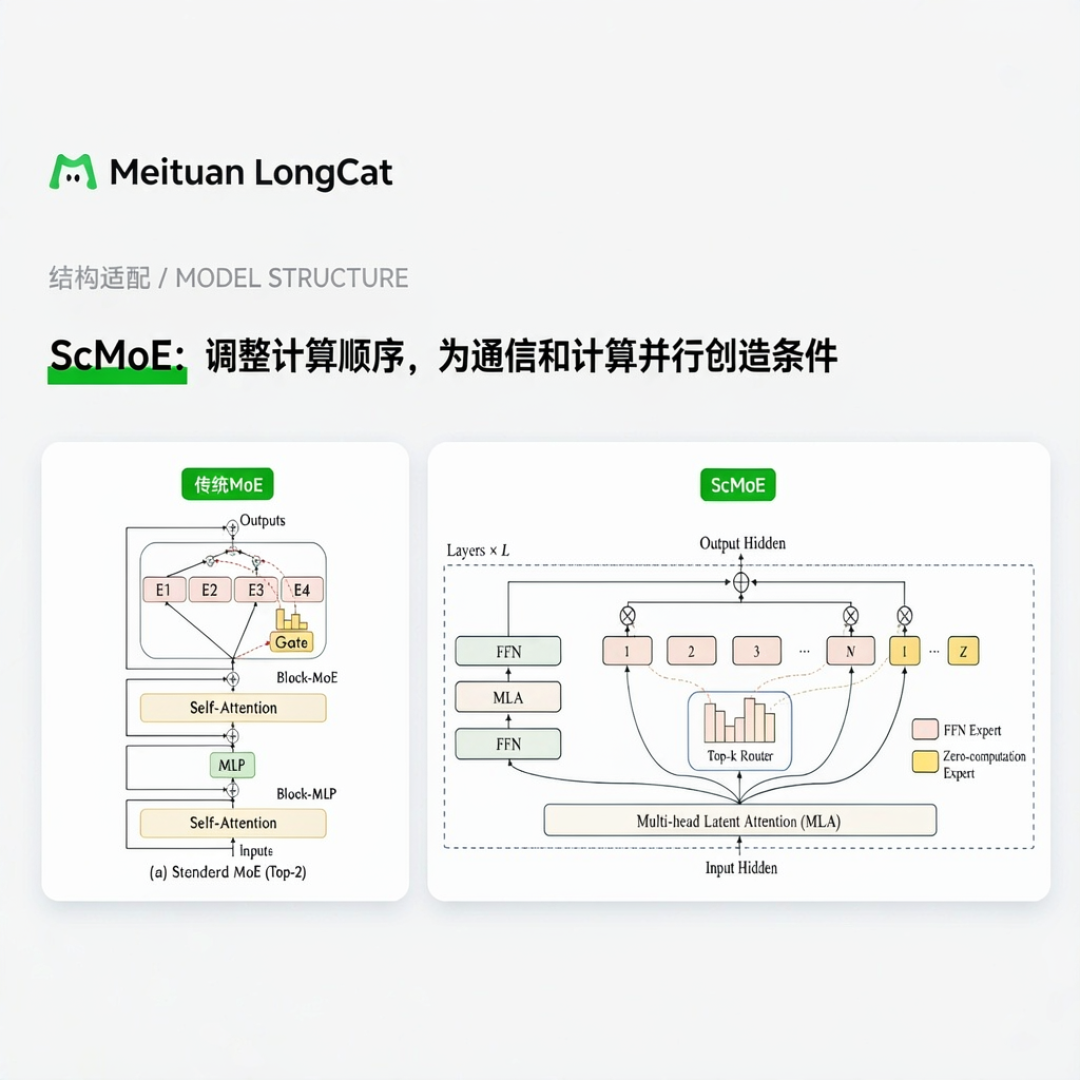
先看数字。总参数1.6万亿,MoE架构,每次只激活约480亿。打个比方:一家1.6万亿人的大公司,每个问题只叫最对口的一小队人干活,本事按全员算,成本按出勤算。再加上100万token上下文,一个中型项目的代码能一次全部塞进去慢慢读。微博知乎

参数规模其实和上一代2.0一样。美团这次改的不是身板,是考题:上一代比“会不会写对这段代码”,这一代比“能不能把整个项目从头做完”。

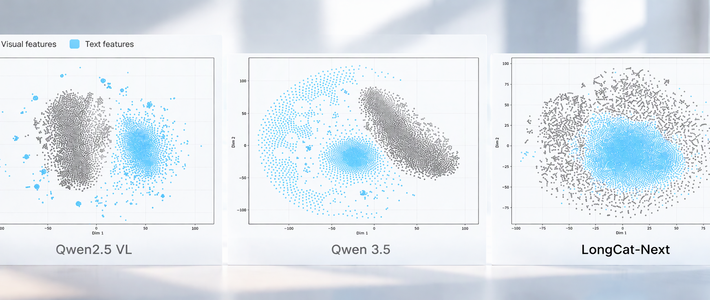
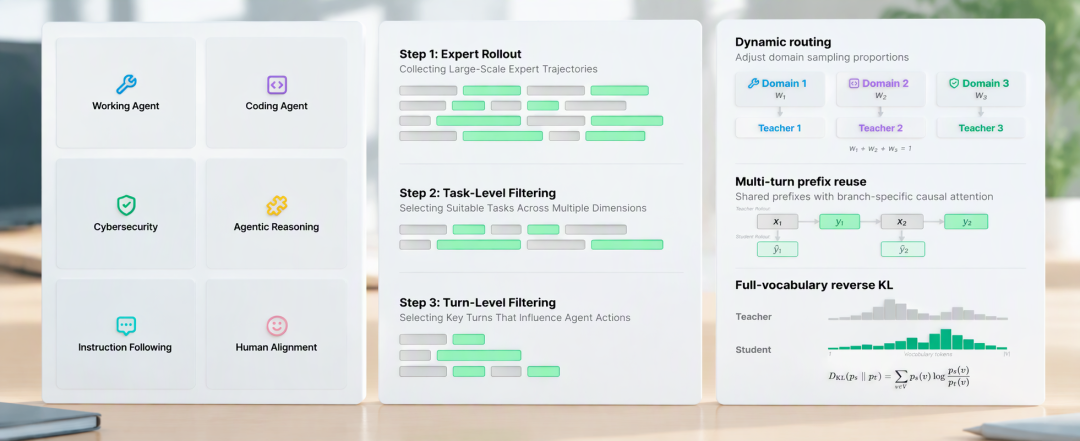
练法也挺狠:把真实GitHub项目里的改动和问题单做成练习题,验收标准是“原来跑不过的测试现在必须跑过”;AI自己干活时的失败记录,也被改造成能重演、能打分的题目,哪儿弱补哪儿。还有原生多模态——视觉信号被转成和文字一样的“字”一起学,看着截图就能写代码,还能直接生成可拖拽旋转的3D展示页面。知乎微博
美团LongCat-2.5能接Claude Code,但先别换主力

跑分要两面看:有赢的,也有输的

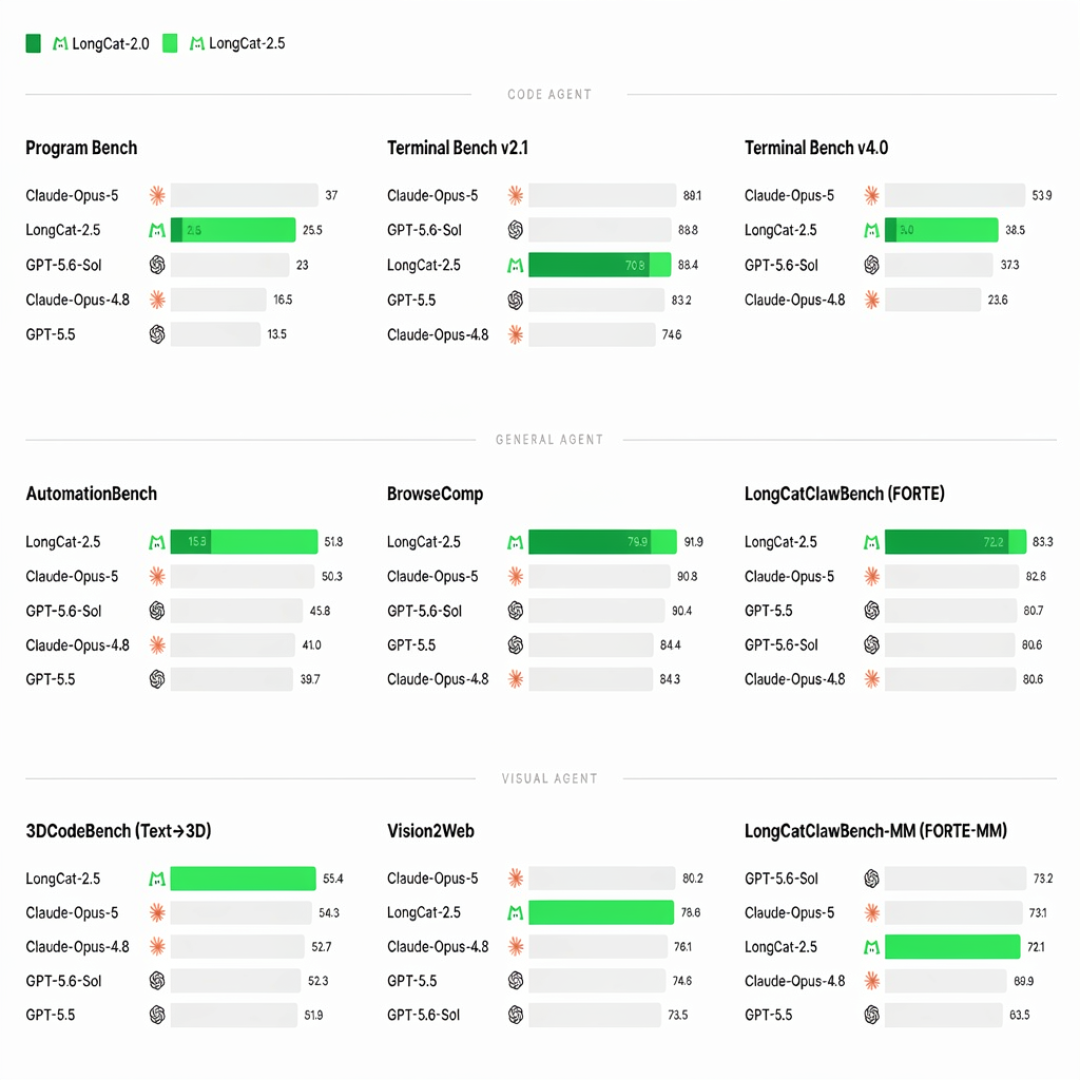
官方成绩单挺唬人:BrowseComp联网检索91.9分,比Claude Opus 5还略高;Terminal Bench v2.1从上代的70.8冲到88.4;DeepSWE端到端工程评测从9.7直接跳到64.6。知乎微博
美团LongCat-2.5能接Claude Code,但先别换主力

但别急着欢呼。最难的仓库级任务Terminal Bench v4.0,它拿38.5分,Claude Opus 5是53.9分——15分的差距,真实项目里的硬活还是有肉眼可见的短板。而且以上全是厂商自报的成绩,第三方复测还没影,听一半、留一半。眼尖的人还发现一个细节:对比表里拿来比的OpenAI模型是GPT 5.5和5.6 Sol,不是最新的6系。选对标这门手艺,大家都懂。知乎知乎微博

想尝鲜,姿势要对

网页端和API现在都开放了,可以直接上手玩。但有两个冷提醒:微博

一是这次没宣布开源权重。官方只说GitHub和Hugging Face“后续上线”;想本地部署的,目前只有上一代2.0(MIT协议)可用,2.5先走API这条路。知乎

二是它不一定快。预览期第三方实测里,三个任务单项耗时都超过30分钟。建议先拿一个非关键的长任务试水,记下耗时和返工次数——如果返工散落在各处,检查修补花的时间,可能把省下的写码时间全抵回去。知乎

最后说个容易被忽略的点:这个1.6万亿参数的模型,全程在国产算力上训练完成,按官方说法是目前国产算力上最大的一次训练任务。模型打架归打架,这条路被验证能走通,本身就值得记一笔。知乎微博
美团LongCat-2.5能接Claude Code,但先别换主力

先别急着换主力,但值得去试一把。这可能是当下对每个“国产之光”最务实的态度。

内容由AI生成

精选参考来源

1. 美团 LongCat-2.5 发布:1.6 万亿参数、每次只用 480 亿,目标从写代码改成做完项目

2. 11 月 2 日,美团龙猫在 LongCat API 平台上线 LongCat-2.5 正式版。模型总参数 1.6 万亿,单 token 激活约 480 亿参数,主打长程智能体任务。新版本重点强化原生视觉理解与智能体编程能力:视觉信号会编码为多层级离散 token,和文本一同送入主干网络;训练阶段引入长程轨迹数据与强化学习,适配复杂代码库研读、完整项目搭建这类多步任务。网页端体验与 API 现已开放,GitHub、Hugging Face 版本后续上线。LongCat-2.5-Preview 预览版已于 9 月推出,本次为正式版本发布。#美团LongCat-2.5正式版上线##原生多模态大模型##长程智能体任务#

3. 美团 LongCat-2.5,长任务先看跑完

4. 美团发了 LongCat-2.5,1.6T 总参数、激活约 48B 的原生多模态智能体模型,主打长任务和视觉编程,演示里能做可拖拽旋转的 3D 文物展示页。外卖公司卷大模型卷到这份上,你会拿它来写代码吗?#美团LongCat# #多模态大模型# #AI智能体#

5. 美团11月2号发了 LongCat 2.5,1.6万亿总参数,每个 token 激活大约480亿,官方说训练全程用的国产算力,推理也做到了国产卡上的 W4A4。自家给的对比表里,BrowseComp 91.9 比 Claude Opus 5 还高一点,但 Terminal Bench 4.0 是38.5,Opus 5 是53.9,差距不小。另外表里拿来比的 OpenAI 模型是 GPT 5.5 和 5.6 Sol,不是现在的 6 系。“国模国芯”这件事比分数本身更值得看。#美团LongCat#

6. 美团把国产大模型又推了一把:LongCat-2.5 上线了。官方博客(11月1日):总参数 1.6 万亿,每个 token 大约激活 480 亿;原生多模态,主打长任务智能体和视觉编程,还专门做了国产加速器上的训练和 W4A4 推理优化。对比自家 2.0,几个智能体基准跳得很狠——BrowseComp 79.9→91.9,PaperBench 45.2→82.1,AutomationBench 15.8→51.8。终端编程、网页视觉生成这些场景,官方给了端到端演示。这对中国年轻人意味着什么:大厂继续卷「能干活的智能体」,不只是聊天。会用、会拆任务、会盯结果的人,比只会问一句「帮我写」的人更吃香;国产栈和国产卡也在一起长。你会优先拿它写代码、做演示,还是先观望对标 Claude / GPT?#人工智能##大模型##美团##AI##科技#

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章