

一台 32GB 内存的 MacBook,装不下 121GB 的专家权重。
11 月 18 日,Hugging Face 工程师 Tarek Ziade 把一件听起来不可能的事做成了:Qwen3.8-Flash-Next,180B 参数,在他那台 32GB 统一内存的 MacBook M5 上跑到解码 13.9 token/s,只比专门吃这碗饭的推理引擎 Strata 慢 6%。知乎小红书
然后他自己补了一句让人愣住的话——还是太慢,不够日常写代码。知乎
32GB 内存,121GB 专家
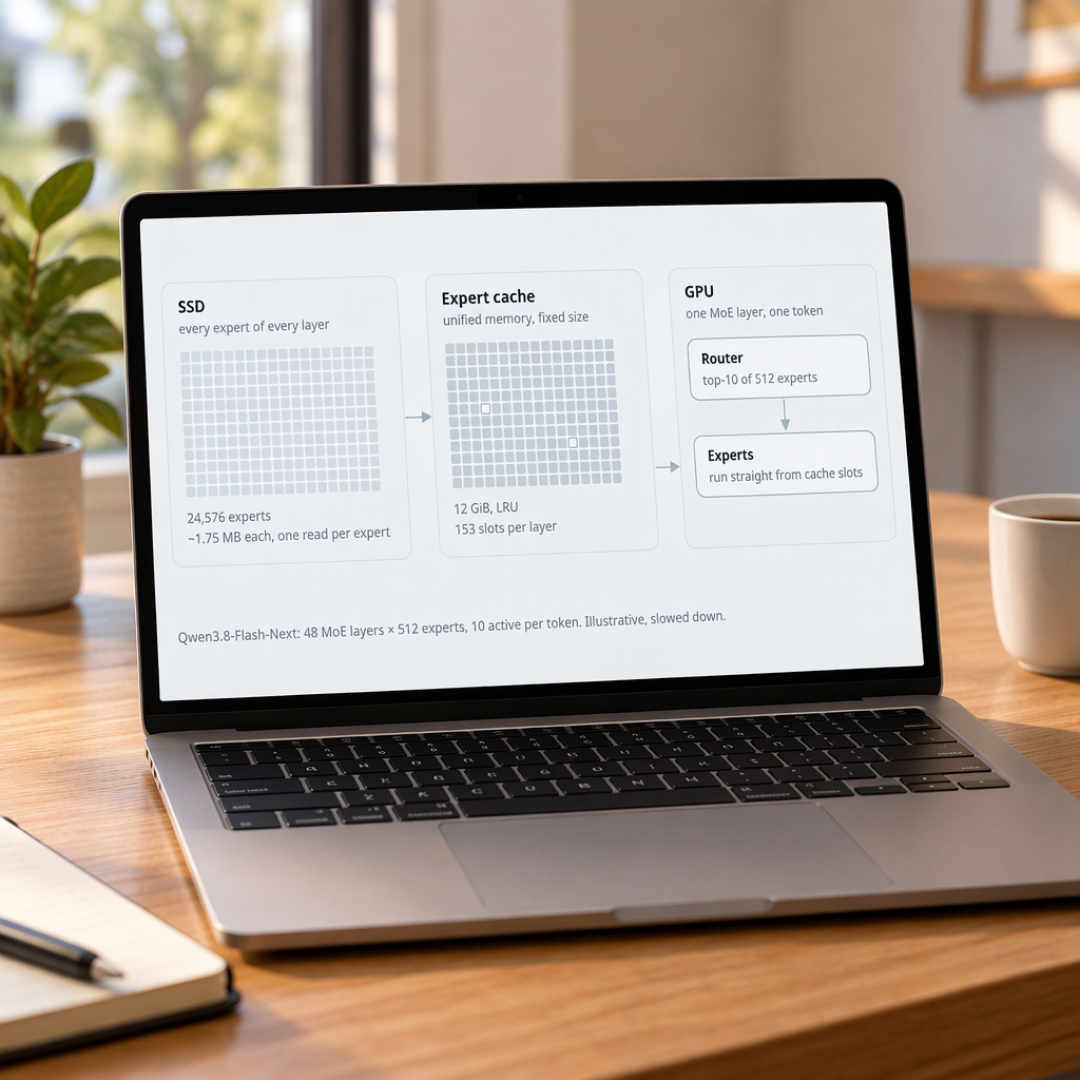
Qwen3.8-Flash-Next 是 48 层、每层 512 个专家的 MoE 模型,每个 token 只点亮其中 10 个。专家占整个模型权重的九成以上,FP8 下光这部分就 121GB。旁边还躺着一张 51GB 的 n-gram 嵌入表,它不能跟着专家一起流式读,得走自己的一条磁盘路径。小红书知乎
32GB 面对 121GB,整装没有可能。但反过来想:一个 token 只找 10 个专家,剩下 502 个那一刻根本不用在场。既然不用在场,凭什么让它们全挤进内存?
这就是"专家流式加载"——谁被路由器点名,谁才从 SSD 上来。小红书
想法不新,难的是让它快
作者先甩了个参照:同一块 24GB 的 A10G 跑 Qwen3.6-35B-A3B,Strata 用 Q8_0 能到 82–88 token/s,llama.cpp 63–64。而 Transformers 加 Accelerate 的老卸载只有 0.16,慢了两个数量级。知乎小红书
原因很直白——老办法一次卸载一整层专家库,为了用其中 8 到 10 个,把 512 个全拷一遍。
他的第一版也不好看:专家放磁盘,设备挂 LRU 缓存,Python 一个个算,缓存全命中也只有 10.1 token/s。卡的不是读盘,是循环——原生实现用 grouped_mm 把一层选中的专家塞进一个内核算完,循环把这个优势全吃掉了。知乎
转折叫"槽位池":预分配一块设备内存给所有层共用,每层配一张专家编号到槽位的映射表,路由选谁,谁的权重就搬进对应槽位。grouped_mm 看到的永远是一块形状规整的专家库,一行计算内核都不用改,小模型上立刻从 10.1 跳到 34.6,原生是 38.1。知乎
这套东西最后成了 from_pretrained 的一个选项,叫 experts_offload,进了 Transformers 的 50717 号 PR。小红书
五招磨掉那 1.5 倍
第一版对上 Strata 0.1.60:解码 10.0 对 14.8,4K 提示词预填充 68 对 220。知乎
然后是五招,每招都有数:强制每块提交 GPU 工作(PyTorch 在 MPS 上爱攒小内核,GPU 空转等 Python),快 10%;给 Gated DeltaNet、超连接这些没快速路径的部分手写 Metal 内核;换 Strata 的 GGUF 权重,稠密层每 token 流量从 5.4GB 降到 3.9GB;预填充换大分块、边算这层边读下层专家,68 涨到约 228;长文档只对索引器选中的块做注意力。
终局:解码 13.9 对 14.8,预填充 228 对 220 反超,6K 文档后解码 12.4 对 13.7。剩下那 6% 卡在每 token 约 10 毫秒的主机往返——GPU 干等 Python 排下一层的活。Strata 把一个 token 的活一次排完,PyTorch 今天不给这个控制权。知乎
跑得动,和够用是两件事
作者的判断很干脆:约 14 token/s,够写文章、够跑实验,不够日常用编码助手。家里那台双 4090 继续干重活,笔记本这条路先到这里。知乎
对照一个国内实测:有人在 32G 的 M6 Mac mini 上跑 Qwen3.8-27B(MLX 4bit),1K 上下文 9.1 token/s,32K 掉到 7.9,他自己换算过,生成 100 个字要等 11 秒。小红书
两台机器不同,不是严格对照,但方向够刺眼:180B 的 MoE 跑出 13.9,比 27B 稠密的 9.1 还快。参数量翻六倍多,速度反而占优,只因为它每次真的只算 10 个专家。
"参数越大越要堆硬件"这条直觉正在被改写。改写方式是:显存的权重下降,内存余量和 SSD 随机读的能力上升。B 站 UP 主司波图 11 月 19 日那期视频做的就是这件事——一张 16GB 显存的 RTX 5060 Ti,给同一台电脑分别插 32GB、64GB、96GB 内存,实测小显存跑大模型到底要多少内存兜底。哔哩哔哩
那期视频底下最高赞的评论只有一句:表面上门槛在显存,其实门槛在内存。哔哩哔哩
回到这篇实践本身:加载完占约 18GiB,6K 提示词峰值冲到 25.4GiB,32GB 的机器必须关掉浏览器,否则 macOS 一换页,速度就没法看了。想留余量,48GB 起才舒服。知乎
想上手,先知道三件事
一,这是还没合并的概念验证 PR,experts_offload 的写法仍在和 Transformers 维护者讨论,接口会变。小红书
二,自己转换权重要约 5 小时。作者把转好的放在 tarekziade/Qwen3.8-Flash-Next-expert-streaming,稠密权重、3bit 专家、n-gram 表三样齐全,直接下能省掉这一步。知乎
三,那个 6% 是跟 Strata 0.1.60 比的,而 Strata 这边也没停——0.2.16 版把 NVIDIA、AMD、Intel Arc 和 Mac 的引擎全换成自研,彻底甩掉 ggml 与 llama.cpp 的矩阵内核,双 RTX 4090 从 136 提到 201 token/s,涨了 48%。Mac 端这版主要修 M1 到 M4 的计算错误和 Metal 内存增长。别把 6% 当终局,两边都还在跑。小红书
还有一件事值得自己算:长期把 SSD 当模型仓库,写入量不是小数,有作者专门写过分层部署架构的硬盘寿命隐忧。给出的寿命数字没有官方验证,但打算 7×24 挂着的人,先看一眼那块盘的 TBW 不亏。知乎
最后一个细节。这个项目全部代码都是 AI 写的,作者说自己只负责三件事:决定试什么、读性能画像、决定留什么。一个不写推理引擎的人,用一个通用库把 180B 塞进笔记本,还追到只差 6%。本地部署的入场券,可能比我们以为的便宜。

当前文章无评论,是时候发表评论了