

在Mac终端敲一行`fm`,就能弹出聊天窗口,跟苹果自己的端侧模型对话——不装软件、不要API Key、不花一分钱。X上有人把这个彩蛋捅出去,一夜之间八十多万人围观。知乎
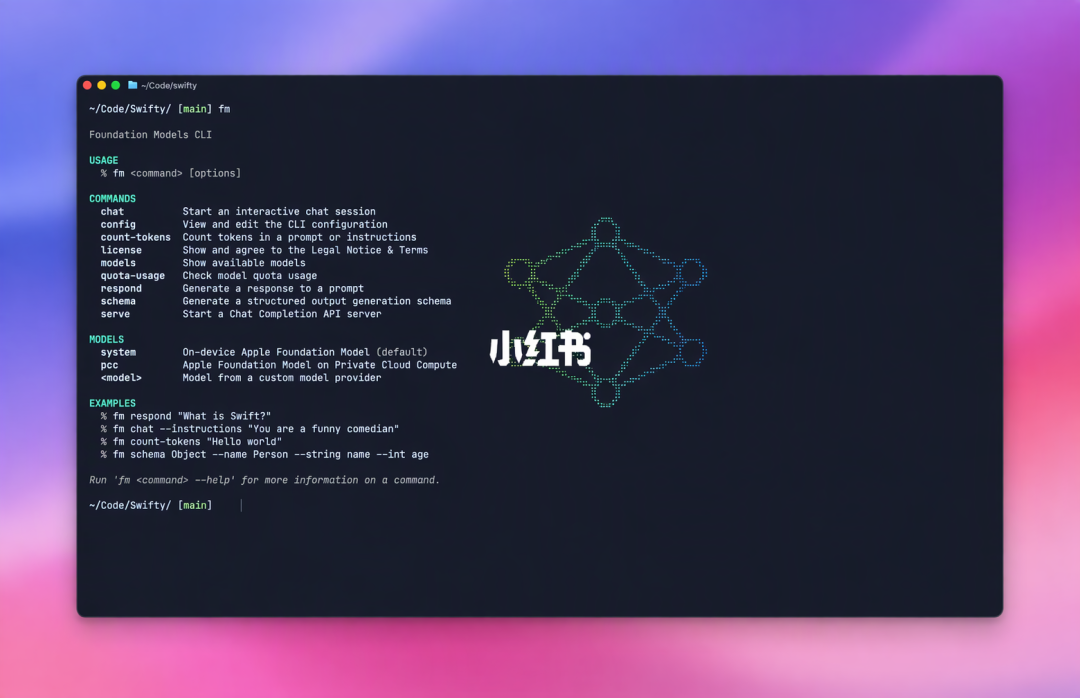
国行用户随后集体碰壁:机器直接报`deviceNotEligible`。门开着,接口齐全,里面的东西不给用——苹果看的是机器在哪卖的,不是账号在哪;国行Apple Intelligence预计还要等12月的正式版,`fm`届时能否解禁仍是问号。知乎
但这一下确实捅中了数码折腾党的蜜罐:本地跑大模型,正在悄悄接管NAS的宝座。不过先别急着装机,把三个问题想明白。
问题一:你的机器跑不跑得动?
看显存。量化之后,9B模型占5-6GB,27B模型占18GB上下,16GB显存舒服跑9B,24GB显存才是27B的真正门槛。知乎
不想花钱?这两年MoE模型对垃圾佬很友好,一张3060 12GB配64GB内存,就能把35B MoE跑到每秒14个token左右。知乎
Mac路线现在也比过去能打,最新一代M5芯片上输出速度大幅提升,统一内存架构和巨大的内存带宽都是优势。但内置的`fm`天花板只是3B小模型,上下文最多8192个token,别问它"最新macOS是几",它会一本正经地编。知乎知乎知乎
问题二:经济账算不算得过来?
知乎评论区早就吵透了:需求不明时,本地部署就是消费力以内的玩具;只想拿AI聊天的朋友,把电价+折旧摊进去怎么算,也多半不如直接付费API。知乎知乎
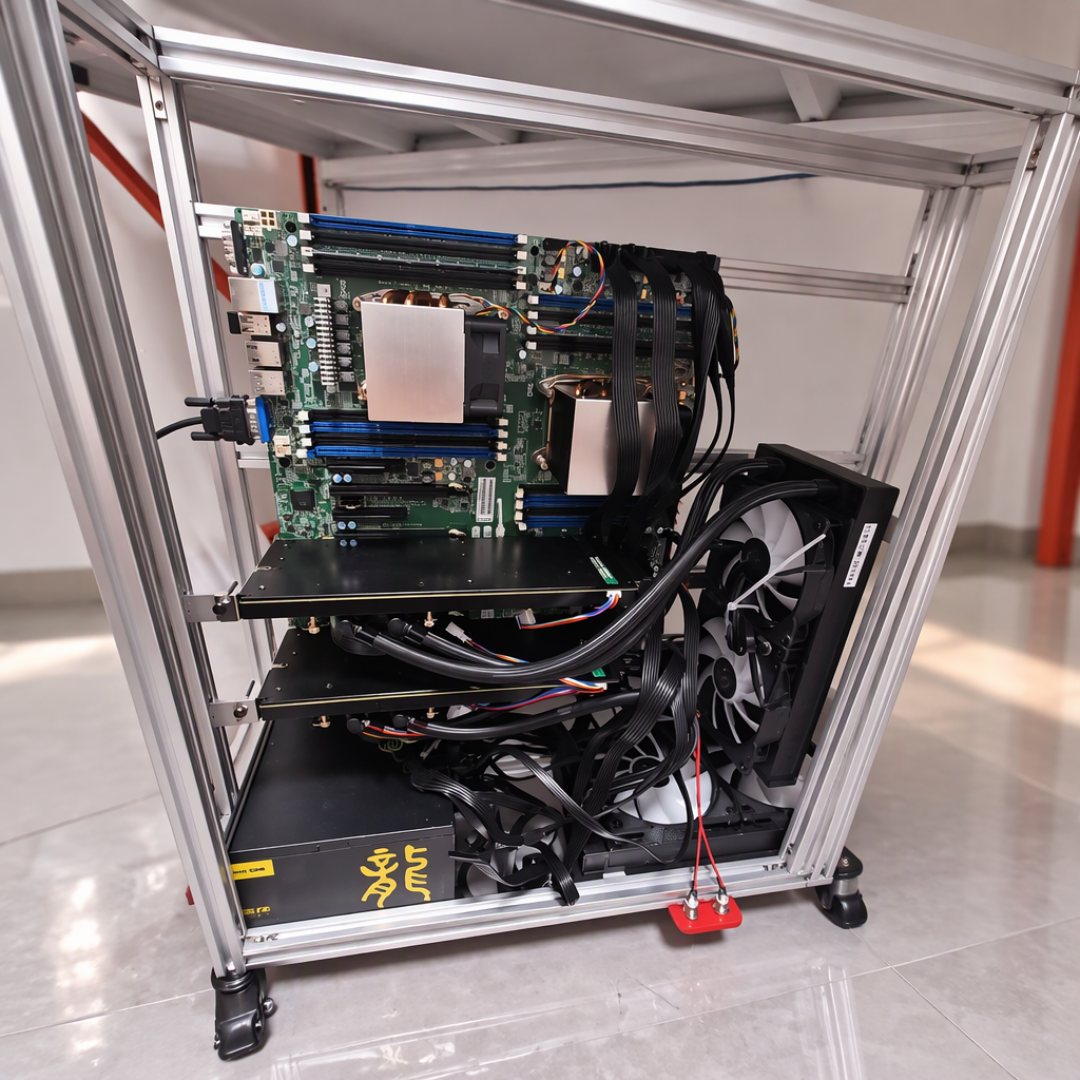
更扎心的是过来人的故事:领导花三万多配的AI主机,如今已经扔给孙子打瓦。想让这台机器值得配,只有一个条件:产出得有回报,真的有生产力需求,买5090也不过分。知乎知乎
问题三:什么场景真能打?
真正能打的往往不是聊天。有人实测:一部电影跑语音识别加字幕翻译,5秒一条,几千条的正常电影也就一会儿。苹果WWDC官方演示过同类活——堆满"终稿、终稿2、最终版改"的文件夹,小模型分清哪些是终稿、哪些是草稿,再交给脚本归档。加上不想上传云端的隐私文件,天然适合本地处理。它们的共同点是:任务固定、短小,云端要么不方便、要么不能上传。知乎知乎
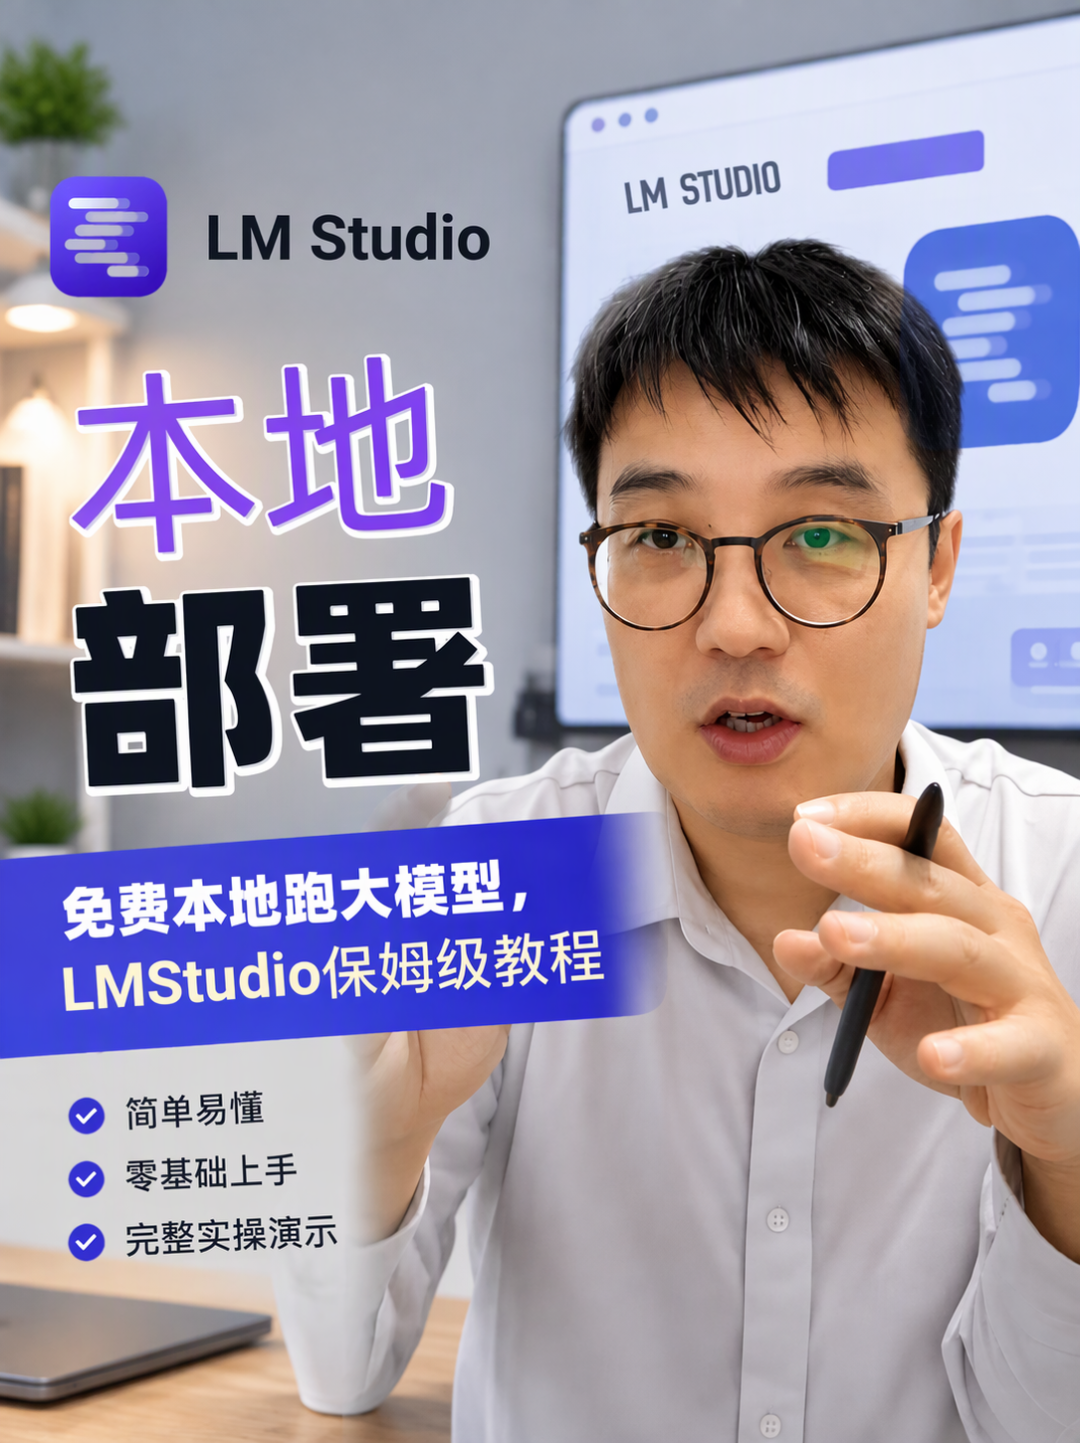
所以折腾党的正确姿势是:先白嫖,再装机。有Mac的先把`fm`玩明白;没有的装个Ollama或LM Studio,16GB内存就能从0.8B、9B小模型跑通整条工具链。等玩具玩出真需求了,再考虑掏5090的钱——到那时,你已经躲过了绝大多数坑。知乎
当前文章无评论,是时候发表评论了